#Transformer
共 17 篇相关文章

跨市场元学习:MetaGrid如何提升电价预测精度
MetaGrid通过跨市场元学习和拓扑感知Transformer,在五个美国ISO的电价预测基准上实现最低MAE,比最佳基线提升3.1%,比从头训练提升7.7%。

RoPE衰减曲线是噪声:取绝对值也无法修复
RoPE注意力衰减曲线其实是采样噪声,取绝对值也无法修复。本文解析旋转位置编码的相对性证明、相位退相干本质、LCG种子相关bug,以及NTK缩放为何无法作用于最快频率对,附226条验证断言与实测数据。

联邦学习+时序Transformer:车载CAN总线异常检测新框架
一篇arXiv新论文提出面向车载CAN总线的异常检测框架,结合时序Transformer编码器与联邦轻量级检测头,在保护数据隐私的同时实现高效、稳健的异常识别,为智能网联汽车网络安全提供新思路。

Softmax注意力如何学会决策阈值:一项理论动力学研究
解析arXiv最新研究:双参数softmax注意力模型如何通过梯度预训练学习决策阈值。文章深入剖析误差分解、协调参数发散机制及单头模型局限,为理解Transformer注意力的学习动力学提供理论视角。

AttSVD:用注意力引导的SVD压缩KV缓存,内存砍半不掉点
AttSVD提出基于注意力引导SVD的KV缓存低秩压缩方法,无需训练,沿特征轴压缩而非删除token,在LongBench等基准上仅用50%显存即可保持与完整缓存相当的精度,为长上下文大模型推理提供新思路。
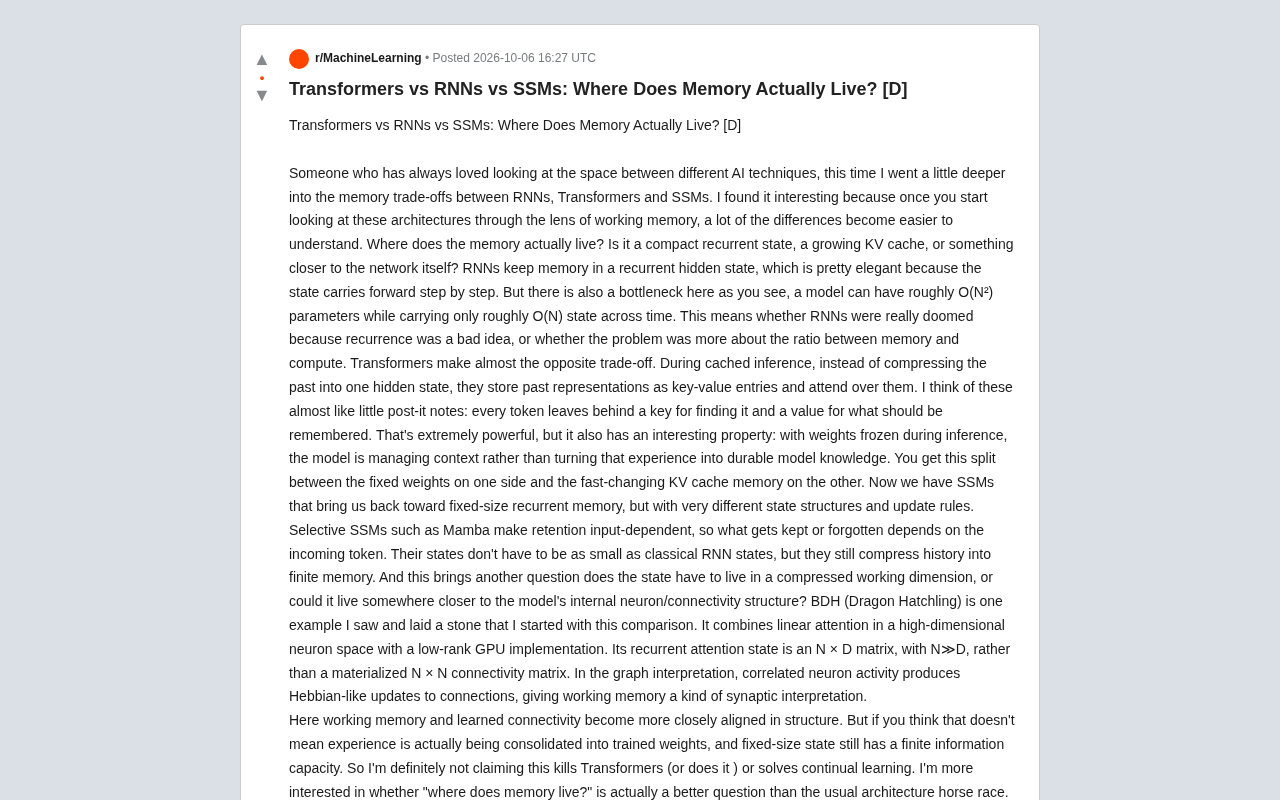
Transformer、RNN、SSM:AI模型的记忆到底藏在哪里?
从「记忆住在哪里」这一全新视角,对比RNN的循环隐藏状态、Transformer的KV缓存与SSM/Mamba的选择性状态,并探讨BDH等以网络为中心的架构,剖析AI模型记忆与计算的根本权衡。

Yandex Sona:单个Transformer取代15+推荐组件的工程实践
Yandex Music推出Sona,用单个Transformer取代15+候选生成器、预排序与排序模型。A/B测试显示活跃用户+4.53%、收听时长+6.30%,并通过History Compression将长序列推理成本减半。

TurboGPT:13秒训练22KiB微型Transformer的极简实验
TurboGPT 是 Hacker News 上一个极简 AI 项目,宣称能在 13 秒内训练出仅 22KiB 大小的 Transformer 模型。本文解析其在教学、可复现性和端侧 AI 探索中的价值与局限。
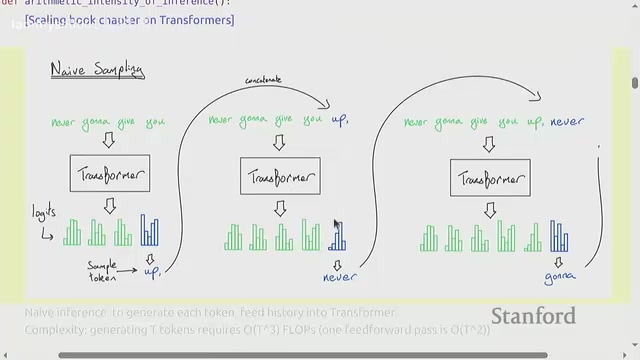
深入理解大模型推理:为什么生成如此之慢,又该如何加速
深入解析大语言模型推理为何内存受限、生成为何缓慢,系统梳理 KV 缓存、GQA、MLA、状态空间模型、扩散模型、量化剪枝与投机解码等推理加速技术,基于斯坦福大模型课程推理讲座。
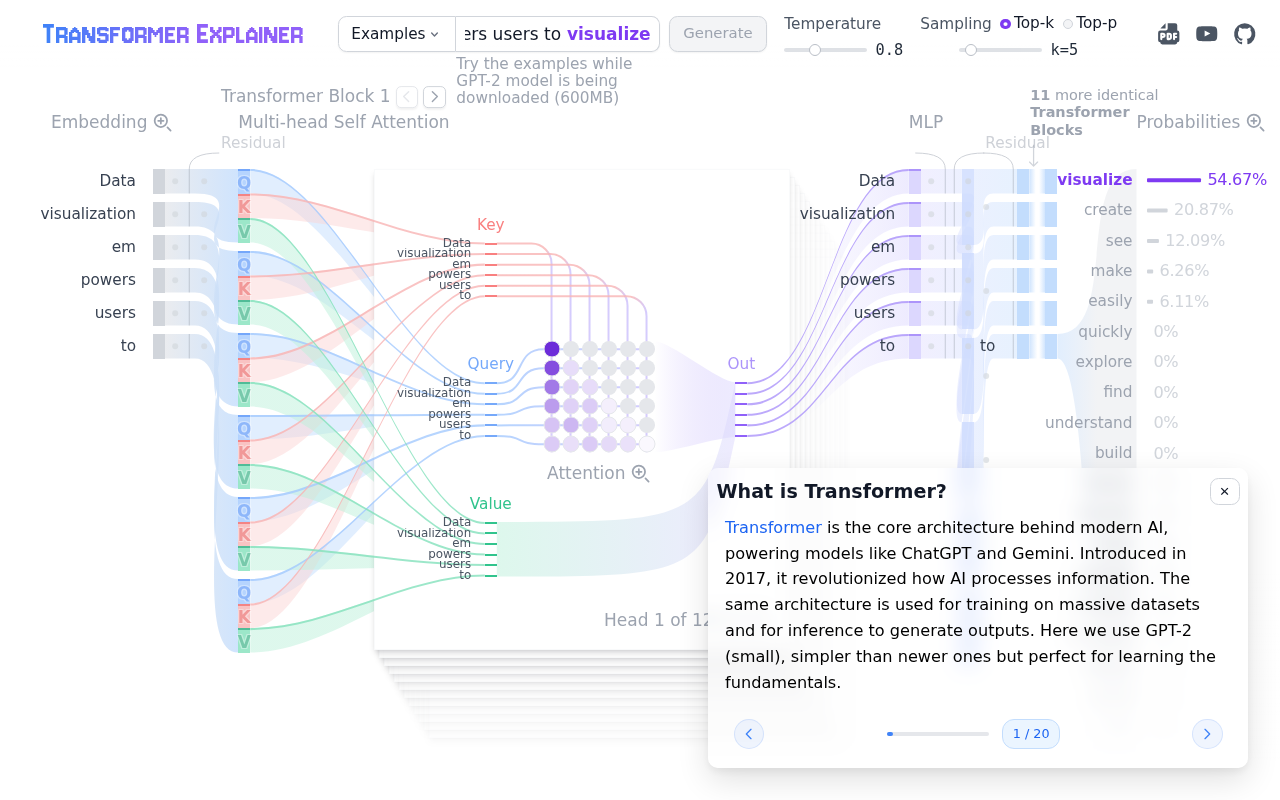
可视化理解Transformer:拆解大模型背后的核心架构
用可视化方式拆解Transformer架构,深入浅出讲解自注意力机制、多头注意力、位置编码与编码器-解码器结构,帮助AI学习者建立对大模型底层原理的直观理解。
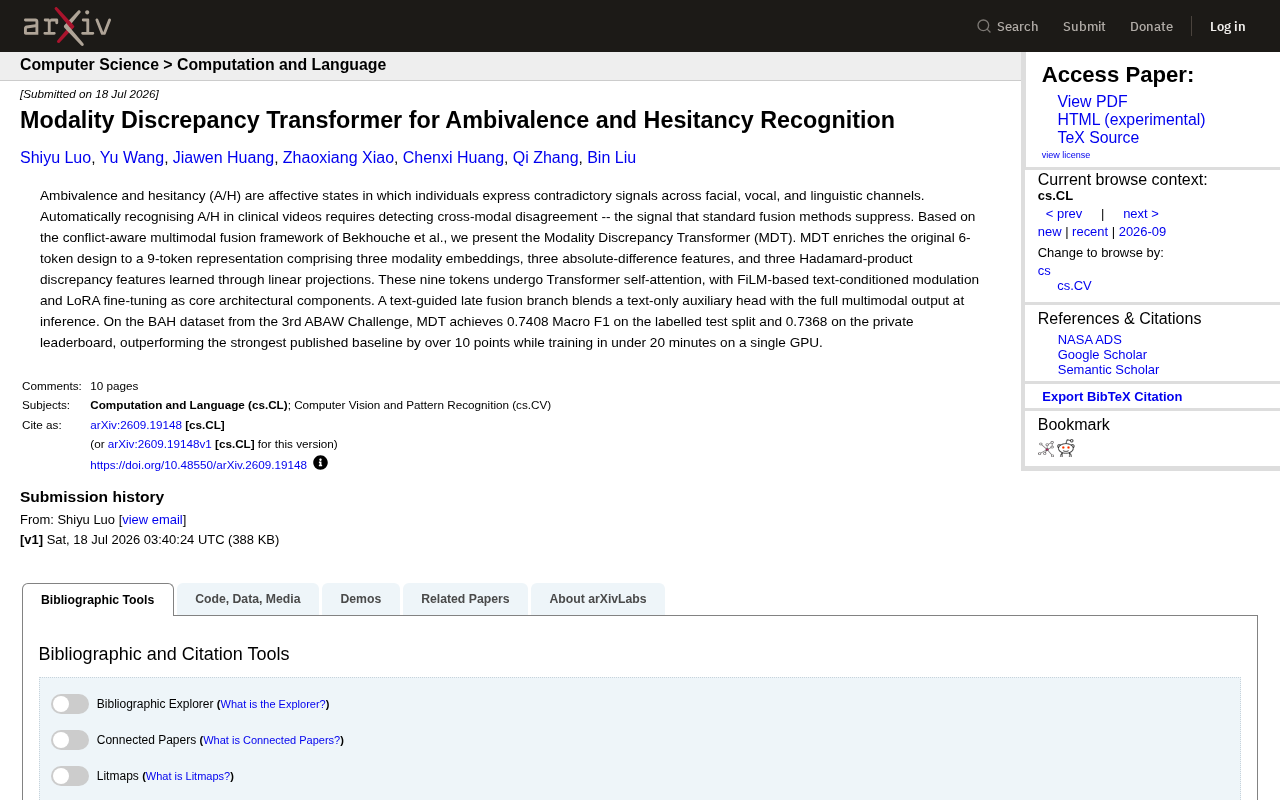
MDT模型:用跨模态冲突识别矛盾与犹豫情绪
MDT(Modality Discrepancy Transformer)通过显式建模面部、语音、语言的跨模态冲突,实现矛盾与犹豫情绪的自动识别。在BAH数据集上取得0.7408 Macro F1,领先最强基线10分以上,单GPU训练不到20分钟。
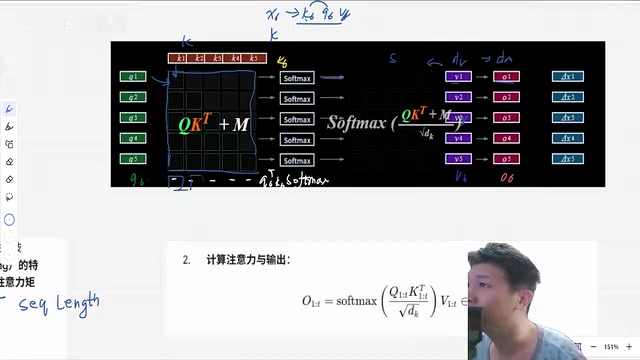
深入理解 KV Cache:大模型推理的空间换时间优化
深入解析大模型推理中的 KV Cache 技术:从无缓存的重复计算问题出发,讲清键值缓存的实现原理、新词计算流程、时间复杂度对比以及显存开销估算公式,帮助理解 Transformer 推理的性能优化。
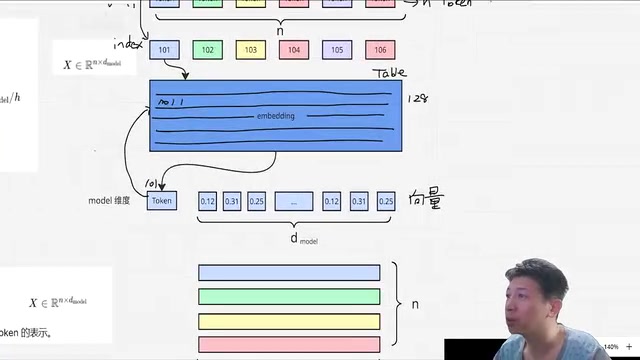
Transformer注意力机制详解:从Token到自注意力全流程
深入解析 Transformer 注意力机制,从 Tokenizer 分词、Embedding 向量化到 Q/K/V 自注意力计算、Mask 掩码与 Softmax 全流程拆解,重点追踪每一步的矩阵维度变化,帮助理解大模型与 AI Agent 长文本处理的底层原理。
解读Transformer电路的数学框架:机制可解释性的奠基之作
深入解读Anthropic的《A Mathematical Framework for Transformer Circuits》,介绍QK/OV电路、残差流与归纳头等核心概念,理解Transformer机制可解释性的奠基性研究。
 深度解读
Transformer本质解析:一个被拆解的文字接龙函数
用文字接龙的视角理解Transformer本质。将复杂的语言生成任务拆解为Embedding、Transformer Block、概率输出三大模块,帮助深度学习初学者快速建立直觉。
 深度解读
大模型设计的"差就好"哲学:简单粗暴为何胜过精致复杂
解析大模型架构设计中的"差就好"哲学:为什么DeepSeek V4弃用N-gram?为什么Transformer统治AI领域?从硬件对齐、快速迭代、统一架构三条铁律,揭示简单高效的模型设计为何总能胜过精致复杂的方案。
 深度解读
Transformer架构核心原理:自注意力机制与工程优化深度解析
深度解析Transformer架构核心原理,涵盖自注意力机制QKV本质、Encoder-Decoder结构、Flash Attention显存优化、RoPE位置编码、GQA推理加速等工程落地方案,助你从面试到实战全面掌握大模型底层架构。