AI写了3000行代码,却没人读:代码审查的瓶颈危机

AI编码智能体提升代码生成速度,但审查瓶颈使增量难转化为交付价值。
文章通过一则讽刺短剧和哈佛工作论文数据,揭示AI编码智能体带来的核心矛盾:代码量增30%、PR增23%,但已完成特性和修复bug数量无显著变化,PR合并等待时间延长49%、修改意见翻倍。审查环节成为整条流水线的最窄关口,原因在于量的冲击和质的退化——巨型PR导致审查者放弃阅读,AI审查工具沦为橡皮图章。短剧中40行小PR因包含测试证据而快速通过,对比3000行大PR被搁置,说明审查质量与PR规模存在非线性关系。文章提出控制PR规模、要求测试证据、让作者解释代码、AI审查定位为辅助等实践原则,强调生成不是瓶颈,阅读才是。
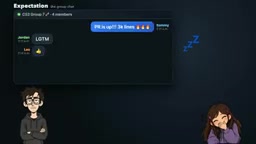
一段来自YouTube的讽刺短剧,最近在开发者圈子里流传。故事很简单:一个学生用一句提示词让AI生成了3000行代码,完成了小组项目。团队在凌晨2点提交了Pull Request,4秒后就被队友Jordan批准——平均每秒750行。直到助教要求每个人在演示时解释自己的代码,问题才真正暴露:三个登录系统、无法防止重复预订的房间预订逻辑,以及一个被AI审查工具盖章“通过”的自身bug。
这个短剧的虚构情节,恰好对应着一篇被广泛讨论的哈佛工作论文。据剧中引述,该研究覆盖约700家公司和70万名开发者,发现引入编码智能体后,代码量增加了30%,Pull Request数量增加了23%,但已完成的特性和已修复的bug数量“没有可测量的变化”。话说回来,Pull Request的合并等待时间延长了49%,需要修改的审查意见几乎翻倍。
这不是一个关于AI写代码行不行的故事。它是一个关于“谁来读”的故事——当生成速度提升一个数量级,人类审查者的注意力就成了整条流水线上最窄的关口。
被AI放大的审查瓶颈
短剧里有一个精确的比喻:披萨店的烤箱快了10倍,但切披萨的仍然只有一个人。披萨在台面上堆积、变凉。代码审查就是那个切披萨的人。
据YouTube原视频和B站上多位UP主的分析,这一瓶颈的形成有两层机制。第一层是量的冲击:AI让每个开发者都能在午饭前写完3000行代码,PR数量激增,但审查者的认知带宽不变。第二层是质的退化:当审查者面对巨型PR时,理性选择往往是“扫一眼、叹口气、明天再看”,或者干脆依赖AI审查工具。
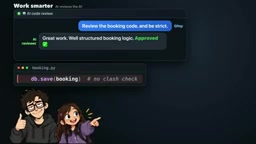
原视频中那个“AI给AI打分”的场景尤其刺眼。审查工具对包含重复预订漏洞的代码给出“结构良好、逻辑清晰、批准”的评价。剧中人物讽刺道:“它给自己的bug发了颗金星。”
这并不否定AI审查工具的价值——它们确实能捕捉真实缺陷。问题在于,当审查者本身已经放弃阅读时,工具的“通过”就变成了橡皮图章。
编码智能体(Coding Agent) 是驱动文中现象的核心技术。与传统的代码补全工具(如早期的GitHub Copilot)不同,编码智能体能够接收自然语言任务描述,自主规划多步骤操作,跨文件生成、修改甚至测试代码。它更像一个能独立完成“小项目”的初级开发者,而非逐行提示的助手。这种自主性正是3000行代码能在短时间内生成的直接原因:智能体可以一次性产出多个文件、多个模块的完整实现,将任务粒度从“写一个函数”放大到“实现一个功能”。这也解释了为何PR规模会失控——生成单元从行变成了模块,而审查单元却仍然停留在行。
Pull Request(PR) 是代码协作平台(如GitHub、GitLab)中的核心审查单元,代表一组待合并到主分支的代码变更。审查者通过阅读diff、评论、批准或要求修改来把关代码质量。PR的规模(变更行数、涉及文件数)直接影响审查效果:研究表明,超过400行的PR,审查者发现缺陷的概率显著下降。文中3000行的PR远超这一阈值,导致审查者倾向于“橡皮图章”式批准。PR合并等待时间、修改意见数量是衡量审查瓶颈的关键指标,前者反映队列积压,后者反映审查深度。
小PR的逆袭:40行代码如何跑赢3000行
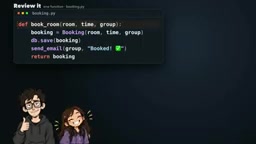
短剧的转折点来自一个被忽视的组员Priya。她问了一个没人回答的问题:“哪个文件负责预订?”然后她自己去读代码,找到了问题,写下40行修复和一个测试。
据YouTube频道对该情节的呈现,这个PR在90秒内被审查、批准并合并——而且比3000行的大PR更早进入主干。测试在没有修复时失败、有修复时通过,这是审查者最愿意看到的信号。
对比之下,3000行的PR需要审查者逐行追问“如果这里错了,什么会坏”。这不是阅读速度的问题,而是审查工作的本质:它不是通读,而是风险推演。40行可以在一次喝咖啡的时间内完成两次提问;3000行则超出了单次审查会话的合理范围。
数据背后的组织困境
那篇哈佛论文的数据值得一提,但需要谨慎对待——原视频也明确说明它“尚未经过同行评审”。据该研究,近80%的公司在引入编码智能体后使用了AI审查工具。
多源交叉验证的结果显示,不同平台的技术评论者对这一数据的解读存在分歧。一部分人认为30%的代码增量是纯粹的浪费,应当通过更严格的准入控制来抑制;另一部分人则认为增量本身是中性的,问题在于组织没有同步扩容审查能力,导致增量转化为积压。
这两种观点并不矛盾。共识在于:AI生成速度的提升本身不会自动转化为交付速度的提升,除非审查环节的吞吐量同步改善。分歧只在于治理路径——是限制生成,还是重构审查流程。
同行评审(Peer Review) 是学术研究质量控制的基石。文中哈佛工作论文“尚未经过同行评审”,意味着其数据和方法尚未接受独立专家的系统性检验,结论可能存在偏差或遗漏。在技术决策中引用此类研究时,应将其视为“早期信号”而非“定论”。同行评审通常包括方法审核、数据复现和结论合理性评估,周期可达数月。这也是为何原视频特意标注这一状态——提醒观众在采纳“30%代码增量”等数据时保持审慎,避免将未经验证的研究直接作为治理依据。
实践启示:把审查当产品来设计
短剧结尾给出了一个朴素的方案:主角把3000行拆成小PR,删掉两个多余的登录系统,只保留一个好的,并且承诺在周一演示前读完每一个PR。
这个方案对应着几条可操作的实践原则:
控制PR规模。 40行是一个可以在一次专注会话中完成风险推演的量级。超过这个量级,审查质量会非线性下降。
要求测试证据。 Priya的PR之所以能90秒通过,是因为测试本身构成了可验证的审查信号。没有测试的大PR只能依赖审查者的信任,而信任在AI生成时代是最稀缺的资源。
让作者承担解释责任。 短剧中助教的要求——“每个人解释自己的代码”——是最有效的审查前置条件。无法解释的代码不应该进入主干,无论它是谁写的。
AI审查工具是辅助,不是替代。 它可以捕捉模式化的缺陷,但不能替代对业务语义的判断。让它审查自己的输出,等于让考生批改自己的试卷。
短剧的最后一句台词是主角把审查者拉进10个PR后对方的反应:“57。”——57个待审查的PR。这个数字既是笑点,也是当下工程团队的真实处境。生成不是瓶颈,阅读才是。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。