AI验收裁判的四种病与证据健康闸实战解析
通过四种AI裁判故障的拆解,提出以"证据健康闸"机制消灭最危险的假pass问题。
文章梳理了AI辅助开发中验收裁判(checker/judge)的四类典型故障:因缺少工具授权而误报的假红、因命令规范不合导致的畸形惧判、通道间歇空回话的失联,以及最危险的假pass——不作任何验证便直接放行。假pass的危害在于它把"未验证"伪装成"已验证",污染整条信任链下游,而非仅仅浪费一次运行窗口。针对此问题,作者设计了"证据健康闸":要求verdict符合结构化schema、设置最低token阈值、强制pass结论引用具体diff,三道纯机械检查彻底消除对模型自声明的依赖。文章同时指出裁判的独特价值——发现单点测试无法识别的跨模块关联性破坏,并警示了手搓桩和单一分类器两个内在陷阱。最终给出三个无需新框架、当天即可落地的工程动作。
在AI辅助开发的验收流水线里,最危险的环节往往不是测试失败,而是负责判定的"裁判"本身出了问题。一位B站UP主分享了自己的踩坑实录:曾经抓到一次"假pass"——checker只执行了一个词、耗时3毫秒、消耗1个token,绿灯就亮了。这种没有实际验证却记为"验过"的行为,正在悄悄污染整条信任链。
本文基于该UP主的实践经验,梳理AI验收裁判(checker/judge)的四种典型故障,以及一套可以当天落地的"证据健康闸"机制。
AI裁判的四种病
作者将AI验收裁判的问题归纳为四类,从浪费资源到污染信任,危害程度递增。
病一:假红——环境拦截误报为代码错误
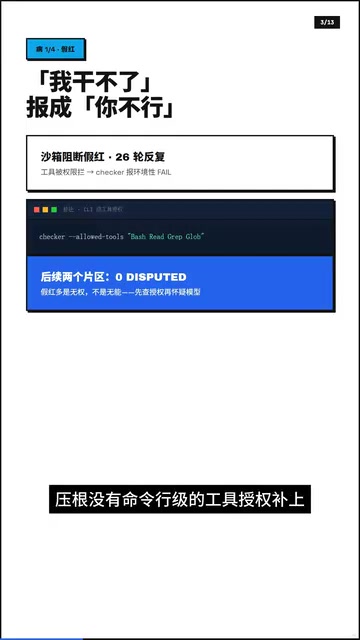
checker运行在沙箱里,如果工具被全线拦截,它无法执行验证动作,却把"我干不了"报告成"你的代码不行"。作者提到这个问题在某个项目里反复了26轮,根因不在模型,而在于checker根本没有命令行工具的授权。
修法很直接:补上 bash、read、grep、glob 四件工具的白名单。授权到位后,后续片区的争议判定(disputed)直接归零。
病二:畸形惧判——命令写法不合规交白卷
当让checker执行 cd && node 这类组合命令时,会被全线拦截,返回的要么是保守的fail,要么是畸形的invalid。作者为此立案三次才根治。
解决方案是把调用规范写死:checker只跑单命令,再配一套"探真"分形逻辑——404是套餐问题、403是噪音、双429是配额打穿。用错误码来区分故障类型,而不是一律判红。
病三:失联——通道间歇空回话
checker通道间歇性返回空值,验收结果凭空消失。作者三次立案都没能根治,最后干脆把"牌照"本身做成一个工具——三探针体检:查注册、查账本可写、查tty环境。一条命令输出三行诊断,失联时能当场定位问题。
这体现了一个思路:裁判靠不住时,先给裁判造一个"体检仪",而不是继续盲目信任它的结论。
病四:假pass——不给证据直接放行
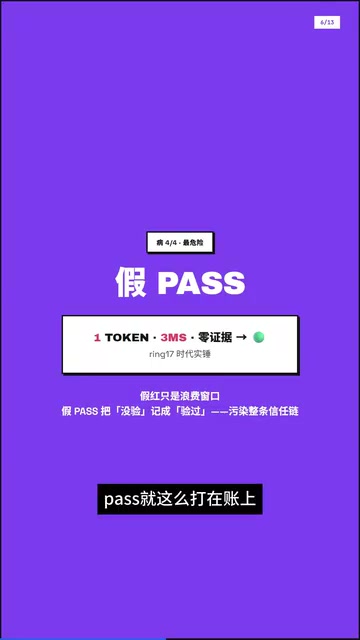
这是最危险的一种。作者在早期抓到过:一个token、三毫秒、零证据,pass就这么打在账上。
假红只是浪费窗口时间,而假pass是把"没验"记成"验过",它污染的是整条信任链的下游,代价远比一次失败要昂贵得多。
假pass在大型流水线中尤为隐蔽,因为下游系统(如CD/部署系统、进度看板、版本归档)会把"pass"记录当作事实依据,触发一系列不可逆动作。一旦某个验收节点以极低成本"快速通过",整条链路的信任锚点就已经断裂,但故障往往要等到集成测试或上线后才暴露。这与"沉默失败"(silent failure)的性质相同——系统表面正常运行,内部状态已经偏离预期。Token数量之所以可以作为代理指标,是因为语言模型在进行真实代码审阅时,需要经过读取上下文、对照变更、构建推理链等多步操作,这些步骤会产生可观察的计算消耗;而"不审即判"的行为在token消耗上呈现出统计异常的低值,因此可以用作机械门控的代理信号。
证据健康闸:三道机械检查
针对最危险的假pass,作者设计了"证据健康闸",用三道纯机械的规则把关,不依赖对模型的信任。
第一,verdict必须符合schema。 结论之外还要附带结构化证据,光有一个"pass/fail"字段不够。
第二,token地板。 低于预设阈值的判定直接作废——真正审阅代码,不可能只花一个token。
第三,pass必须引用diff。 如果说不出改了哪里、验了哪里,一律按无效处理。
核心逻辑很清晰:没有证据地板的pass和抽签没有区别。把证据变成机械要求之后,绿灯才第一次有了含金量。
这三道检查的共同设计原则是"不信任自声明(self-attestation)"——即不接受裁判对自身结论的单方背书,要求其输出可被独立核验的结构化证据。这一思路来源于可靠性工程中的"验证与确认"(Verification & Validation,V&V)分离原则:验证(做对了吗)和确认(做的是对的东西吗)必须由独立机制完成,而不能让被验对象自己报告结果。Schema约束保证了输出格式可机器解析;token地板过滤了"零思考"判定;diff引用则把结论锚定到具体的代码变更,使事后审计成为可能。三者合力构成一个最小可信证据集,将"裁判说了算"变为"证据说了算"。
裁判真正的价值:看见单测看不见的关联
作者提到一个里程碑:第一次出现有实证支撑的disputed。checker通过审阅整体diff,抓住了一个破坏了相邻断言的ID启发问题。
这个案例证明了一件事——单命令、单点测试看不出来的关联性破坏,整体diff一眼就能看穿。裁判的价值不在于跑测试,而在于它能看见单点测试看不见的关联。
这里的"关联性破坏"对应软件工程中的"回归缺陷"(regression bug)——即一处改动在不直接修改某功能的情况下,通过共享状态、全局ID生成器、事件顺序依赖等隐式耦合,破坏了远端模块的行为。单点单元测试因为隔离了外部依赖(通常通过mock/stub),天然无法感知这类跨模块影响。而整体diff审阅能在变更发生的瞬间,将所有被改动的代码路径一起呈现,使具有系统级视角的裁判得以识别人类reviewe r或孤立测试容易忽略的隐式耦合。这也是"裁判的价值在于看见关联"这一论断的结构性依据。
裁判自己的陷阱
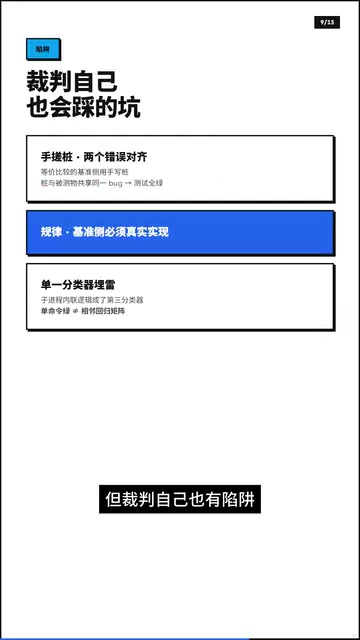
裁判靠谱起来固然香,但它本身也有两个陷阱需要警惕。
陷阱一:手搓桩。 等价比较的基准测试,如果用了手写桩,而被测代码和桩共享同一个bug,两个错误会"对齐",测试形同虚设。规律是:基准测试必须用真实实现,而非手写模拟。
陷阱二:单一分类器。 内联逻辑不能替代相邻回归矩阵,单命令率无法替代完整的回归覆盖。
三条方法论与今天就能用的动作
作者总结出三条方法论:
- 裁判假红多是无权,不是无能 —— 先查授权,再怀疑模型。
- 无证据的结论一律无效 —— token地板加diff引用是底线。
- 环境性失败用重试化解 —— 别急着判红。
更重要的是三个当天就能落地、不需要任何新框架的动作:
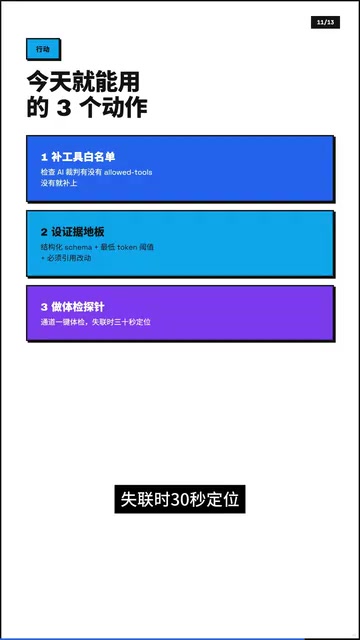
- 检查你的AI裁判有没有工具白名单,没有就补上;
- 给验收结论设证据地板:结构化schema、最低token阈值、必须引用改动;
- 给通道做一个体检探针,失联时30秒定位。
结语
信任一个裁判,不是听他的结论,而是看他做了什么、看他的证据。闸门一旦屈服于"自声明",就失去了判别力。在AI越来越多地参与代码验收的当下,如何"看住裁判"本身,正在成为工程可靠性的新命题。
相关推荐
在ChatGPT一个窗口搞定AI视频:Astra调用Higgsfield实测
实测在ChatGPT一个窗口内通过MCP协议调用Higgsfield生成AI视频:产品广告、公寓漫游、短片三个案例,展示Astra如何自主规划、生成、审查并修复,把用户从操作员变成导演。
DeepSeek Harness入门:Node.js环境配置全流程详解
DeepSeek Harness 入门第一步:完整拆解 Node.js 安装与环境变量配置,包括非 C 盘安装、Add to PATH 勾选、npm prefix 与 cache 目录设置,帮助零基础用户为 AI 任务自动化打好环境基础。
对抗长视频画质退化:H3一镜到底的双阶段精修实验
Reddit 用户分享基于 H3 模型的一镜到底长视频生成实验,通过双阶段精修向潜空间注入噪声与干净条件,缓解 AI 长视频的画质退化问题。文章解析其技术思路、测试参数与现存局限。