AI药物安全知识缺口:LABEL研究揭示语言模型为何忽视禁忌症

公开文本中药物益处提及约为安全限制两倍,语言模型忠实继承这一偏差。
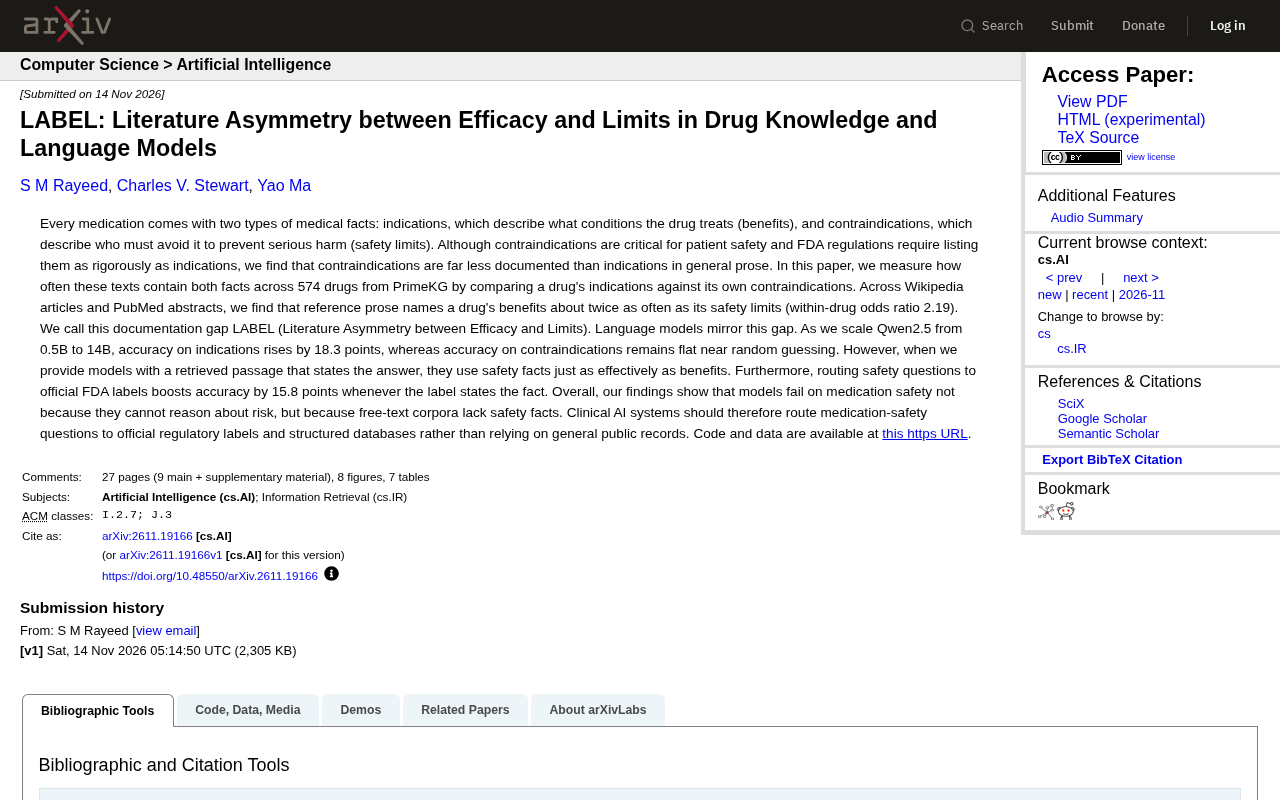
该论文提出LABEL概念,即疗效与限制之间的文献不对称。研究选取574种药物,对比其适应症与禁忌症在维基百科和PubMed摘要中的出现频率,发现益处表述约为安全限制的两倍(药物内比值比2.19),尽管FDA标签要求同等严谨地列出禁忌症。语言模型实验显示,Qwen2.5从0.5B扩展到14B时,适应症准确率提升18.3个百分点,禁忌症准确率却仍接近随机猜测,说明规模扩展无法弥补语料中安全事实的匮乏。当提供明确陈述答案的检索文本时,模型能有效利用安全信息;将问题路由至官方FDA标签可使准确率提升15.8个百分点。研究结论是临床AI应优先接入监管标签与结构化数据库,而非依赖通用公开文本。
药物说明书上的禁忌症(contraindications)与适应症(indications)本应同等重要,但一项新研究发现,公开文本对前者的记录远少于后者,而语言模型也忠实反映了这种偏差。这篇名为《LABEL: Literature Asymmetry between Efficacy and Limits in Drug Knowledge and Language Models》的论文,通过分析574种药物在维基百科和PubMed摘要中的表述,揭示了这一被忽视的安全知识鸿沟。
核心发现:安全限制的文档缺口有多大?
研究团队从PrimeKG数据库中选取了574种药物,对比每种药物自身的适应症与禁忌症在自由文本中出现的频率。结果显示,在维基百科文章和PubMed摘要中,提及药物益处的频率约为提及安全限制的两倍(药物内比值比2.19)。作者将这一现象命名为LABEL(Literature Asymmetry between Efficacy and Limits),即疗效与限制之间的文献不对称。
这种不对称并非偶然。尽管FDA法规要求药品标签必须同等严谨地列出禁忌症,但面向公众的科普文本、学术摘要往往更倾向于描述药物的治疗价值,而对风险信息的覆盖相对薄弱。
药物内比值比(within-drug odds ratio) 是一种在配对设计中衡量两个事件相对频次的统计量:对每一种药物,分别统计其适应症与禁忌症在文本中被提及的次数,再在药物内部计算两者之比,最后将所有药物的比值汇总为一个总体估计。由于比较发生在同一种药物内部,药物的知名度、上市时间、文献总量等混杂因素被自然抵消,因此2.19这一数值可以直接解读为“同一种药物的益处表述比安全限制表述多出约一倍”,而不必担心热门药物拉高整体频次。
PrimeKG 是一个多模态精准医学知识图谱,整合了药物、疾病、基因、蛋白、副作用等多类节点以及它们之间的结构化关系(如药物—适应症、药物—禁忌症边)。研究以它为抽样框,可以确保574种药物在数据集中都有官方标注的适应症与禁忌症作为“金标准”,从而使文本频次的比较有据可依。
语言模型如何镜像这一偏差?
研究进一步检验了语言模型是否继承了这种文本偏差。以Qwen2.5系列为例,从0.5B到14B参数规模,模型在适应症问题上的准确率提升了18.3个百分点,但在禁忌症问题上的准确率却几乎停滞在随机猜测水平附近。
这意味着,单纯扩大模型规模并不能自动弥补安全知识的缺失。模型并非缺乏推理风险的能力,而是训练语料中本就缺少足够的安全事实。
检索增强与官方标签的补救效果
当研究者为模型提供一段明确陈述答案的检索文本时,模型对安全事实的利用效率与对益处事实相当。这表明模型具备处理风险信息的能力,只是需要正确的知识来源。
另一项实验发现,将药物安全问题路由到官方FDA标签,只要标签中明确陈述了相关事实,模型准确率就能提升15.8个百分点。这一结果指向了临床AI系统的可行改进方向:与其依赖通用公开文本,不如将药物安全问题定向到监管标签和结构化数据库。
参数规模缩放(scaling) 指的是通过增加模型参数量与训练数据量来提升能力。LABEL实验的价值在于揭示缩放并非万能:适应症问题随规模提升18.3个百分点,说明模型能从语料中习得并放大关于疗效的知识;而禁忌症准确率停留在随机猜测附近,说明当训练语料中某一类事实本身就稀疏时,扩大规模只会让模型更流利地复述它“见过很多”的那一半知识。换言之,缩放改善的是对已有信息的压缩与调用效率,而不是凭空补齐缺失的事实。这也解释了为何模型看似“知道”很多药物用途,却对谁不能用、什么情况下禁用答不上来——这是数据分布的镜像,而非推理模块的故障。
检索增强生成(RAG) 指在模型生成答案前,先从外部知识源检索相关段落并注入上下文,使模型基于给定文本作答,而非仅依赖参数中记忆的知识。本研究的实验设计正是RAG的受控版本:当检索文本明确陈述答案时,模型对安全事实的利用率与益处事实相当,这排除了“模型不理解风险语义”的解释,把问题定位到知识供给端。
FDA药品标签( prescribing information) 是经监管审评的结构化文档,其中的“禁忌症(Contraindications)”与“警告和注意事项(Warnings and Precautions)”章节以标准化格式陈述风险事实。将安全问题路由到此类标签,本质上是用权威结构化来源替代开放语料,属于“检索源选择”层面的干预——它不改变模型,只改变模型看到什么,因此部署成本低、可审计性强,也更契合临床场景对可追溯性的要求。
对临床AI系统的启示
LABEL研究传递的核心信息是:模型在药物安全上的失败,根源在于自由文本语料的安全事实匮乏,而非模型推理能力的缺陷。因此,临床AI系统应当优先接入官方监管标签和结构化药物数据库,而不是仅依赖维基百科或PubMed摘要等通用公开记录。
这一发现也对医学文本的撰写者提出警示:在描述药物疗效的同时,需要同等重视禁忌症等安全限制的传播,否则AI系统将持续放大这种知识偏差。
研究团队已公开代码与数据,可供后续研究复现与拓展。
相关推荐
Anthropic上市:AI泡沫还是买入机会?
Anthropic在纳斯达克上市,开盘价较发行价高出约三分之一,市场给出两万亿美元级别的隐含估值。拆解813亿美元募资、1.5万亿美元发行估值与两万亿美元市场估值三个数字的差异,分析Claude业务增长与5.67亿美元季度营业亏损并存的基本面,并给出下一份财报该关注的检查清单。
FBI的AI黑客警告,为何系于微软一句话
FBI公告称AI工具Artex攻击超2250家组织,但引用链显示该数字源自微软报告中"尝试登录"的表述。尝试与成功入侵之间的差距,揭示了这场AI驱动攻击的真实规模与日志证据的局限。
Fable 5.2 助攻:浏览器里的月球火星探索游戏 Getsumen Express 诞生记
开发者利用 Fable 5.2 平台打造浏览器游戏《Getsumen Express》,玩家可探索月球火星、扫描真实地标、射击外星人并乘坐星际列车。游戏基于 Three.js 与 WebGPU 开发,成本约 730 美元,展示了 AI 辅助开发的潜力。