AI与科学:科学理想结局是赋能百万好奇科学家,而非少数闭源实验室

AI辅助科学面临路线分歧:是少数实验室用专有模型攻克奖杯问题,还是让百万科学家用开源AI追随好奇心。
文章围绕AI for Science的路线分歧展开。一方是"奖杯问题"路径:少数拥有专有模型和巨额资金的实验室集中攻克蛋白质折叠等标志性难题,产出高影响力成果但门槛极高。另一方是"百万科学家"路径:AI工具被广泛分发,让大量研究者以低成本追随自己的好奇心,探索更分散、更贴近真实世界的问题。推文作者明确支持后者,认为专有模型制造了新的科研壁垒,压缩了外部研究者的问题选择空间,而开源模型与成熟工具链正在降低门槛。实现这一路径需要算力、数据、协作、文化四层基础设施。文章也呈现了反方观点:集中攻关在某些难题上确实必要,AlphaFold即是例证。核心判断是:科学的长期健康取决于参与者数量与多样性,而非里程碑数量。
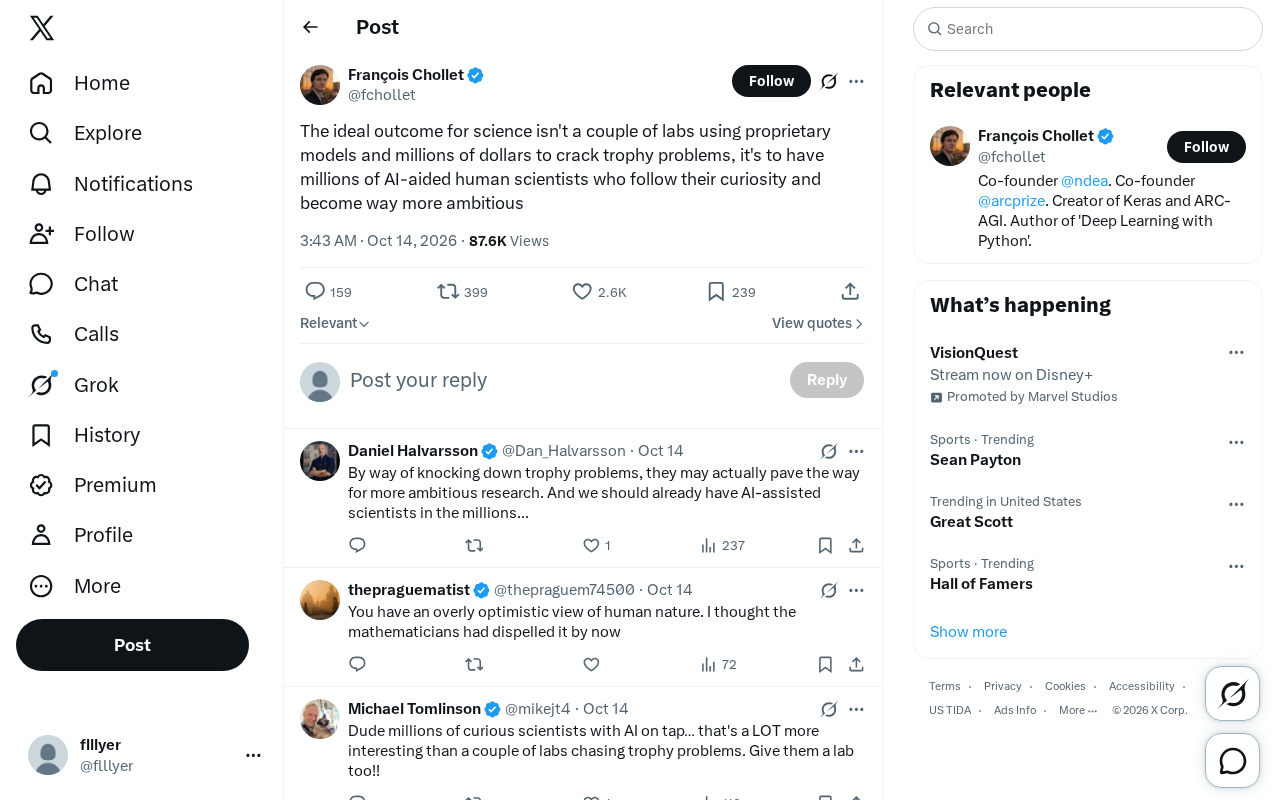
科学的理想结局,不是几个实验室用专有模型和数百万美元攻克“奖杯问题”,而是让数百万AI辅助的人类科学家追随好奇心,变得更有野心。
这句来自社交平台的观点,指向了当前AI for Science浪潮中一个根本性的路线分歧:我们究竟在追求少数精英实验室的突破,还是整个科学共同体的能力跃迁?
两种科学未来:奖杯问题 vs 好奇心驱动
按照这条推文的划分,AI辅助科学有两条截然不同的路径。
一条是“奖杯问题”路径。少数拥有专有模型和巨额资金的实验室,集中算力与数据,攻克蛋白质折叠、新材料发现等标志性难题。这种模式的产出往往是高影响力论文和引人注目的里程碑,但参与门槛极高——没有数千万美元预算和顶尖工程团队,普通研究者几乎无法进入赛场。
另一条是“百万科学家”路径。AI工具被广泛分发,让大量人类科学家以更低成本、更高效率追随自己的好奇心。这些研究者未必瞄准《自然》或《科学》的封面,但他们的问题更分散、更贴近真实世界的复杂性。推文作者明确站在这条路径上,认为这才是科学的理想结局。
两条路径并非完全互斥,但资源分配和工具可及性的优先级截然不同。
"奖杯问题"(trophy problem)这一说法借用了登山领域的隐喻,指那些目标明确、结果可量化、成功后能获得巨大声誉的标志性科学难题。典型的例子包括蛋白质结构预测、可控核聚变点火、室温超导材料发现等。这类问题的特点是:一旦解决,会被视为里程碑式的突破,往往能登上顶级期刊封面甚至角逐诺贝尔奖。但正因为其"奖杯"属性,攻克过程通常需要极端集中的资源投入——大规模算力集群、海量专有数据、跨学科顶尖工程团队,以及动辄数千万乃至上亿美元的预算。这种资源结构天然将参与者限制在少数机构内,形成一个高门槛的"锦标赛",而绝大多数研究者只能作为旁观者。
专有模型如何限制了科学野心
专有模型对大科学的贡献肯定的是,但它同时制造了新的壁垒。
当模型权重、训练数据和推理接口都不公开时,外部研究者只能通过API调用获得有限能力。他们无法微调模型以适应特定领域,无法审计模型内部机制,更无法将模型嵌入自己熟悉的本土化工作流。这种限制直接压缩了科学探索的空间——你只能问模型允许你问的问题。
更隐蔽的问题是激励扭曲。当算力和资金集中在少数机构,科研评价体系也会随之倾斜。年轻研究者发现,与其花三年追踪一个冷门但有趣的问题,不如加入某个“奖杯项目”做工程实现。好奇心被边缘化,科学家的风险偏好下降。
推文中的“数百万美元”不是修辞。前沿AI模型的训练成本确实在这个量级,这意味着只有极少数机构能负担从头训练。
让百万科学家用上AI:开源与工具民主化
如果认同“百万AI辅助科学家”是更优目标,那么工具的可及性就是核心变量。
开源模型正在缩小能力差距。以Llama系列、Mistral、Qwen为代表的开源权重模型,虽然未必在所有基准上匹敌顶级闭源模型,但对大多数学术场景已经够用。研究者可以在本地或校园集群上运行推理,处理敏感数据而不必上传第三方。
工具链的成熟同样关键。从Hugging Face的模型库到LangChain、LlamaIndex等编排框架,再到各类领域适配器,构建一个AI辅助科研工作流的门槛已经从“需要ML博士”降到“需要懂Python和领域知识”。
这种民主化带来的不是效率的线性提升,而是科学问题选择集合的指数扩张。当每个生态学家、考古学家、材料学家都能随手调用AI分析数据、生成假设、设计实验,那些从未被大实验室注意到的角落问题才可能被系统性地探索。
开源权重模型(open-weight model)指的是模型参数可以被公众下载、本地部署和微调的大语言模型,与只提供API访问的闭源模型形成对照。Llama系列由Meta发布,Mistral来自法国初创公司Mistral AI,Qwen则由阿里巴巴开发,它们是当前开源生态中影响力最大的几个家族。这些模型虽然在一些权威基准(如MMLU、GPQA)上可能落后于GPT-4或Claude等顶级闭源模型几个百分点,但在学术研究的常见任务上——文献摘要、代码辅助、假设生成、数据清洗——已经具备实用价值。更关键的是,开源权重意味着研究者可以在本地或校园集群上运行推理,处理涉及隐私或未发表的敏感数据时不必上传到第三方服务器,这对医学、社会科学等领域的合规要求至关重要。
好奇心驱动的科学需要什么样的基础设施
要让“百万科学家”路径落地,仅有模型开源还不够。
算力层需要更灵活的学术配额机制。国家超算中心、云厂商的科研 credits、以及像NSF资助的NAIRR试点项目,都在尝试降低学术界的算力门槛。
数据层需要领域专用的开放数据集和评估基准。通用基准无法反映古生物学或流行病学的真实需求,领域社区需要自己构建评测标准。
协作层需要支持长尾问题的发表与复用。当一个问题只有几十个人关心,传统期刊的审稿动机不足;预印本、开放评审和代码共享平台成为更合适的载体。
文化层则需要重新赋予好奇心以合法性。这不是喊口号,而是要在基金评审、晋升标准、团队考核中给“有趣但暂未见应用”的工作留出空间。
NAIRR(National AI Research Resource,国家人工智能研究资源)是美国国家科学基金会(NSF)牵头的一项试点计划,旨在为学术界提供集中的算力、数据集、模型和培训资源,以缩小学术研究者与工业界实验室之间的AI资源鸿沟。该计划于2023年启动试点,2024年扩展,借鉴了当年NSFNET(后来的互联网骨干)的成功经验。其核心逻辑是:如果前沿AI能力只掌握在少数商业公司手中,公共资助的科学研究将在问题选择和技术路径上受制于人。NAIRR试图通过政府协调的共享基础设施,让不具备自建超算能力的高校和小型研究团队也能获得可观的GPU配额和 curated 数据集。类似的思路在欧洲、英国和日本也有对应尝试,但规模和覆盖范围目前仍处于早期阶段。
不同声音:专有模型也有其存在理由
需要指出,这场讨论中并非只有一种立场。支持专有模型集中攻关的观点认为,某些科学难题确实需要极端规模的算力和工程投入,分散化反而会拖慢突破速度。蛋白质折叠的AlphaFold就是集中模式成功的例证。
另一种担忧是质量管控。如果百万科学家各自用AI生成假设和结果,科学文献的可信度、可重复性压力会进一步上升。工具民主化必须伴随方法论教育的普及。
这些分歧不会很快消失。但推文作者的核心判断值得重视:把科学理想等同于少数奖杯问题,是目标函数的误设。科学的长期健康取决于参与者的数量和多样性,而非里程碑的数量。
AI在这里的角色,不是取代科学家,也不是只服务于顶级实验室,而是成为放大好奇心的杠杆。
AlphaFold是集中攻关模式最具说服力的案例。由DeepMind开发的这一蛋白质结构预测系统,在2020年CASP14竞赛中达到与实验方法相媲美的精度,被视为结构生物学五十年来最重大的突破之一。它的成功依赖于DeepMind拥有的独特资源组合:数百块专用TPU、多年积累的蛋白质序列数据库、以及一支由顶尖机器学习研究员和结构生物学家组成的跨学科团队。这种配置几乎不可能在单个大学实验室复制。支持集中模式的观点据此认为,某些科学难题存在"临界规模"——低于这个规模的投入不会产生突破,而分散化只会让众多小团队在同一个难题上重复消耗有限的算力。因此,专有模型和集中资源在特定前沿领域不仅是合理的,甚至是必要的。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。