AI智能体能重新发现Blaschke曲线不变量吗?一次数学再发现实验

一项受控实验测试AI能否盲发现Blaschke曲线不变量,结论是:能,但传统方法同样做得到。
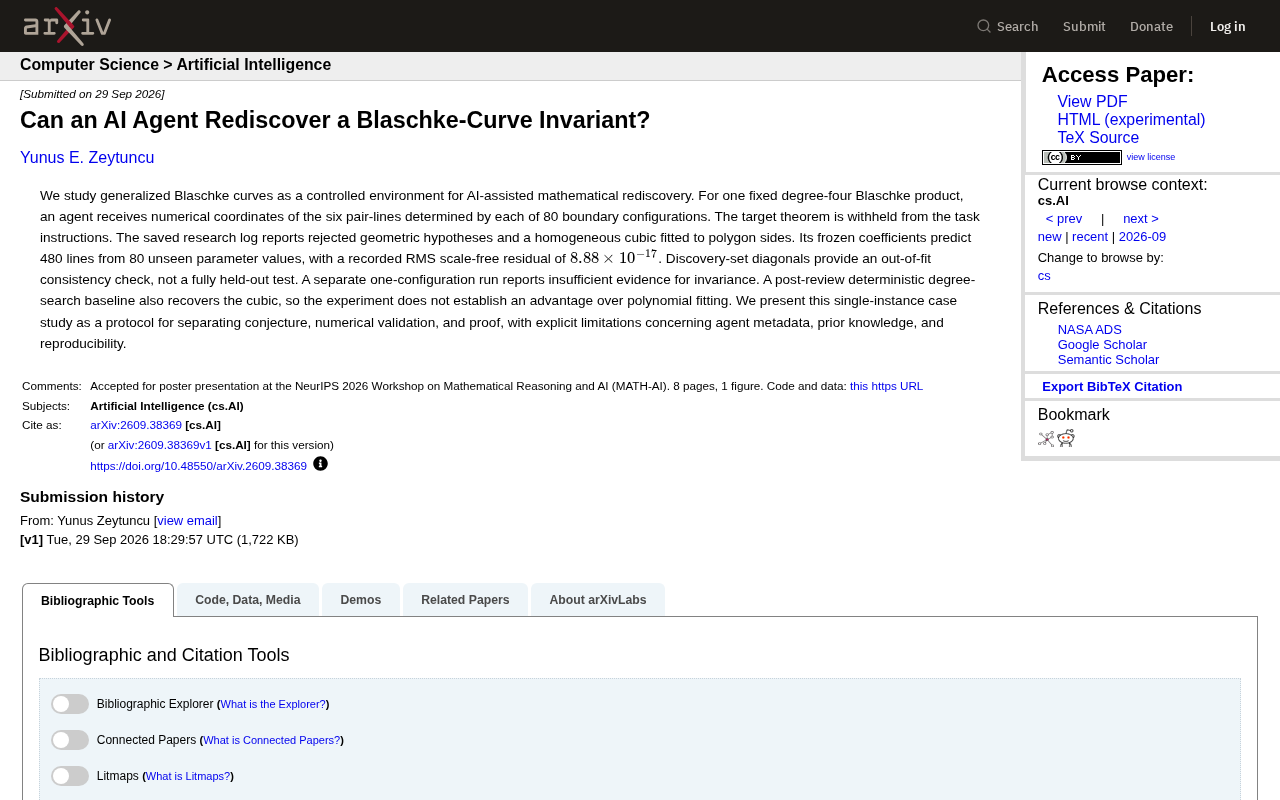
这篇arXiv论文围绕广义Blaschke曲线设计了一项受控实验:AI智能体在不知道目标定理的情况下,从80组纯数值几何坐标中归纳规律,最终拟合出一个齐次三次式,其在480条未见数据上的残差低至接近机器精度的$8.88\times10^{-17}$。然而,评审后引入的确定性次数搜索基线同样复现了该三次式,且单一配置运行证据不足,验证也仅为拟合内一致性检验而非独立盲测。论文的核心贡献因此落在方法论层面:它建立了一套严格区分猜想、数值验证与证明的研究协议,并坦诚列出训练数据污染、先验知识干扰等根本局限,为AI辅助数学发现提供了一个罕见的严谨样本。
一项关于AI辅助数学发现的受控实验
当大型语言模型和AI智能体不断刷新能力边界时,一个更深层的问题浮出水面:AI能否像数学家那样,在没有被告知答案的情况下,独立"重新发现"一个数学定理?arXiv上一篇新论文(arXiv:2609.38369v1)尝试在一个精心设计的受控环境中回答这个问题,其研究对象是广义Blaschke曲线(generalized Blaschke curves)。
这项研究的价值不在于宣称AI取得了突破,而在于它提供了一套分离猜想、数值验证与证明的研究协议,并且难得地坦诚了实验的全部局限。
实验是如何设计的
研究者固定了一个四次Blaschke乘积(degree-four Blaschke product),作为AI智能体探索的数学对象。智能体接收到的输入是纯粹的数值数据:针对80种边界配置,每种配置由六条"配对线"(pair-lines)确定,智能体拿到的是这些线的数值坐标。
关键设计在于——目标定理被完全从任务指令中隐去。也就是说,AI并不知道自己要找什么,它只能从这堆几何坐标中自行归纳出潜在的规律。这种"盲找"设定,正是为了检验AI是否具备真正的发现能力,而非简单地复述已知结论。
智能体做了什么
根据保存的研究日志,这个智能体的探索过程并非一帆风顺。日志记录了它提出并否决的多个几何假设,最终拟合出了一个关于多边形边长的齐次三次式(homogeneous cubic)。这个过程本身——试错、排除、收敛——恰恰模拟了人类数学研究的真实路径。
Blaschke乘积(Blaschke product)是复分析中的经典构造,形如将若干形如 $\frac{z - a_k}{1 - \bar{a}_k z}$ 的因子相乘,其中 $|a_k| < 1$。它将单位圆盘映射到自身,且在单位圆边界上模长恒为1。"广义Blaschke曲线"则是由Blaschke乘积诱导出的一类代数曲线,其几何性质与内切多边形、Poncelet闭合定理等经典问题密切相关。本实验中的"四次"指乘积由四个因子构成,对应的几何结构会在边界产生具有特定对称性的多边形族。正因为这类曲线的代数不变量有明确的数学真相可供对照,它才成为检验AI发现能力的理想沙盒。
数值结果:惊人的精度
实验结果从数字上看相当漂亮。拟合得到的三次式系数被"冻结"后,用于预测80个未参与拟合的参数值所对应的480条线。记录显示,其无量纲(scale-free)的RMS残差仅为 $8.88\times10^{-17}$。
这个数量级已经逼近双精度浮点数的机器精度,意味着拟合出的关系式在数值上几乎"完美"成立。对于一个事先不知道答案的智能体而言,能收敛到如此精确的不变量,表面上看是令人信服的。
验证的边界在哪里
但论文作者在此处表现出了严谨。他们明确指出,发现集(discovery-set)中的对角线数据只提供了拟合之外的一致性检验(out-of-fit consistency check),而不是一个完全独立的保留测试(held-out test)。换言之,这种验证虽有意义,但强度不及真正的盲测。
此外,另一组仅使用单一配置的运行则报告称,证据不足以支持不变性成立。这说明结论对实验设置的依赖性很强,单点数据无法支撑普遍性判断。
双精度浮点数(IEEE 754 double precision)的机器精度(machine epsilon)约为 $2.22 \times 10^{-16}$,表示两个相邻可表示实数之间的最小相对间距。当一个计算结果的残差落在 $10^{-17}$ 量级时,意味着误差已低于浮点表示本身的精度下限,这在数值上等同于"精确成立"。然而这也带来一个解读陷阱:如果底层数据本身是由某个精确代数关系生成的,那么任何足够灵活的拟合模型,只要选对了次数,都能在机器精度范围内重现这一关系。因此,极低的残差只能证明"找到了正确的函数形式",并不能区分这究竟源于真正的发现还是对已知结构的数值重建。
最诚实的部分:AI并未胜过传统方法
这篇论文最值得称道之处,是它没有回避一个对自己不利的结果。在评审后的复盘中,研究者引入了一个确定性的次数搜索基线(deterministic degree-search baseline)——一种传统的多项式拟合方法。结果是,这个基线方法同样能恢复出那个三次式。
这意味着:在这个具体实验中,AI智能体相比传统多项式拟合并没有展现出优势。换句话说,AI能找到的东西,一个朴素的自动化搜索也能找到。这对当下盛行的"AI数学发现"叙事是一记冷静的提醒。
确定性次数搜索(deterministic degree search)是符号回归与多项式拟合领域的标准技术:依次尝试一次、二次、三次……多项式,通过最小二乘或其他准则选出残差最小的次数,再输出对应系数。这类方法计算成本低、结果可复现,且不依赖大模型的随机采样。它在数学发现任务中构成一个天然的"最低水位线"基线——AI系统若无法超越它,则其增量价值存疑。这一比较在AI for Science研究中普遍缺席,正是本文将其明确列出的方法论价值所在:只有在受控对照下,才能判断AI带来的究竟是能力扩展还是复杂度增加。
为什么这项"没有突破"的研究仍然重要
抛开结果本身,这项研究的真正贡献是方法论层面的。作者将其定位为一个单实例案例研究(single-instance case study),核心目的是建立一套可复现的协议,用于严格区分三个层次:
- 猜想(conjecture):AI提出的假设性规律;
- 数值验证(numerical validation):用未见数据检验规律;
- 证明(proof):数学意义上的严格确立。
在AI频繁被包装成"科研革命者"的今天,这种刻意拉开猜想与证明距离的做法尤为可贵。论文还就智能体元数据、先验知识、可复现性等问题列出了明确的局限性。例如,很难完全排除智能体在训练数据中已经"见过"相关数学结构的可能——这正是评估AI发现能力时最棘手的污染问题。
对AI for Science的启示
这项工作提示我们,评判AI的科学发现能力需要更苛刻的标准:
- 必须设置真正的保留测试,而非拟合内的自洽检验;
- 必须对照传统自动化方法,确认AI是否带来增量价值;
- 必须正视训练数据污染与先验知识的干扰。
结语
回到最初的问题——AI智能体能重新发现Blaschke曲线不变量吗?这篇论文给出的答案是克制而诚实的:在数值上它找到了那个不变量,但这既算不上完全独立的发现,也没有超越传统方法。
相比一个华丽的"是",这种带着星号与限定条件的回答,反而更接近科学的本来面目。它为AI辅助数学研究立下了一个值得效仿的严谨样本。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。