AI智能体需要专属数据工作区吗?开源项目DataMind的探索
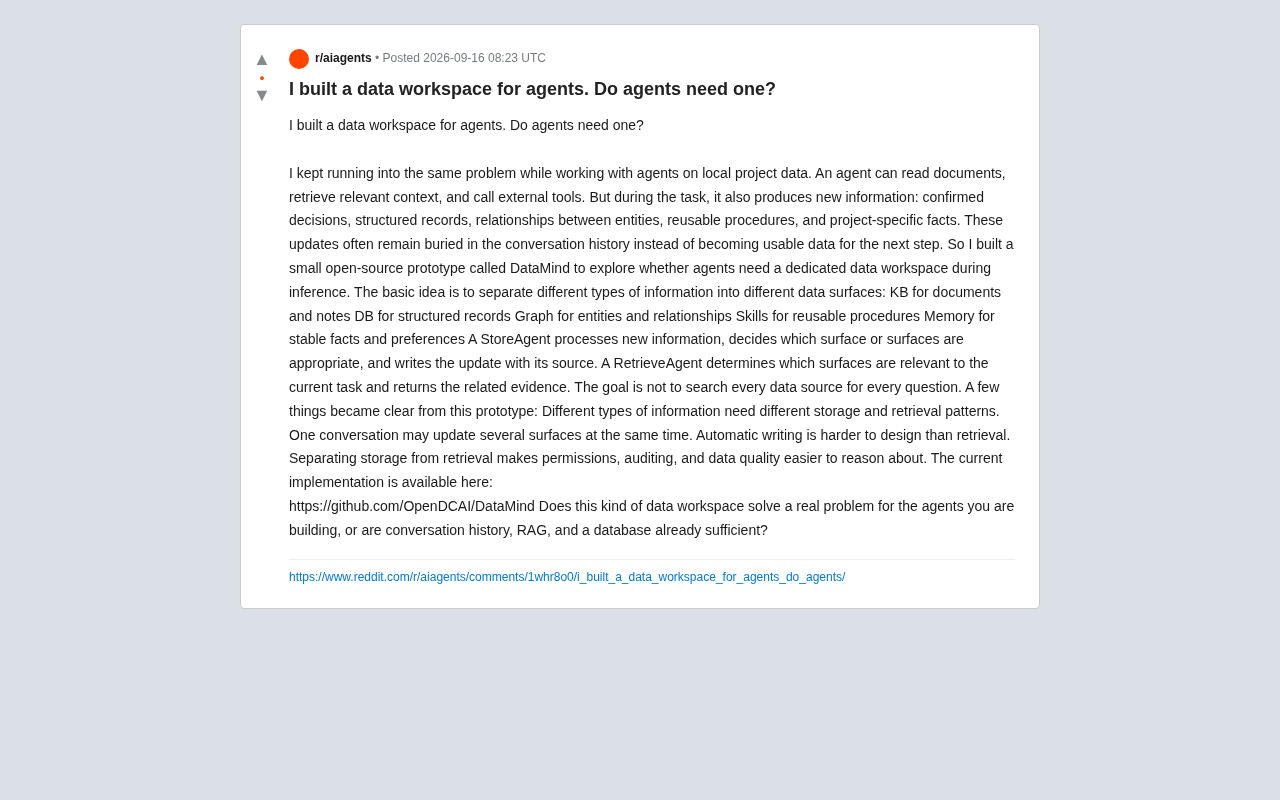
DataMind原型将智能体推理产生的信息按类型分层存储,解决成果埋没在对话历史的痛点。
智能体在处理任务时会持续产生新信息——决策、实体关系、可复用流程、项目事实——但这些内容通常被淹没在对话历史里,无法结构化复用。开发者为此构建了开源原型 DataMind,将信息划分为知识库、数据库、图、技能、记忆五类「数据表面」,并引入 StoreAgent 和 RetrieveAgent 两个专职智能体分别负责写入与检索。原型验证表明,不同信息类型需要不同存储模式,自动写入比检索更难可靠实现,而存储与检索分离则让权限管理和数据审计更清晰。项目的核心价值在于提出问题:随着智能体任务日趋复杂,对话历史加 RAG 加数据库的组合是否已经足够,还是智能体确实需要一个持久化、分层、可审计的专属工作区。
智能体推理时产生的数据去哪了?
一位开发者在与AI智能体处理本地项目数据时,反复遇到同一个问题:智能体能读取文档、检索相关上下文、调用外部工具,但在执行任务的过程中,它也在不断产生新的信息——已确认的决策、结构化记录、实体之间的关系、可复用的操作流程,以及项目专属的事实。
问题在于,这些新产生的信息往往被埋没在冗长的对话历史里,无法成为下一步任务可直接调用的数据。换句话说,智能体每次工作的成果并没有沉淀下来,下一轮任务又得从零开始梳理上下文。
为了验证智能体在推理阶段是否需要一个专属的数据工作区,这位开发者构建了一个名为 DataMind 的小型开源原型。项目已在 GitHub 开放(OpenDCAI/DataMind)。
DataMind 的核心思路:按信息类型划分数据表面
DataMind 的基本理念是将不同类型的信息分离到不同的「数据表面」(data surfaces)上,而不是把所有内容一股脑塞进同一个存储或对话历史中。
具体划分为五类:
- KB(知识库):存放文档和笔记
- DB(数据库):存放结构化记录
- Graph(图):存放实体及其关系
- Skills(技能):存放可复用的操作流程
- Memory(记忆):存放稳定的事实与偏好
这种划分的逻辑在于:文档、结构化记录、实体关系、操作流程和长期偏好,本质上有着完全不同的存储与检索模式。把它们混在一起,既难检索,也难保证质量。
双智能体架构:写入与检索分离
DataMind 引入了两个专职智能体来管理数据流转:
- StoreAgent(写入智能体):处理新产生的信息,判断这条信息应该归入哪一个或哪几个数据表面,并连同来源一起写入。
- RetrieveAgent(检索智能体):判断当前任务与哪些数据表面相关,返回对应的证据。
设计目标很明确——不是对每个问题都遍历所有数据源,而是精准定位到相关的表面。这与传统 RAG「一个向量库打天下」的做法形成对比。
传统 RAG(Retrieval-Augmented Generation,检索增强生成)的核心模式是:将外部文档切片后编码为向量,存入向量数据库,推理时将用户问题也转为向量,通过相似度搜索召回最相关的片段,拼入提示词后交给语言模型生成回答。这套机制在「查阅现有知识」场景下表现良好,但存在一个先天局限:它是单向的读取管道,并不负责将智能体在推理过程中新产生的信息结构化地写回存储。此外,向量相似度检索对「实体关系」「操作流程」等非文本语义的结构性信息也不擅长处理,这正是 DataMind 引入分层数据表面和双智能体写入机制试图弥补的空缺。
原型验证得出的几点结论
开发者在构建这个原型的过程中,得出了几个值得关注的观察:
不同信息类型需要不同的存储与检索模式。 用同一套机制处理文档和实体关系,往往两头都不讨好。
一次对话可能同时更新多个数据表面。 一段用户交流里,可能既有新事实(Memory)、又有新决策(DB)、还有新的实体关联(Graph),需要同时写入。
自动写入比检索更难设计。 检索是「找出相关内容」,而写入需要智能体主动判断「这条信息重要吗、该归到哪、如何避免污染已有数据」,决策链更长、出错代价更高。
存储与检索分离让权限、审计和数据质量更易于推理。 当写入和读取是两个独立环节时,谁写了什么、数据从何而来、质量是否可靠,都变得更清晰可控。
智能体真的需要数据工作区吗?
这正是开发者抛给社区的核心问题:这种数据工作区是否真正解决了实际问题,还是说对话历史、RAG 和一个数据库已经足够?
从工程实践角度看,这个问题触及了当前智能体开发的一个真实痛点。随着智能体承担的任务越来越长、越来越复杂,「上下文记忆」和「知识沉淀」的矛盾日益突出。对话历史窗口有限且难以结构化复用,纯 RAG 擅长检索但不擅长记录智能体自己产生的动态数据,单一数据库又缺乏语义检索能力。
DataMind 试图给出的答案是:与其让智能体在推理时临时拼凑,不如给它一个持久化、分层、可审计的工作空间。这个方向与业界近期对「智能体记忆系统」的探索一脉相承——从简单的对话缓冲,到向量记忆,再到如今按信息类型分层的结构化记忆。
当然,这只是一个探索性原型,其价值更多在于提出问题而非给出定论。自动写入的可靠性、多表面同步更新的一致性、以及在实际项目中的性能开销,都还需要更多验证。但它清晰地指出了一个值得深入的方向:智能体不只需要「读」的能力,更需要一个能安全「写」并沉淀成果的地方。
「智能体记忆系统」是当前 AI 工程领域的活跃研究方向,业界通常将其分为四个层次:短期记忆(对话上下文窗口)、外部记忆(向量库或数据库)、情节记忆(对过去交互的结构化归档)和语义记忆(长期稳定的事实与规则)。现有框架如 LangChain、MemGPT(LettaAI)已在不同程度上实现了这些分层,MemGPT 尤其强调将有限上下文窗口视为「内存」、将外部存储视为「磁盘」,通过显式的换页机制管理信息流。DataMind 的五类数据表面可视为对「语义记忆」层的进一步细化——将原本笼统的「长期记忆」按信息的结构特征拆解为知识、记录、关系、技能和偏好五种形态,并为每种形态匹配不同的存储与检索后端。
写在最后
DataMind 作为开源原型,其最大意义可能不在于代码本身,而在于它把一个容易被忽视的问题摆上台面:智能体在工作时产生的新知识,到底该去哪里?如果你正在构建智能体应用,不妨思考自己项目里的信息沉淀方式,是否也存在「成果埋没在对话历史」的隐患。项目地址:github.com/OpenDCAI/DataMind。
相关推荐
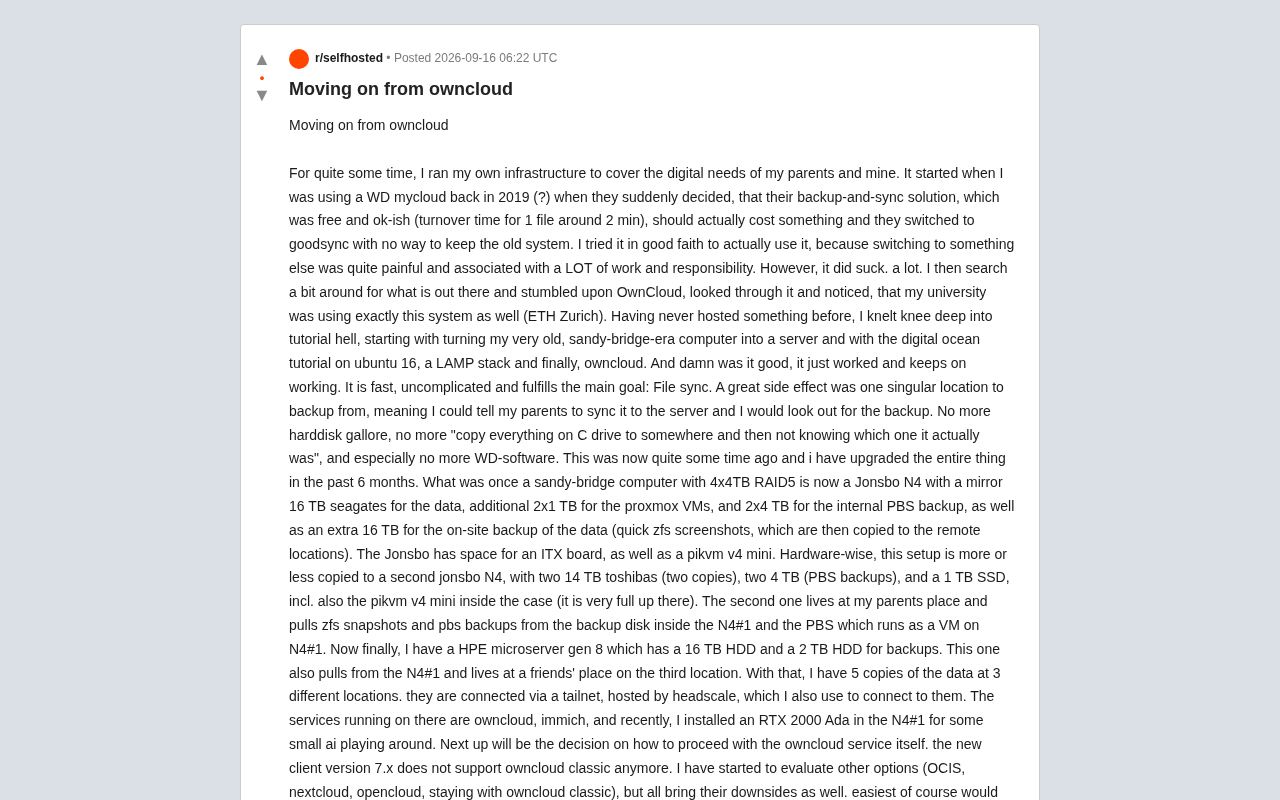
从 ownCloud 迁移:自建 5 副本 3 地备份的家庭 NAS 实践
一位 Reddit 用户分享了从 WD MyCloud 到自建 ownCloud 的完整历程,展示三地五副本的 ZFS+Proxmox 备份架构,并深入探讨 ownCloud 客户端停止支持经典版后向 OCIS、Nextcloud、OpenCloud 迁移的抉择。
Agent Skills 是什么?从理解到定制的开发入门指南
Agent Skills 是智能体开发中的重要一环。本文解析 Skill 的概念、在 Claude Code 等 Agent 生态中的位置,以及从理解、定制到应用的三步学习路径,帮助零基础开发者快速入门。
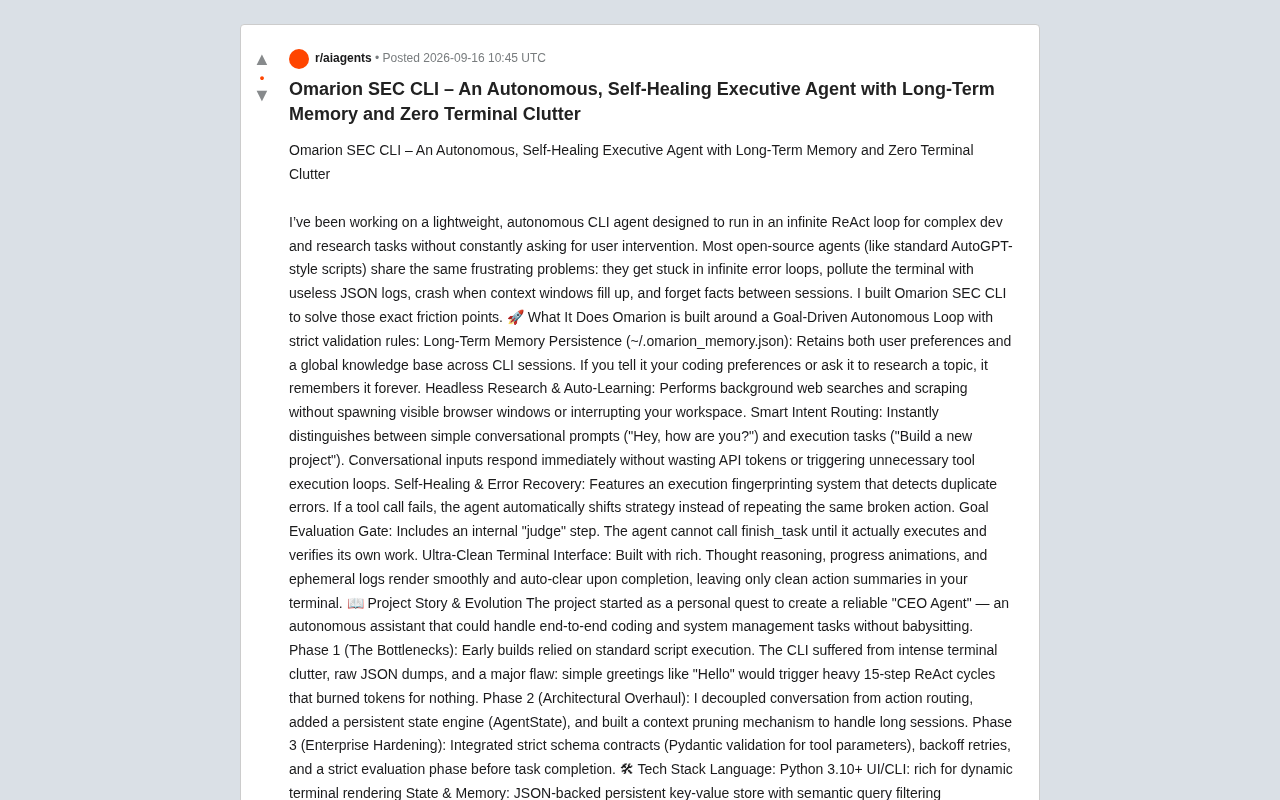
Omarion SEC CLI:自愈式自主智能体如何解决AutoGPT顽疾
Omarion SEC CLI 是一款开源自主命令行智能体,通过长期记忆、执行指纹自愈、目标评估门和意图路由,解决 AutoGPT 类工具的错误循环、终端杂乱与会话失忆问题。本文解析其架构设计与三阶段演进。