AI智能体真懂计算机架构吗?AutoTuring揭示"理解"与"搜索"之别
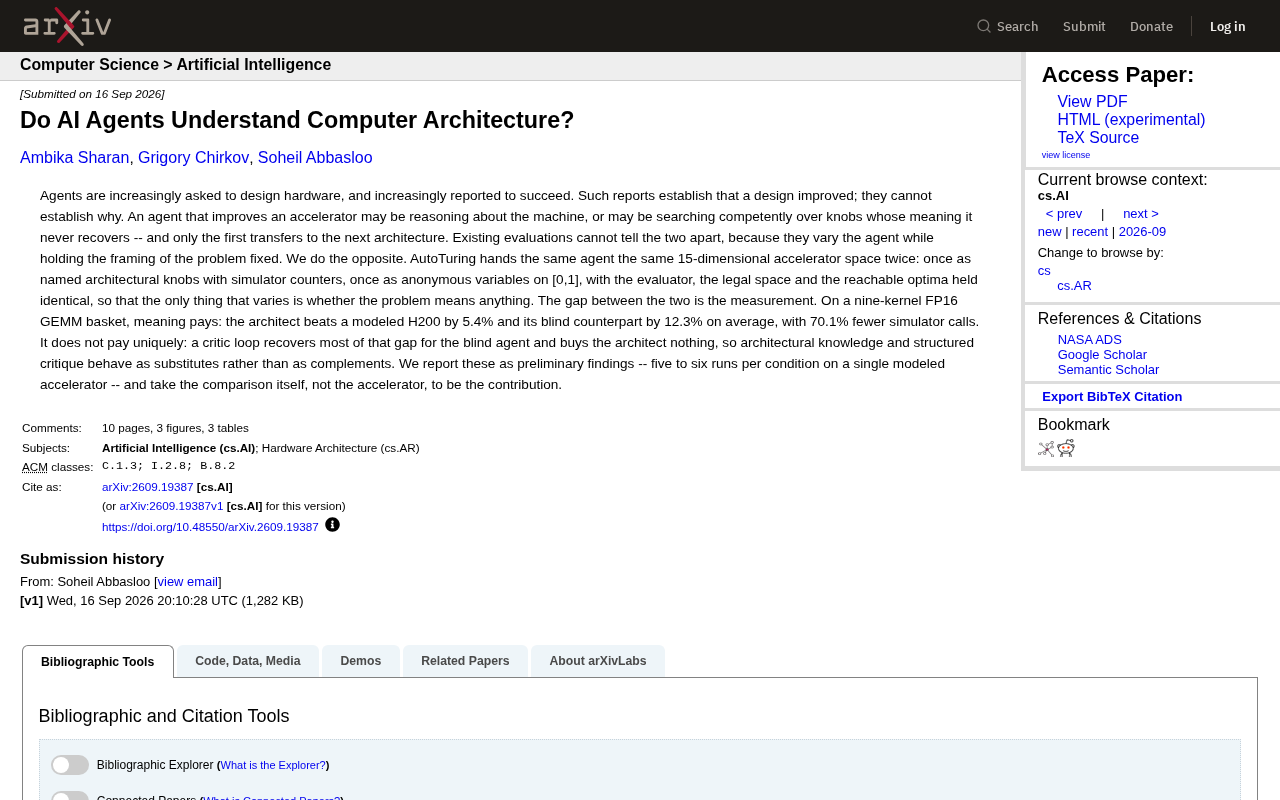
AutoTuring框架通过变换问题语义而非智能体,首次量化了AI在硬件设计中"真理解"与"盲搜索"的差距。
一篇arXiv论文提出AutoTuring框架,直指当前AI硬件设计评估的核心盲点:现有方法只能证明设计变好了,却无法判断AI是真正理解了架构还是在盲目搜索参数。AutoTuring的做法是固定智能体,将同一个15维加速器设计空间分别以"有语义的架构旋钮"和"匿名变量"两种形式呈现,通过两者的性能差距来量化"理解的价值"。实验显示架构师模式比盲测模式高出12.3%、减少70.1%模拟器调用,证明语义理解确有收益;但同时发现,给盲测智能体添加结构化"批评循环"后,大部分差距得以弥补,说明领域知识与自我批判机制之间是替代关系而非互补关系。研究者明确指出核心贡献是这套对比方法论本身,为评估AI能力的可迁移性提供了可复制的实验范式。
一个被忽略的问题:AI改进了硬件,但它真的"懂"吗?
AI智能体正越来越多地被用于硬件设计,而且不断有报告称它们取得了成功。但一篇最新的arXiv论文提出了一个尖锐的问题:这些成功报告只能证明"设计变好了",却无法证明"为什么变好"。
这背后隐藏着一个关键区分。一个改进了加速器(accelerator)的智能体,可能真的在对机器进行推理——理解每个参数的物理含义与因果关系;也可能只是在一堆它从未真正理解的旋钮上进行高效的盲目搜索。两者的差别至关重要:只有前者能够迁移到下一个架构。如果智能体只是在碰运气式地调参,那么换一个新硬件平台,它此前积累的"经验"将毫无价值。
问题在于,现有的评估方法根本无法区分这两种情况。它们通常的做法是——变换智能体本身,却保持问题的表述框架不变。这就像用不同的学生做同一套已知答案框架的题,你无法判断谁是真懂、谁是套路。
AutoTuring 的巧妙设计:把同一个问题"变形"两次
这篇论文提出的 AutoTuring 框架做了一件相反的事情:固定智能体,变换问题的表述框架。
具体做法是把同一个15维的加速器设计空间交给同一个智能体两次:
- 第一次(架构师模式):这些维度以有명명的架构旋钮(named architectural knobs)形式呈现,并附带模拟器计数器(simulator counters)。智能体能看到每个参数代表什么物理含义。
- 第二次(盲测模式):同样的维度被伪装成 [0,1] 区间上的匿名变量(anonymous variables),智能体完全不知道自己在调什么。
关键在于,评估器、合法空间、可达最优解在两种模式下完全相同。唯一变化的变量,就是"这个问题对智能体而言是否有意义"。两种模式之间的性能差距,正是研究者所要测量的"理解的价值"。
这种设计的精妙之处在于,它把一个难以量化的哲学问题——"AI是否理解架构"——转化成了一个可测量的实验对照。差距本身,就是答案。
这里的"15维加速器设计空间"指的是一个硬件加速器(如深度学习推理芯片)中可调节的15个关键参数组合,例如片上缓存大小、数据通路位宽、流水线级数、内存带宽分配等。每一维度都对应着具体的物理与工程权衡,例如增大缓存会提升数据复用率但同时占用更多硅面积和功耗。有命名的架构旋钮(named architectural knobs)意味着智能体能看到参数名称如"L2_cache_size=256KB",并通过模拟器反馈的性能计数器(如缓存命中率、内存访问延迟)推理因果关系。而匿名化后,相同的参数仅呈现为x₁=0.37、x₂=0.81等无语义的浮点数,智能体只能将优化视为纯粹的黑盒函数搜索问题。
实验结果:理解确实有用,但并非不可替代
研究者在一个九核 FP16 GEMM(半精度通用矩阵乘法)测试集上进行了实验,得到了几个耐人寻味的结论。
理解带来了实实在在的收益
在"架构师模式"下,智能体的表现显著优于盲测。数据显示:
- 架构师模式比一个建模的 H200 加速器平均高出 5.4%;
- 比其盲测版本平均高出 12.3%;
- 同时减少了 70.1% 的模拟器调用次数。
这意味着,当智能体理解参数的架构含义时,它不仅能找到更好的设计,还能用更少的探索代价达到目标。"意义"确实是有回报的(meaning pays)。
但这种收益并非独一无二
然而故事没有这么简单。研究者发现,如果给盲测智能体加上一个"批评循环"(critic loop)——一种结构化的自我反思与批判机制——它能够追回大部分本来落后的差距。而同样的批评循环加在架构师模式上,几乎没有带来额外收益。
这引出了一个重要洞察:架构知识与结构化批判之间是替代关系,而非互补关系。换句话说,让AI"真懂架构"和让AI"会自我反思批判",在提升硬件设计效果上,某种程度上是可以互相替代的两条路径。你不需要两者兼备。
"批评循环"(critic loop)是一种让AI智能体对自身输出进行结构化自我审查的机制,常见于基于大语言模型的智能体系统中。其基本流程是:智能体先产生一个设计方案,然后由同一模型(或另一角色的实例)对该方案提出明确的批评意见——例如识别哪些参数选择可能次优、哪些约束可能被违反——最后再根据批评进行修订迭代。这类机制与强化学习中的"演员-评论家"架构在概念上有相通之处,但通常完全在语言空间内运作,不依赖额外的训练信号。研究发现批评循环能弥补领域知识缺失带来的性能差距,暗示结构化自我反思可以在一定程度上模拟专家的启发式判断,这对理解大语言模型推理能力的本质具有重要意义。
GEMM(General Matrix Multiply,通用矩阵乘法)是深度学习中最核心的计算原语,卷积、注意力机制等操作在硬件实现层面大多可以归约为矩阵乘法。FP16指半精度浮点数格式,相比FP32(单精度)占用一半的内存带宽和存储空间,是现代AI训练与推理中广泛采用的数值格式,也是评估AI加速器性能的标准基准场景之一。H200是NVIDIA面向AI计算的高端GPU,以其作为参照基准,意味着论文在用业界顶级商业硬件的性能作为对照刻度来衡量智能体的设计结果,这使得"高出5.4%"这一数字具有较为直观的工程参考意义。
如何看待这项研究:方法论比结论更重要
研究者本人对结论保持了相当克制的态度,明确将这些标注为"初步发现"(preliminary findings):每种条件只跑了五到六次,且仅在单一建模加速器上验证。样本量偏小,结论的普适性还有待更大规模的实验检验。
更值得关注的是,作者明确表示,他们真正的贡献不是那个加速器,而是这种对比方法本身。
这一点在当前AI能力评估的语境下尤其有价值。随着AI智能体被用于越来越复杂的专业任务——芯片设计、科研、编程——我们迫切需要一套能够区分"真正理解"与"高效搜索"的评估工具。因为在很多场景下,一个只会搜索的智能体和一个真正理解的智能体,在单次任务上的表现可能难分伯仲,差异只会在迁移到新任务、新架构时才暴露出来。
AutoTuring 提供的思路——固定智能体、变换问题语义、测量两者差距——为这类"可迁移性"和"理解深度"的评估提供了一个可复制的范式。这或许比论文中任何一个具体的性能百分比都更有长远意义。
对AI Agent 发展的启示
这项研究给出了几个值得深思的方向。对于构建AI智能体的工程师而言,如果目标是让智能体的能力可迁移,那么单纯提升单任务性能可能是不够的——需要专门设计实验去验证智能体是否真的建立了对领域的因果理解。
同时,"批评循环可以替代领域知识"这一发现也具有实用价值:在难以为智能体注入充分领域知识的场景中,一个精心设计的自我批判机制或许能达到类似效果。这为资源受限下的智能体设计提供了另一条可行路径。
当然,鉴于实验规模的局限,这些结论都应被视为提示性的方向,而非定论。但它提出的核心问题——AI智能体究竟是在理解,还是在搜索——将在AI能力评估领域持续回响。
相关推荐
AAAI-27第一阶段评审结果临近:投稿者需关注什么
AAAI-27第一阶段(Phase 1)评审结果预计9月24日公布,本文解读AAAI分阶段评审机制、投稿者应对策略以及学术社区在结果等待期的协作价值。
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。