FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
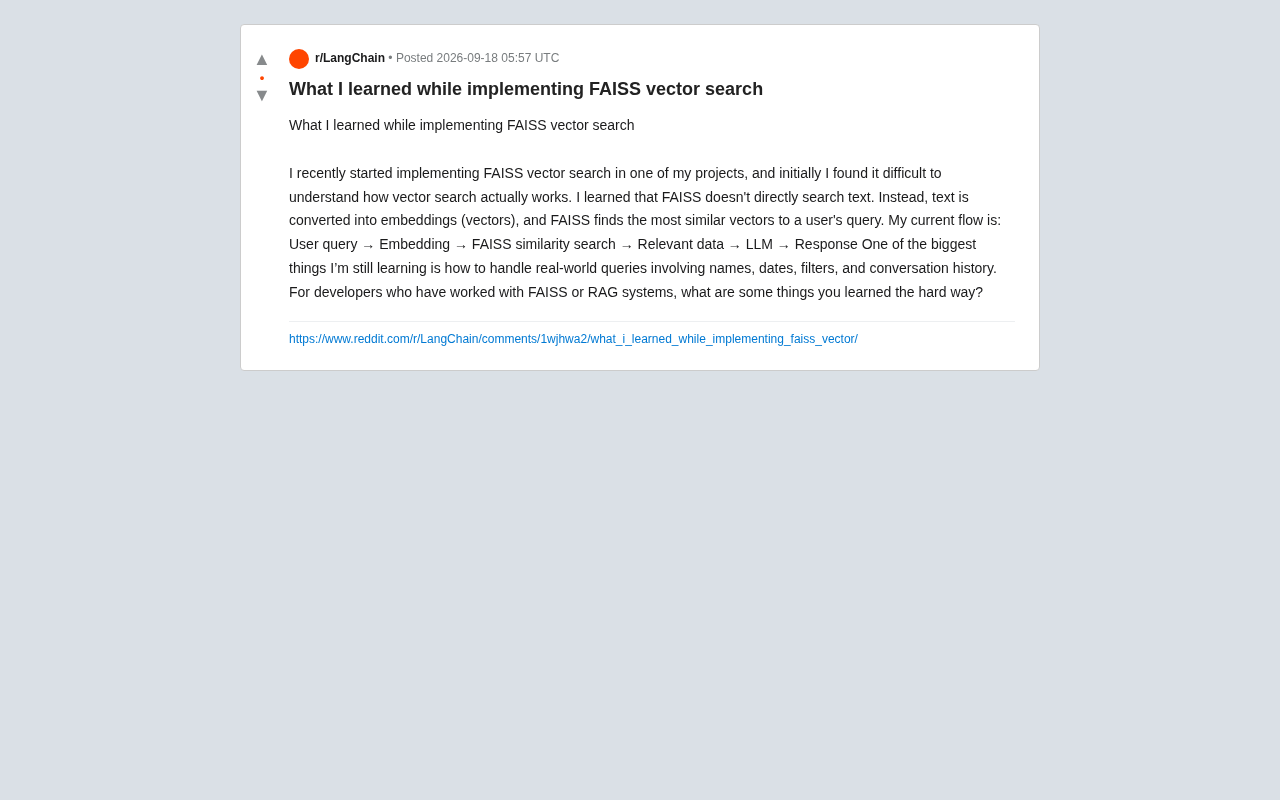
FAISS搜索的是向量而非文本,从跑通RAG流程到处理真实查询之间存在巨大工程鸿沟。
本文以一位开发者的实践经历为切入点,系统梳理了FAISS向量搜索的核心原理与RAG(检索增强生成)系统的标准数据流。文章指出,FAISS处理的是文本转换后的嵌入向量而非原始文字,这是理解语义检索的第一道门槛。典型RAG链路依次经过查询Embedding、FAISS相似度检索、上下文召回、LLM生成四个环节。然而真正的工程难点在于应对现实查询——人名、日期等精确信息需要元数据过滤,多轮对话中的指代问题需要查询重写。资深开发者的经验进一步指出,嵌入模型选择、文本分块策略、混合检索(向量+BM25)以及FAISS的工程局限性,都是从"能跑"走向"好用"必须直视的关键细节。
从零理解FAISS向量搜索
很多开发者在第一次接触向量搜索时都会感到困惑:它到底是怎么工作的?一位Reddit开发者分享了自己在项目中实现FAISS(Facebook AI Similarity Search)的经历,道出了一个关键认知——FAISS并不直接搜索文本。
它的核心逻辑是:文本先被转换成嵌入向量(embeddings),FAISS再在向量空间中寻找与用户查询最相似的向量。换句话说,FAISS处理的是数字,而不是文字。理解这一点,往往是入门RAG(检索增强生成)系统的第一道门槛。
这种基于语义相似度的检索方式,与传统的关键词匹配有本质区别。传统搜索依赖字面匹配,而向量搜索捕捉的是语义层面的接近程度——即便用户用了完全不同的词,只要意思相近,也能被检索出来。
嵌入向量(embeddings)是理解FAISS工作原理的基础概念。嵌入模型(如OpenAI的text-embedding-ada-002、开源的BGE或Sentence-BERT等)会将一段文本映射为一个高维浮点数数组,通常维度在256到1536之间。这个向量在数学上代表了文本的语义位置——语义相近的文本,其向量在高维空间中的距离也更近。FAISS的核心任务,就是在数百万乃至数十亿条这样的向量中,以极低延迟找出与查询向量距离最近的若干条。为了加速这一过程,FAISS提供了多种索引类型:IndexFlatL2是最简单的暴力精确搜索,IndexIVFFlat通过倒排文件将向量聚类后再搜索以换取速度,HNSW则基于图结构实现高效的近似最近邻搜索。不同索引类型在召回率、搜索速度和内存占用之间存在明显权衡,生产环境中通常需要根据数据规模和延迟要求来选择。
一个典型的RAG数据流
这位开发者梳理出了自己项目中的完整流程,这也是当下大多数RAG应用的标准范式:
用户查询 → Embedding → FAISS相似度搜索 → 相关数据 → LLM → 生成回答
拆解来看,每个环节都承担着明确的职责:
- 用户查询:原始的自然语言输入
- Embedding:通过嵌入模型将查询转为向量
- FAISS相似度搜索:在预先建好的向量索引中查找最接近的若干条结果
- 相关数据:检索出的上下文片段
- LLM:结合检索到的上下文生成最终回答
这个链路的精妙之处在于,它让大语言模型能够"引用"外部知识库,而不必把所有信息都塞进模型参数或有限的上下文窗口里。检索环节相当于给LLM配了一个可随时查阅的资料库。
真实场景才是难点所在
流程跑通只是开始。这位开发者坦言,自己仍在攻克的最大挑战,是如何处理现实世界中复杂的查询:人名、日期、过滤条件以及对话历史。
这恰恰击中了纯向量搜索的软肋。向量相似度擅长处理语义模糊的语义匹配,却对结构化、精确性要求高的信息力不从心。举几个典型场景:
精确匹配的困境
当用户查询涉及具体人名或日期时,纯语义检索可能返回"语义相近但事实不符"的结果。比如查询"张三在3月的报告",向量搜索可能召回其他人在其他月份的相似内容。这类需求往往需要**元数据过滤(metadata filtering)**来配合——先用结构化条件缩小范围,再做向量相似度排序。
元数据过滤(metadata filtering)是解决精确查询问题的标准工程手段。实现方式是在存储向量时,同步保存每条文档的结构化属性,例如作者、日期、部门、文档类型等字段。查询时先用这些字段做精确过滤,将候选集缩小到符合条件的子集,再在子集内做向量相似度排序。这种"先过滤、再检索"的模式通常被称为预过滤(pre-filtering)。纯FAISS本身不原生支持元数据管理,因此许多团队会选择Weaviate、Qdrant、Milvus等向量数据库,它们在FAISS类索引之上集成了元数据存储与过滤能力,也支持与传统数据库联动实现更复杂的混合查询逻辑。
对话历史的处理
多轮对话中,用户的当前问题常常依赖前文语境(比如"那它的价格呢?"中的"它"指代什么)。直接把这类省略式查询拿去做向量检索,效果通常很差。常见的解法是查询重写(query rewriting):在检索前,借助LLM将带指代的问题改写成完整、自包含的查询。
老手们的经验之谈
围绕这个话题,社区里有经验的RAG开发者通常会强调几个容易踩坑的地方:
嵌入模型的选择直接决定检索质量。 不同的embedding模型在特定领域的表现差异巨大,通用模型未必适合专业语料,必要时需要考虑领域微调。
分块(chunking)策略比想象中重要。 文本切分的粒度、是否保留重叠、是否携带元数据,都会显著影响召回效果。切得太碎会丢失上下文,切得太大又会引入噪声。
混合检索往往优于单一向量检索。 将向量搜索与传统的关键词检索(如BM25)结合,能同时兼顾语义理解和精确匹配的优势,这也是应对人名、日期等精确查询的实用方案。
FAISS本身只负责向量索引。 它不管元数据过滤、不管权限控制、也不管数据更新。这些工程能力需要在应用层自行搭建,或者借助更完整的向量数据库方案。
混合检索中提到的BM25是一种基于词频和逆文档频率的经典关键词排序算法,是TF-IDF的改进版本,至今仍是Elasticsearch等搜索引擎的默认相关性算法。它的优势在于对精确词汇匹配极为敏感,对人名、产品型号、代码片段等无法通过语义泛化的内容表现稳定。将BM25得分与向量相似度得分融合的过程通常被称为倒排融合(Reciprocal Rank Fusion,RRF)或加权混合,两种评分体系的量纲不同,需要归一化后再合并。这种混合方案在学术界和工业界的检索基准测试中,往往比单纯向量检索有5%到15%的召回率提升,是目前生产级RAG系统的主流选择。
写在最后
这位开发者的分享,虽然出发点朴素,却精准地勾勒出了RAG系统从"能跑"到"好用"之间的鸿沟。FAISS的向量检索解决了语义匹配的基础问题,但真正的工程复杂度,藏在人名、日期、过滤和对话历史这些"最后一公里"的细节里。
对于正在入门向量搜索的开发者来说,理解"FAISS搜的是向量不是文本"是第一步,而认识到"纯向量检索无法独立应对真实查询"则是走向生产级系统的关键一跃。
相关推荐
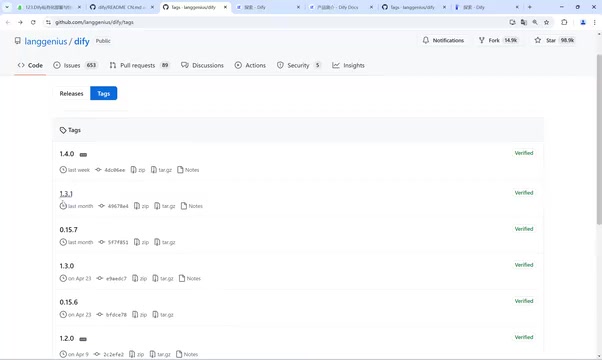
Dify 私有化部署完整教程:从零搭建 AI 应用平台
Dify 私有化部署完整教程,涵盖 Docker Compose 部署流程、大模型接入配置及第一个聊天应用搭建,帮助个人与企业零基础上手这款开源大语言模型应用开发平台。
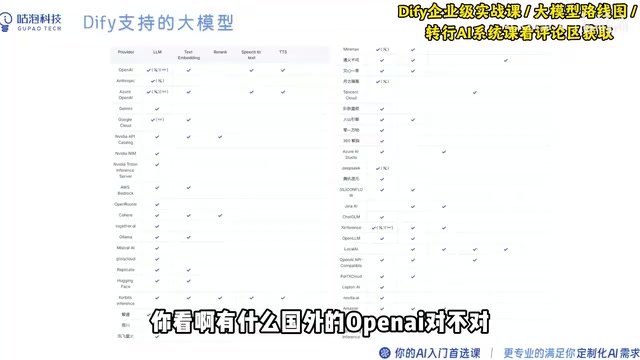
Dify本地部署全流程:从虚拟机到智能体搭建实操指南
Dify 本地部署完整教程,涵盖 VMware 虚拟机搭建、Ubuntu 22.04 系统安装、宝塔面板配置、Docker 部署 Dify 全流程,并附常见网络与镜像拉取故障的排查方法,帮助 AI 应用开发初学者快速跑通第一个 LLM 平台。
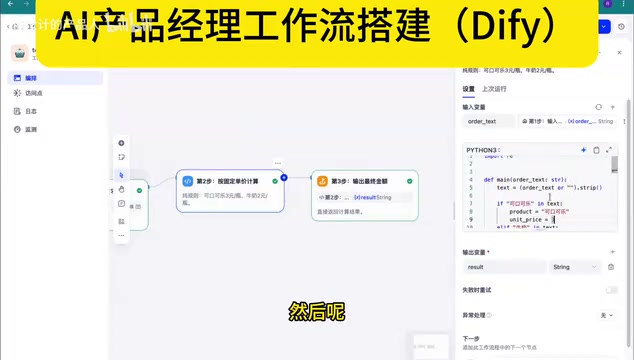
Dify工作流实战:AI产品经理如何用低代码搭建业务流程
本文基于B站AI产品经理实操课,系统讲解Dify工作流的核心概念、三层节点结构与安装部署,并通过买可乐和珠宝定制报价两个案例,拆解产品经理如何用低代码搭建业务流程,以及何时该用LLM节点或硬规则。