AI只引用竞品页面?用脚本做页面差异分析找出答案

用脚本抓取AI引用的竞品页面,对比结构性特征,找出并修复可控制的内容差距。
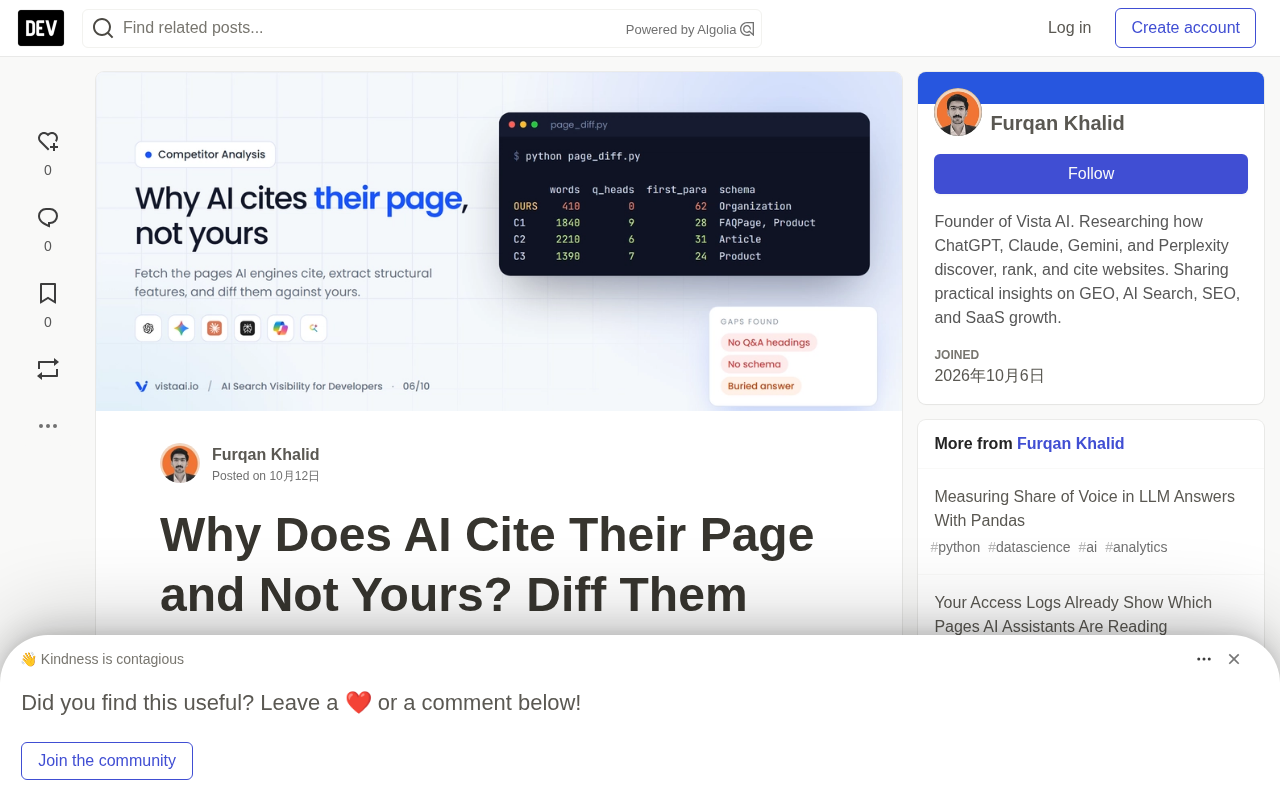
文章提出一套用脚本自动分析AI引用差距的方法:先定位品牌处于劣势的提示词簇,统计竞品被反复引用的URL,再以非JavaScript方式抓取原始HTML,提取字数、H2/H3数量、问句式标题、首段词数、表格列表、具体数字、JSON-LD类型、作者日期等特征,与自身页面做逐项对比。典型差异显示被引用页面篇幅是自身3-5倍、有大量问句式小标题、每段开门见山约25-30词、含更多具体数字与结构化数据。文章同时指出站外声誉、JS渲染和新鲜度是脚本盲区,强调把结果当作假设,通过"发现劣势→阅读被引用内容→弥补差距→重新测量"的循环持续优化。
当你测量品牌声量(share of voice)时,可能会发现某个提示词簇中竞品反复被AI推荐和引用,而你的页面始终缺席。直觉性的下一步是:他们的页面到底有什么不同?
大多数人的做法是打开两个浏览器标签页肉眼对比。这篇文章换一种方式——用脚本自动完成:抓取AI引擎在特定提示词下引用的URL,以非JavaScript爬虫的方式获取页面内容,提取对AI提取和引用有影响的特征,然后与你的页面输出差异对比。
这种方法不能解释一切。品牌声誉和第三方提及同样重要,而这些不会出现在页面HTML中。但它能可靠地捕捉到那些无聊的结构性差距——恰恰是最容易修复的部分。
第一步:获取被引用的URL
从存储的引用记录出发。找到你处于劣势的提示词,统计竞品被引用的URL频次:
import sqlite3, json
from collections import Counter

conn = sqlite3.connect("visibility.db")
rows = conn.execute("""
    SELECT r.sources FROM run r
    JOIN prompt p ON p.id = r.prompt_id
    WHERE p.topic = ? AND r.run_date >= date('now','-28 days')
""", ("analytics-pricing",)).fetchall()

counts = Counter(u for (s,) in rows for u in json.loads(s))
competitor_urls = [u for u, n in counts.most_common(10) if "acmeanalytics.com" not in u]
选择排名前3到5的被引用URL。被多次运行和多个引擎引用的页面才是信号,只被引用一次的URL是噪声。
为什么选择多次引用的URL
跨引擎、跨运行周期反复出现的引用说明该页面在检索系统中具有稳定的匹配度,而非偶然匹配。这种稳定性本身就是值得研究的特征。
第二步:模拟简单爬虫抓取
用不带JavaScript渲染的方式抓取原始HTML。如果页面内容需要JS才能显示,这本身就是一个发现:
import requests

UA = "Mozilla/5.0 (compatible; page-diff/0.1; +https://example.com/bot)"

def fetch(url: str) -> str:
    r = requests.get(url, headers={"User-Agent": UA}, timeout=20)
    r.raise_for_status()
    return r.text
使用诚实的User-Agent并保持极小的请求量。你只是在阅读少量公开页面,不是在做全站爬取。
第三步:提取对AI引用有影响的特征
检索系统将页面切分为段落、嵌入向量化,然后将最匹配的片段拉入模型上下文。因此值得测量的特征是:是否存在干净、自包含的答案段落,以及事实是否可被机器读取。
脚本提取的核心特征包括:
- 字数:主内容区域的纯文本词数
- H2/H3数量:页面结构的分段密度
- 问句式标题数量:以how/what/why等疑问词开头的标题
- 首段中位词数:每个H2下方第一段的词数中位数(衡量是否开门见山)
- 表格和列表数量:结构化数据的呈现方式
- 具体数字数量:文本中出现的数值、百分比、金额等
- JSON-LD类型:结构化数据的schema类型
- 是否有作者和日期:权威性信号
- 出站链接数:引用外部来源的情况
每个特征都是代理指标,有些比较粗糙。但这没关系——我们在做页面之间的横向对比,不是绝对评分。
什么是JSON-LD
JSON-LD(JavaScript Object Notation for Linked Data)是一种在网页中嵌入结构化数据的格式,通常放在<script type="application/ld+json">标签内。它用键值对的方式向搜索引擎和AI系统声明页面上"有什么"——比如这是一个FAQPage(含一组问答对)、一个Product(含价格、评分、库存)、一个Article(含作者、发布日期),而不是让模型从散落的HTML文本里猜测。
对AI检索系统而言,JSON-LD的价值在于把事实变成机器可读的字段。当模型需要回答"这个工具多少钱""有没有免费版"时,带Product/Offer schema的页面能直接给出结构化答案,而纯文本页面需要模型自己抽取、可能抽错或抽漏。这也是文章中竞品页面jsonld_types一栏出现[FAQPage, Organization, Product]等多项类型时更易被引用的重要原因。
第四步:输出差异对比
将所有URL的特征汇总为DataFrame进行对比:
import pandas as pd

ours = "https://acmeanalytics.com/pricing"
table = {url: features(fetch(url)) for url in [ours, *competitor_urls[:4]]}
df = pd.DataFrame(table).T
df.index = ["OURS"] + [f"C{i}" for i in range(1, len(df))]
print(df.to_string())
典型的输出差异会立刻让问题变得明显:
      words h2_h3 question_headings median_first_para_words tables lists numbers jsonld_types                     has_author has_date
OURS    410     4                 0                      62      0     2      11 [Organization]                   False      False
C1     1840    14                 9                      28      2     6      74 [FAQPage, Organization, Product]  True       True
C2     2210    17                 6                      31      1     8      91 [Article, BreadcrumbList]        True       True
C3     1390    11                 7                      24      3     4      58 [Product, SoftwareApplication]   False      True
差异分析通常揭示以下问题:
内容深度:被引用的页面篇幅是自身的3-5倍,这不是灌水——它们有11到17个内容区块。
问句式标题:竞品用小标题按照人们提问的方式组织内容,而自身页面完全没有。
答案前置:竞品每个章节开头用约25-30词的直接回答,自身页面开头是约60词的铺垫。
具体数据:更多的具体数字,以及对比表格。
机器可读的事实:Product/FAQPage schema、作者和日期标注。
特征背后的逻辑
这些差异之所以有效,是因为它们直接影响了检索系统能否从页面中提取出高质量的答案片段。一个410词的页面在检索系统中产生的可匹配段落数量远少于一个1840词的页面。问句式标题天然匹配用户的查询模式。答案前置确保关键信息出现在段落的开头位置,这是嵌入模型权重较高的区域。
为什么答案前置有效:嵌入模型的位置权重
检索系统通常把页面切成若干段落(chunk),对每段生成一个嵌入向量,再与用户查询比对相似度。一个段落往往取前若干字符作为代表——可能直接是首句,也可能是段首部分的平均。这意味着段落开头的词对最终向量贡献最大。
因此,把结论、定义或具体数字放在章节第一句,比先铺垫60词再给答案,更容易让这个段落被匹配到、被拉进模型上下文。竞品页面"每个H2下方首段约25-30词"的做法,本质是让每个小节的向量前部就携带高信息密度的答案,增大被检索命中的概率。反过来,若首段是一大堆"在当今快速变化的商业环境中"式的铺垫,段落向量就被稀释,即使正文后面有干货也很难被召回。
第五步:检查被引用的具体内容
特征告诉你页面有什么,被引用的文本告诉你引擎用了什么。如果你在存储引用时保存了cited_text,将它们与被引用的竞品页面对齐查看:
for url in competitor_urls[:3]:
    print("\n", url)
    for (s,) in conn.execute(
        "SELECT cited_text FROM citation WHERE url = ? AND cited_text IS NOT NULL LIMIT 5", (url,)):
        print("  -", s[:160])
你通常会发现引擎反复引用同样的两三个段落:一句带具体数字的定价描述、一行简洁的定义、一行对比表格。这些就是需要匹配或超越的段落目标。
差异分析的盲区
诚实地看待范围限制:
- 站外声誉:评论、论坛讨论、媒体报道和榜单中竞品被提及的情况。在依赖模型知识的引擎中,这些往往比页面特征更重要。
- JavaScript渲染内容:如果你的页面是客户端渲染的,原始抓取看到的内容少于浏览器。这本身有信息量(许多AI抓取器不渲染JS),但下结论前应与渲染后的版本对比。
- 新鲜度和权威性信号:引擎不公开这些因素的权重。
因此,将输出视为假设列表。发布修复后,观察接下来几周该提示词簇的引用率是否变化。

非JS爬虫视角与AI抓取器的关系
用requests直接获取HTML、不执行JavaScript,模拟的不只是"简单爬虫",而更接近许多AI检索系统的实际抓取方式。这类系统追求吞吐量和覆盖范围,通常不会为每个页面启动无头浏览器渲染,因此它们看到的就是服务器返回的原始HTML。
如果你的核心内容——定价表、FAQ、产品参数——依赖客户端JS在浏览器里渲染,那么在这类抓取器眼里页面就是空的或残缺的,即使真人用户打开完全正常。这正是文章强调"如果页面内容需要JS才能显示,这本身就是一个发现"的含义:它不是脚本的缺陷,而是暴露了真实的AI可见性短板。修复方向包括服务端渲染(SSR)、静态生成(SSG),或至少把关键内容以HTML形式内联,确保不执行JS也能读到。
自动化这个循环
手动运行适用于单个提示词簇。面对数十个簇和多个竞品时,需要持续运行。
无论使用什么工具,循环逻辑一致:找到劣势提示词 → 阅读被引用的替代内容 → 弥补具体差距 → 重新测量。
这个循环的价值不仅在于单次修复,而在于建立持续的内容优化机制。每次迭代都会积累关于竞品优势模式和自身薄弱环节的数据,让后续修复更加精准。
对于内容策略团队而言,可以将这个脚本方法作为定期审计的一部分,与品牌监测、搜索表现数据结合,形成完整的AI可见性视图。结构性的页面优化是你可以直接控制的部分,也是最快见效的部分——先用脚本解决这些确定性高的问题,再考虑站外声誉等长周期因素。
相关推荐

美国大学兄弟会该不该被禁?一位研究者的犀利观察
为什么不直接禁止美国大学兄弟会?一位研究者发现,关键阻力来自决策者自身的兄弟会身份认同,以及学校对兄弟会活动的"故意视而不见"。本文梳理禁令争议背后的结构性困境。

微软Discovery:用AI智能体加速科研发现
微软Discovery平台通过运行专用AI智能体,帮助科研人员从大量化合物和实验路径中筛选最有前景的候选方案并进行优先级排序,从而减少实验次数、加速科研发现。

剑桥重工秘密研发桌面级核聚变装置
Cambridge Heavy Industries正在秘密研发桌面级激光驱动核聚变装置,瞄准聚变发电厂的设备供应市场。本文分析其小型化技术路线、商业化逻辑及在聚变创业潮中的独特定位。