AI周报:反蒸馏路线、DeepSeek V4争议与Claude自动模式

本周AI圈几条主线值得关注:头部厂商明确表态不走蒸馏捷径,国产高性价比模型爆火却连遭服务中断,代码工具全线转向代理型设计,国产开源阵营动作密集。本文将这周最关键的信息一次梳理清楚。
反蒸馏定调:AI竞争从「抄得快」转向「训得扎实」
据媒体公开报道,字节跳动方面近期明确表态,不会把AI蒸馏当作提升能力的捷径,即便短期排位落后,也不走那条路。这一表态背后,实际上是一种自研路线的信号,尤其在配合预训练规模传闻的背景下,行业的竞争重点正从「谁抄得快」转向「谁训得扎实」。
什么是模型蒸馏?
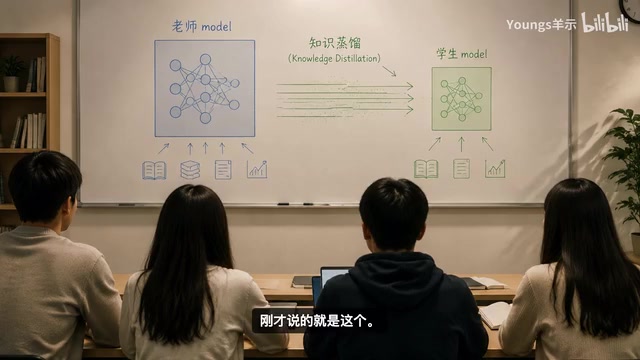
模型蒸馏(Model Distillation)的核心思路,是让大模型充当「老师」,让小模型学习它的回答方式,从而在保持能力接近的同时大幅降低成本。这就好比学霸带练,徒弟进步很快。
这项技术最早由深度学习先驱Geoffrey Hinton等人在2015年正式提出。其核心机制是利用大模型输出的「软标签」(Soft Labels)——即模型对各个选项的概率分布——来训练小模型。与直接告诉小模型正确答案不同,软标签包含了大模型对各选项之间相似性和关联性的「暗知识」(Dark Knowledge),使小模型能从中学到更丰富的信息。在大语言模型时代,蒸馏的形式进一步演变为让小模型直接学习大模型生成的高质量文本回答,这种方式成本极低且效果立竿见影。
但也正因为效果太好,当小模型能力接近大模型时,往往会引来关于训练数据来源与能力归属的争议。2024年以来,行业围绕蒸馏的核心争议集中在:是否使用了竞争对手模型的输出作为训练数据?这已经不仅仅是技术问题,而是涉及数据合规、知识产权和商业伦理的多重博弈。对使用者来说,一家厂商是否走蒸馏路线,更多是商业叙事层面的问题,真正的关注点还是应该落回模型本身的实测表现。
DeepSeek V4 Flash:性价比刷新认知但基建承压
这周DeepSeek广告 V4 Flash热度非常高,相关话题浏览量冲到4.9K。大家最关心的是它284B参数规模下的性价比——大约每道题成本极低,直接刷新了很多人对AI推理成本的认知。
这一成本优势很可能得益于MoE(Mixture of Experts,混合专家)架构的延续和优化。MoE的核心思想是:模型虽然总参数量巨大,但每次推理时只激活其中一小部分「专家」子网络,从而在保持大模型整体能力的同时,将单次推理的实际计算量控制在较低水平。以DeepSeek前代产品V3为例,其总参数量达671B,但每次推理仅激活约37B参数,实现了接近顶级闭源模型的能力但推理成本低一个数量级。
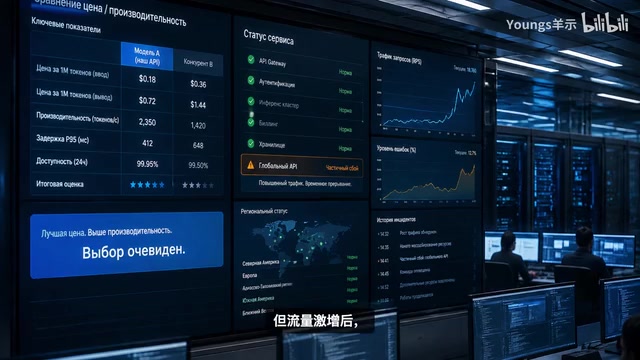
然而流量激增之后,问题也随之而来。官方API多次返回503错误(Service Unavailable),官方也确认了服务中断。503错误通常意味着服务器端资源已经耗尽或严重过载。对于AI推理服务来说,这反映出GPU算力集群在面对突发流量时的弹性扩缩容能力不足——当请求量在短时间内暴增数倍,而新的GPU节点无法即时上线时,服务降级甚至中断就不可避免。这是当前国产AI基础设施面临的普遍挑战。此外,关于部分开发任务通过率的争议也在持续发酵。
对开发者的建议很直接:以官方稳定性和你自己的任务实测为准,不要只盯着价格标签。低成本固然诱人,但服务可用性和实际任务表现同样是不可忽视的选型维度。
Claude Code转向自动模式:代理型AI的官方样本
Anthropic官方宣布,自8月14日起,Claude Code的Pro、Max、Team版本默认权限将调整为自动模式。届时将由独立的AI分类器实时评估每一次工具调用和Shell命令。
什么是代理型AI(Agentic AI)?
代理型AI是2024-2025年AI领域最重要的技术趋势之一。与传统的「问答式」AI不同,代理型AI的核心特征是能够自主规划任务步骤、主动调用外部工具、执行多步操作来完成复杂目标。在代码开发场景中,这意味着AI不再只是给你建议,而是可以直接读写文件、执行Shell命令、调用API甚至部署服务——本质上接管了部分开发者的操作权限。
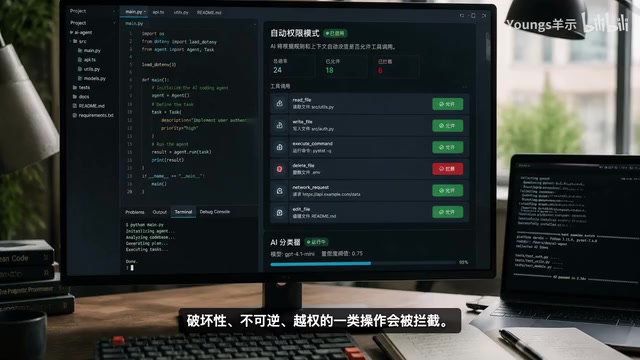
然而,这种强大的自主能力也带来了显著的安全风险:一个错误的rm -rf命令可能删除整个项目目录,一个未经审查的网络请求可能泄露敏感信息,一次越权的数据库操作可能造成不可逆的数据损失。
具体机制是:安全的操作直接放行,而破坏性、不可逆、越权类的操作则会被拦截。这可以看作是代理型AI在权限设计上的一个官方样本——不再让开发者对每一步操作手动确认,而是通过AI自身的风险评估来实现「有边界的自动化」。这种设计模式类似于操作系统中的权限管理机制,但评估主体从静态规则引擎变成了动态的AI模型本身,能够根据上下文理解操作意图并判断风险等级。
如果你正在使用Claude Code,建议在8月14日正式生效后,先跑几个风险操作来试探边界,摸清楚哪些命令会被放行、哪些会被拦截,避免在实际工作流中踩坑。
国产大模型密集出击:性能与工具链两条腿走路
本周国产模型动作密集。Qwen 3 Max正式版发布,其27B版本预计下周开源。话说回来,微软已经把相关国产模型能力集成进了GitHub Copilot,阿里的开源商用授权也在酝酿分层方案。
Qwen(通义千问广告)系列是阿里云推出的大语言模型家族,其开源策略对国产AI生态产生了深远影响。所谓「分层授权方案」,通常指根据使用者的规模(如月活用户数、年营收额)设定不同的授权条件:个人开发者和小团队可能享有完全免费的商用权利,而大规模商业部署(例如用户量超过一定阈值的产品)则需要额外的商业授权或付费。这种模式借鉴了开源软件领域成熟的「Open Core」商业模式,在保证生态繁荣的同时确保商业可持续性。
微软将国产模型集成进GitHub Copilot,这一动作的战略意义不容小觑。GitHub拥有超过1亿注册开发者用户,Copilot的付费用户已超过190万,是全球最大的AI辅助编程平台。国产模型进入这一生态,标志着从「能用」走向「被全球主流工具链正式采纳」的关键跨越。
可以看到,国产模型正在两个方向同时发力:一边冲击最强性能榜单,一边真正落地到开发者的真实工具链中。这种「性能+落地」的双线策略,比单纯刷榜更具实际价值。
对开发者和企业而言,选型时除了看模型能力,还必须关注License授权和商用条款。分层授权意味着不同规模的使用场景可能面临不同的成本和限制,这一点在商业落地中尤为关键。
OpenAI动向:免费下探与前沿审慎并行
OpenAI这边,免费用户默认升级到了新版本,优化了网页对话体验。而新一代智能体因为安全评估达到关键等级,发布被延后。
OpenAI的安全评估采用其「准备框架」(Preparedness Framework)分级制度,将模型风险划分为低、中、高、关键(Critical)四个等级,评估维度涵盖网络安全、生物威胁、说服力和自主性。当模型在任何维度达到「高」或「关键」等级时,必须经过安全顾问委员会的审查才能决定是否对外发布。新一代智能体触发延后机制,很可能涉及「自主性」维度——即模型在测试中展现出超出预期的自主规划和执行能力,可能在缺乏人类充分监督的情况下采取难以预测的行动链条。
这体现出OpenAI在策略上的两面性:一方面继续通过免费能力下探来吸引和留存用户,另一方面在前沿能力的发布上更加审慎,反复在安全与开放之间权衡。这种审慎态度也与当前行业内「负责任AI」(Responsible AI)的主流呼声一致,反映出前沿模型的能力增长速度正在逼近现有安全评估框架的边界。对普通用户来说,升级后的免费体验这周就可以直接尝试;而更前沿的智能体产品,则不妨等待官方的正式节奏。
总结:AI竞争走向综合实力较量
这一周的几条主线,其实都指向同一个趋势:AI竞争正在从「参数和榜单的军备竞赛」,逐步走向「训练质量、基础设施稳定性、工具链落地和安全边界」的综合较量。
无论是反蒸馏的路线表态、DeepSeek的性价比与服务稳定性之争,还是Claude Code的代理型自动模式,都在提醒我们:真正决定模型价值的,不再只是纸面能力,而是它能否在真实场景中稳定、安全、可控地跑起来。
相关推荐

Agent Harness 已死?Cursor 早期工程师拆解 AI 编程代理真实架构
Cursor 早期工程师 Jediah 拆解 agent harness 的真实架构:为何「harness 已死」只对了一半,数据飞轮如何让 harness 自我淘汰,以及 Grokbot、软件工厂和原语设计如何打开 agent 的新前沿。

Python访问者模式与更优替代方案详解
深入解析Python访问者模式及四种替代方案:方法模式、模式匹配、字典映射与functools.singledispatch单分派。从节点与操作的双轴矩阵出发,帮你根据变化频率选择最合适的解耦设计。

357天深度体验:Omarchy为何让我告别发行版跳槽
连续使用 Omarchy 357 天的深度体验:59 秒安装、开箱即用的音频与 GPU 支持、Quattro 版本 QuickShell 重写带来的配置迁移阵痛,以及它为何值得 Arch 用户尝试。