AI主权之争:硅谷巨头凭什么为全球定规则?
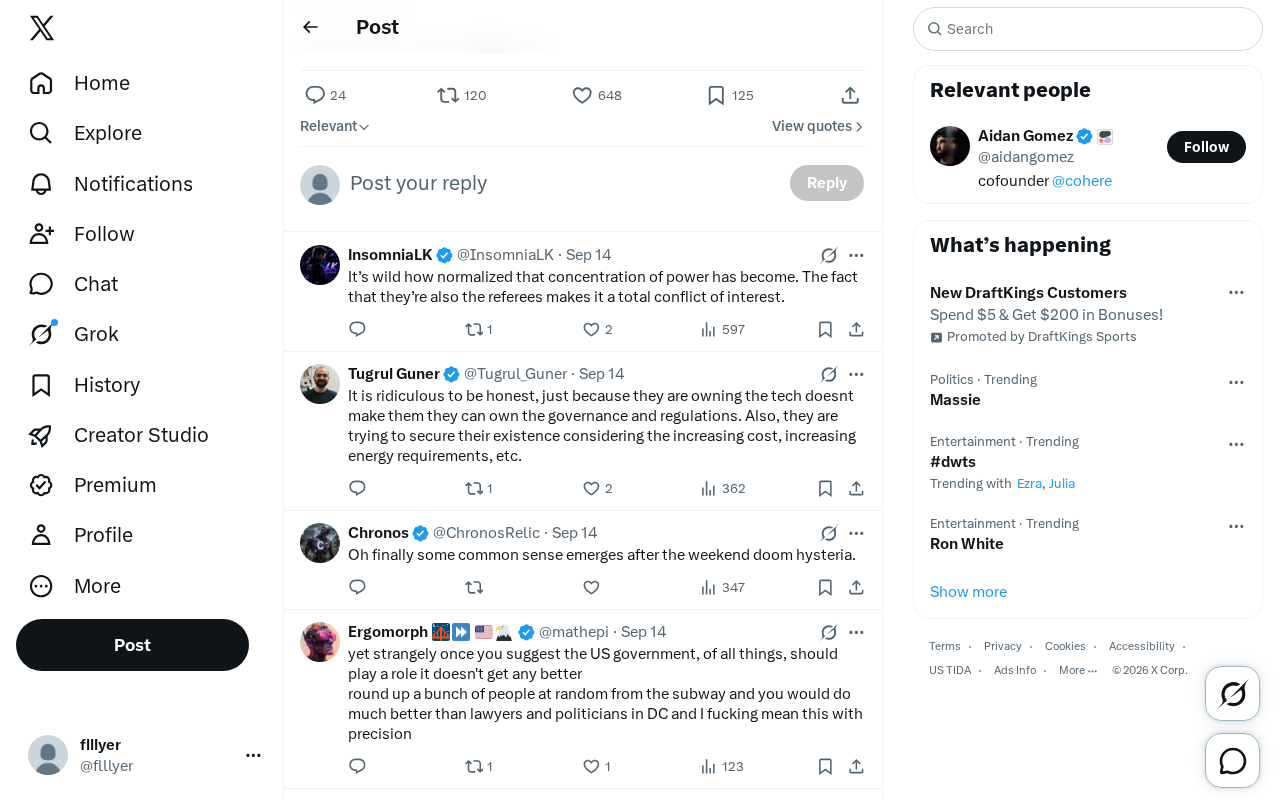
少数硅谷公司同时充当AI创造者、守门人和规则制定者,这一权力集中的合法性正受到全球性质疑。
一条Twitter短评以"说出口就站不住脚"概括了当前AI治理的核心矛盾:OpenAI、Google、Anthropic等少数硅谷公司,在事实上同时扮演着全球AI的创造者、守门人与规则制定者三重角色。这种三重权力集中打破了传统社会的权力制衡逻辑——模型的价值观取向、准入边界与安全标准,均由企业内部政策而非公共民主讨论决定。其合法性缺陷之所以长期未被正视,根源在于技术迭代速度远超监管与公共辩论的节奏,既成事实在沉默中固化。对此,越来越多的国家和地区正通过发展本土模型、拥抱开源生态以及推动主权立法(如欧盟《AI法案》)来夺回规则制定权。文章最终指向一个更深层的命题:AI是影响所有人的公共基础设施,其控制权的高度集中,无论出于何种善意,都构成对公共利益的潜在威胁。
一句话引爆的AI治理焦虑
一条来自Twitter的短评近日引发广泛讨论:"两三家硅谷公司同时充当全球每个政府的AI创造者、守门人和规则制定者——这个想法一旦说出口就站不住脚。"(The idea that two or three Silicon Valley companies should act as the creator, gatekeeper, and rulemaker of AI for every government on earth doesn't survive being said out loud.)
这句话之所以引发共鸣,是因为它精准戳中了当下AI产业最核心的结构性矛盾:一小撮位于加州的科技公司,正在事实上掌握着决定全球人工智能形态的权力。当一个国家的政务系统、教育体系乃至国防决策都开始依赖这些公司的模型时,"谁来制定规则"便不再是抽象的哲学问题。
三重身份的权力集中
这条评论的锋利之处,在于它拆解出了硅谷巨头同时扮演的三种角色,而这三种角色本应相互制衡。
创造者(creator):从底层大模型到应用层工具,OpenAI、Google、Anthropic等少数公司几乎垄断了最前沿模型的研发能力。训练一个顶级模型所需的算力、数据和人才门槛极高,这天然形成了寡头格局。
守门人(gatekeeper):这些公司通过API、内容审核策略、使用条款,决定了谁能用、能用来做什么。一个模型拒绝回答什么、允许生成什么,实际上是由企业的内部政策而非公共意志决定的。
规则制定者(rulemaker):更微妙的是,当各国政府缺乏自主技术能力时,往往只能接受这些公司事先设定好的安全标准、伦理边界和技术规范。规则的制定权,悄然从主权国家转移到了企业董事会。
当创造、准入、立法这三种权力集中于同一批主体,传统社会中的权力分立便无从谈起。
这种三重角色的集中在技术史上并非首次出现,但AI的特殊性在于其影响的广度与深度远超以往。早期互联网时代,搜索引擎和社交平台虽也形成了"平台即守门人"的格局,但彼时的监管工具(反垄断法、数据隐私法)尚能部分介入。大型语言模型(LLM)的情况更为复杂:模型的价值观取向、知识边界和安全机制嵌入在数千亿参数之中,难以被外部审计或独立验证,这使得外部监管的技术可行性本身就成为难题。更关键的是,当政府采购这些模型用于公共服务时,采购合同的细则往往远不足以约束企业对模型迭代、政策变更的单方面决定权。
为什么"说出口就站不住脚"
评论中"doesn't survive being said out loud"这一表述颇具分量。它暗示这种权力集中并非通过公开辩论和民主授权确立,而是在技术快速迭代的过程中默默形成的既成事实。一旦把它明确表述出来——即少数私营企业为全球主权政府制定AI规则——其合法性缺陷便暴露无遗。
这触及了AI治理的根本困境:技术发展的速度远超监管和公共讨论的速度。当社会还在争论时,格局已经固化。
AI主权正成为全球议题
这条评论呼应了近年来"AI主权"(AI Sovereignty)在全球范围内的兴起。越来越多的国家和地区意识到,将关键基础设施完全托付给外国私营公司蕴含着战略风险。
由此催生了几条应对路径:
- 发展本土模型:欧盟、印度、中东多国以及众多开源社区正推动本地化、可自主掌控的AI能力建设。
- 拥抱开源生态:开源模型被视为对抗少数巨头垄断的重要力量,它让技术能力得以分散和民主化。
- 强化主权监管:以欧盟《AI法案》为代表,各国试图通过立法夺回规则制定权,而非被动接受企业标准。
欧盟《AI法案》(EU AI Act)于2024年正式生效,是迄今为止全球首部综合性AI监管立法。该法案采用基于风险的分级管理框架,将AI应用按潜在危害程度划分为不可接受风险、高风险、有限风险和最低风险四类,并对高风险应用(如生物特征识别、关键基础设施管理、司法决策辅助等)规定了严格的透明度、可解释性与人工监督要求。值得注意的是,该法案同时设立了针对"通用人工智能模型"(GPAI)的专项规则,要求超过特定算力阈值的基础模型提供商披露训练数据摘要、遵守版权规范,并对具有"系统性风险"的超大规模模型实施强化义务。这一立法尝试代表了主权监管方向的重要实践,但其实际执行效力仍有待检验,尤其是对于总部位于欧盟管辖范围之外的企业。
开源生态在AI主权讨论中扮演的角色同样值得关注。以Meta发布的Llama系列为代表,开源大模型允许各国政府、研究机构和企业在本地部署、审计并微调模型,从根本上绕开了对特定商业API的依赖。然而开源并非万能解药:高性能模型的本地化运行仍需大量算力投入,且开源模型同样可能内嵌训练数据带来的偏见与风险,只是这些风险的责任归属变得更加分散。
一条推文背后的深层命题
必须承认,这条推文本身只是一句观点,并未提供系统论证或数据。但它的价值在于以极简的语言,把一个庞大而紧迫的公共议题浓缩成了可传播的一句话。
它提醒我们思考:AI不应只是一门生意,更是一种影响所有人的公共基础设施。当基础设施的控制权高度集中,无论出于何种善意,都构成对公共利益的潜在威胁。真正的解决之道,或许不在于指望巨头自我节制,而在于通过开源、竞争、国际协作和主权监管,重建一个多元制衡的AI权力结构。
相关推荐
Cursor是什么?AI编程工具与传统IDE的核心区别
Cursor是什么?本文详解这款内置AI助手的编程工具,对比它与VS Code等传统IDE在代码补全、生成、重构、错误处理上的核心区别,并分析Cursor集成Claude、DeepSeek等大模型的特性及适用人群。
Coze扣子3.0入门指南:智能体与AI应用全景解析
Coze扣子3.0入门教程:解析字节跳动AI开发平台的智能体、AI应用、工作流与插件体系,涵盖单Agent与多Agent协作,并对比Coze与Dify的差异,帮助零基础用户快速搭建AI智能体。
DeepSeek Harness 环境搭建:Node.js 安装与配置全流程
零基础搭建 DeepSeek Harness 运行环境的完整教程,涵盖 Node.js 安装、Add to PATH 勾选、npm 全局目录与缓存目录迁移,以及系统环境变量配置全流程,附常见踩坑提示。