AI自授学习:无需人类数据,模型自我进化新方法
以色列研究让AI无需人类数据自我教学,或破解训练数据瓶颈。
文章围绕 Reddit 社区披露的一项以色列研究展开,该研究声称能让 AI 模型在完全不使用人类生成数据的前提下实现自我教学。文章指出,当前大模型训练面临高质量公开数据见底、版权与隐私成本上升的困境,自授学习提供了一条不同于合成数据的新路径:模型生成候选数据,再通过严格筛选提取高价值样本回流训练。其核心难点在于避免“自噬”退化与模型崩溃。该方法与自对弈、自蒸馏同源,但彻底剔除了人类生成数据这一条件。若可规模化,将大幅降低中小团队训练专用模型的门槛;但完全脱离人类监督也带来偏离人类意图与对齐失效的风险,实际效果仍待多任务复现验证。
当AI开始“自学”:一场数据依赖的破局
据Reddit社区讨论,以色列研究人员开发出一种新方法,让AI模型能够在没有人类生成数据的情况下自我教学。这项研究直指当前大模型训练的一个核心痛点:高质量人类标注数据正变得越来越稀缺和昂贵。
传统AI训练依赖海量人类生成的内容——文本、图像、对话记录。但随着模型规模扩大,可供训练的优质公开数据逐渐见底,数据版权和隐私问题也日益突出。这项研究的价值在于,它尝试让模型从自身生成的内容中学习,形成一种“自授”(self-teaching)的循环。
自授学习如何绕开人类数据
核心思路:从自我生成到自我筛选
这类方法的通用逻辑是:模型先生成候选数据,再通过某种机制筛选出高质量样本用于训练。关键难点在于如何避免“自噬”导致的退化——如果模型只学自己产出的内容,错误会被放大,能力可能不升反降。
以色列团队的方法据称能在没有人类生成数据的前提下维持甚至提升模型能力。这意味着筛选机制的设计足够严格,能够从自我生成的内容中提取出真正有训练价值的信号。
与现有自对弈、自蒸馏路径的异同
自授学习并非全新概念。自对弈(self-play)在棋类AI中早已成熟,自蒸馏(self-distillation)也被用于模型压缩和能力迁移。这项工作的差异点在于完全剔除人类生成数据这一约束条件,把“自学”推向了更彻底的形态。
对于关注AI编程和AI应用的开发者而言,这条路径的吸引力在于:未来微调模型可能不再需要精心准备的人工标注数据集,模型可以在特定领域内通过自我迭代快速适应。
自对弈(self-play) 最早在棋类 AI 中成熟,AlphaGo Zero 是典型代表:模型与自己的历史版本对弈,通过胜负这一客观信号自动产生训练数据,无需人类棋谱。自蒸馏(self-distillation) 则是指模型把自身(或更大教师模型)的输出作为软标签来训练自己,常用于模型压缩和知识迁移。
这两条路径的共同点是都利用了模型自身产出的信号,但它们通常仍隐含人类数据的参与——例如自对弈需要人类定义规则和奖励,自蒸馏的教师模型往往由人类数据预训练而来。所谓“彻底剔除人类生成数据”,指的是在后续训练阶段不再引入新的人工标注样本,但基础模型本身仍是人类数据的产物,这一点在理解该方法的边界时值得注意。
对AI行业意味着什么
数据瓶颈的新解法
当前大模型竞赛中,数据质量直接决定模型上限。公开互联网数据被反复清洗使用,边际收益递减。自授学习提供了一种合成数据之外的新思路:不是用大模型生成数据喂给小模型,而是让模型在自我循环中持续进化。
如果这种方法可规模化,中小团队训练专用模型的门槛将显著降低——不再需要动辄数千条人工标注样本,节省的成本和时间是数量级的。
合成数据(synthetic data) 指由模型生成、用于训练其他(通常更小)模型的数据,近年来已成为应对数据枯竭的主流方案,典型做法是用强模型蒸馏弱模型。但它存在明显局限:合成数据的多样性受生成模型能力上限约束,且容易继承教师模型的偏差与盲区。
自授学习与合成数据的区别在于数据流向:合成数据是“强者教弱者”的单向传递,而自授学习是模型在同一主体内形成生成—筛选—再训练的闭环,理论上可以突破固定教师的能力天花板。不过两者并非互斥,实践中自授学习往往也需要借助合成数据管线中的过滤与去重技术来保证样本质量。
风险与待验证之处
需要冷静看待的是,Reddit讨论中的信息有限,研究的具体机制、适用场景和规模化效果尚未充分披露。自授学习的已知风险包括模型崩溃(model collapse)——多轮自我训练后输出多样性下降、错误累积。此外,完全脱离人类数据也可能让模型偏离人类意图,在需要对齐的场景中产生隐患。
这类方法的实际价值,取决于它能否在多个任务上稳定复现,以及在多大程度上可以替代人类数据的监督信号。
模型崩溃(model collapse) 是 2023 年前后被系统描述的一种退化现象:当生成模型反复用自己产出的数据训练后继模型时,训练分布会逐代收窄,稀有样本和长尾模式首先丢失,随后输出趋于同质化,最终甚至无法正确建模原始数据分布。研究显示,纯合成数据循环会导致模型对真实世界的覆盖能力持续衰减。
缓解思路通常包括:保留一定比例的真实人类数据、对自我生成样本做严格的质量与多样性筛选、引入外部验证信号(如可执行代码的单元测试、数学题的标准答案)。这也解释了为何“筛选机制”是该类方法成败的关键——筛选本质上是在替代人类监督,承担判断“什么是好数据”的职能。
展望:自我进化是终局还是补充
从趋势看,AI训练正在从“喂数据”转向“设计学习规则”。自授学习代表了一种方向:人类的工作从生产数据转变为设计让模型自我改进的机制。但这不意味着人类数据会消失——在需要精确对齐、领域知识和价值判断的场景中,人类监督仍然不可替代。
对开发者和研究者来说,值得关注的是这类方法何时能开源实现、在哪些任务上率先落地。如果验证有效,它可能成为合成数据管线之外的另一条重要技术分支。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
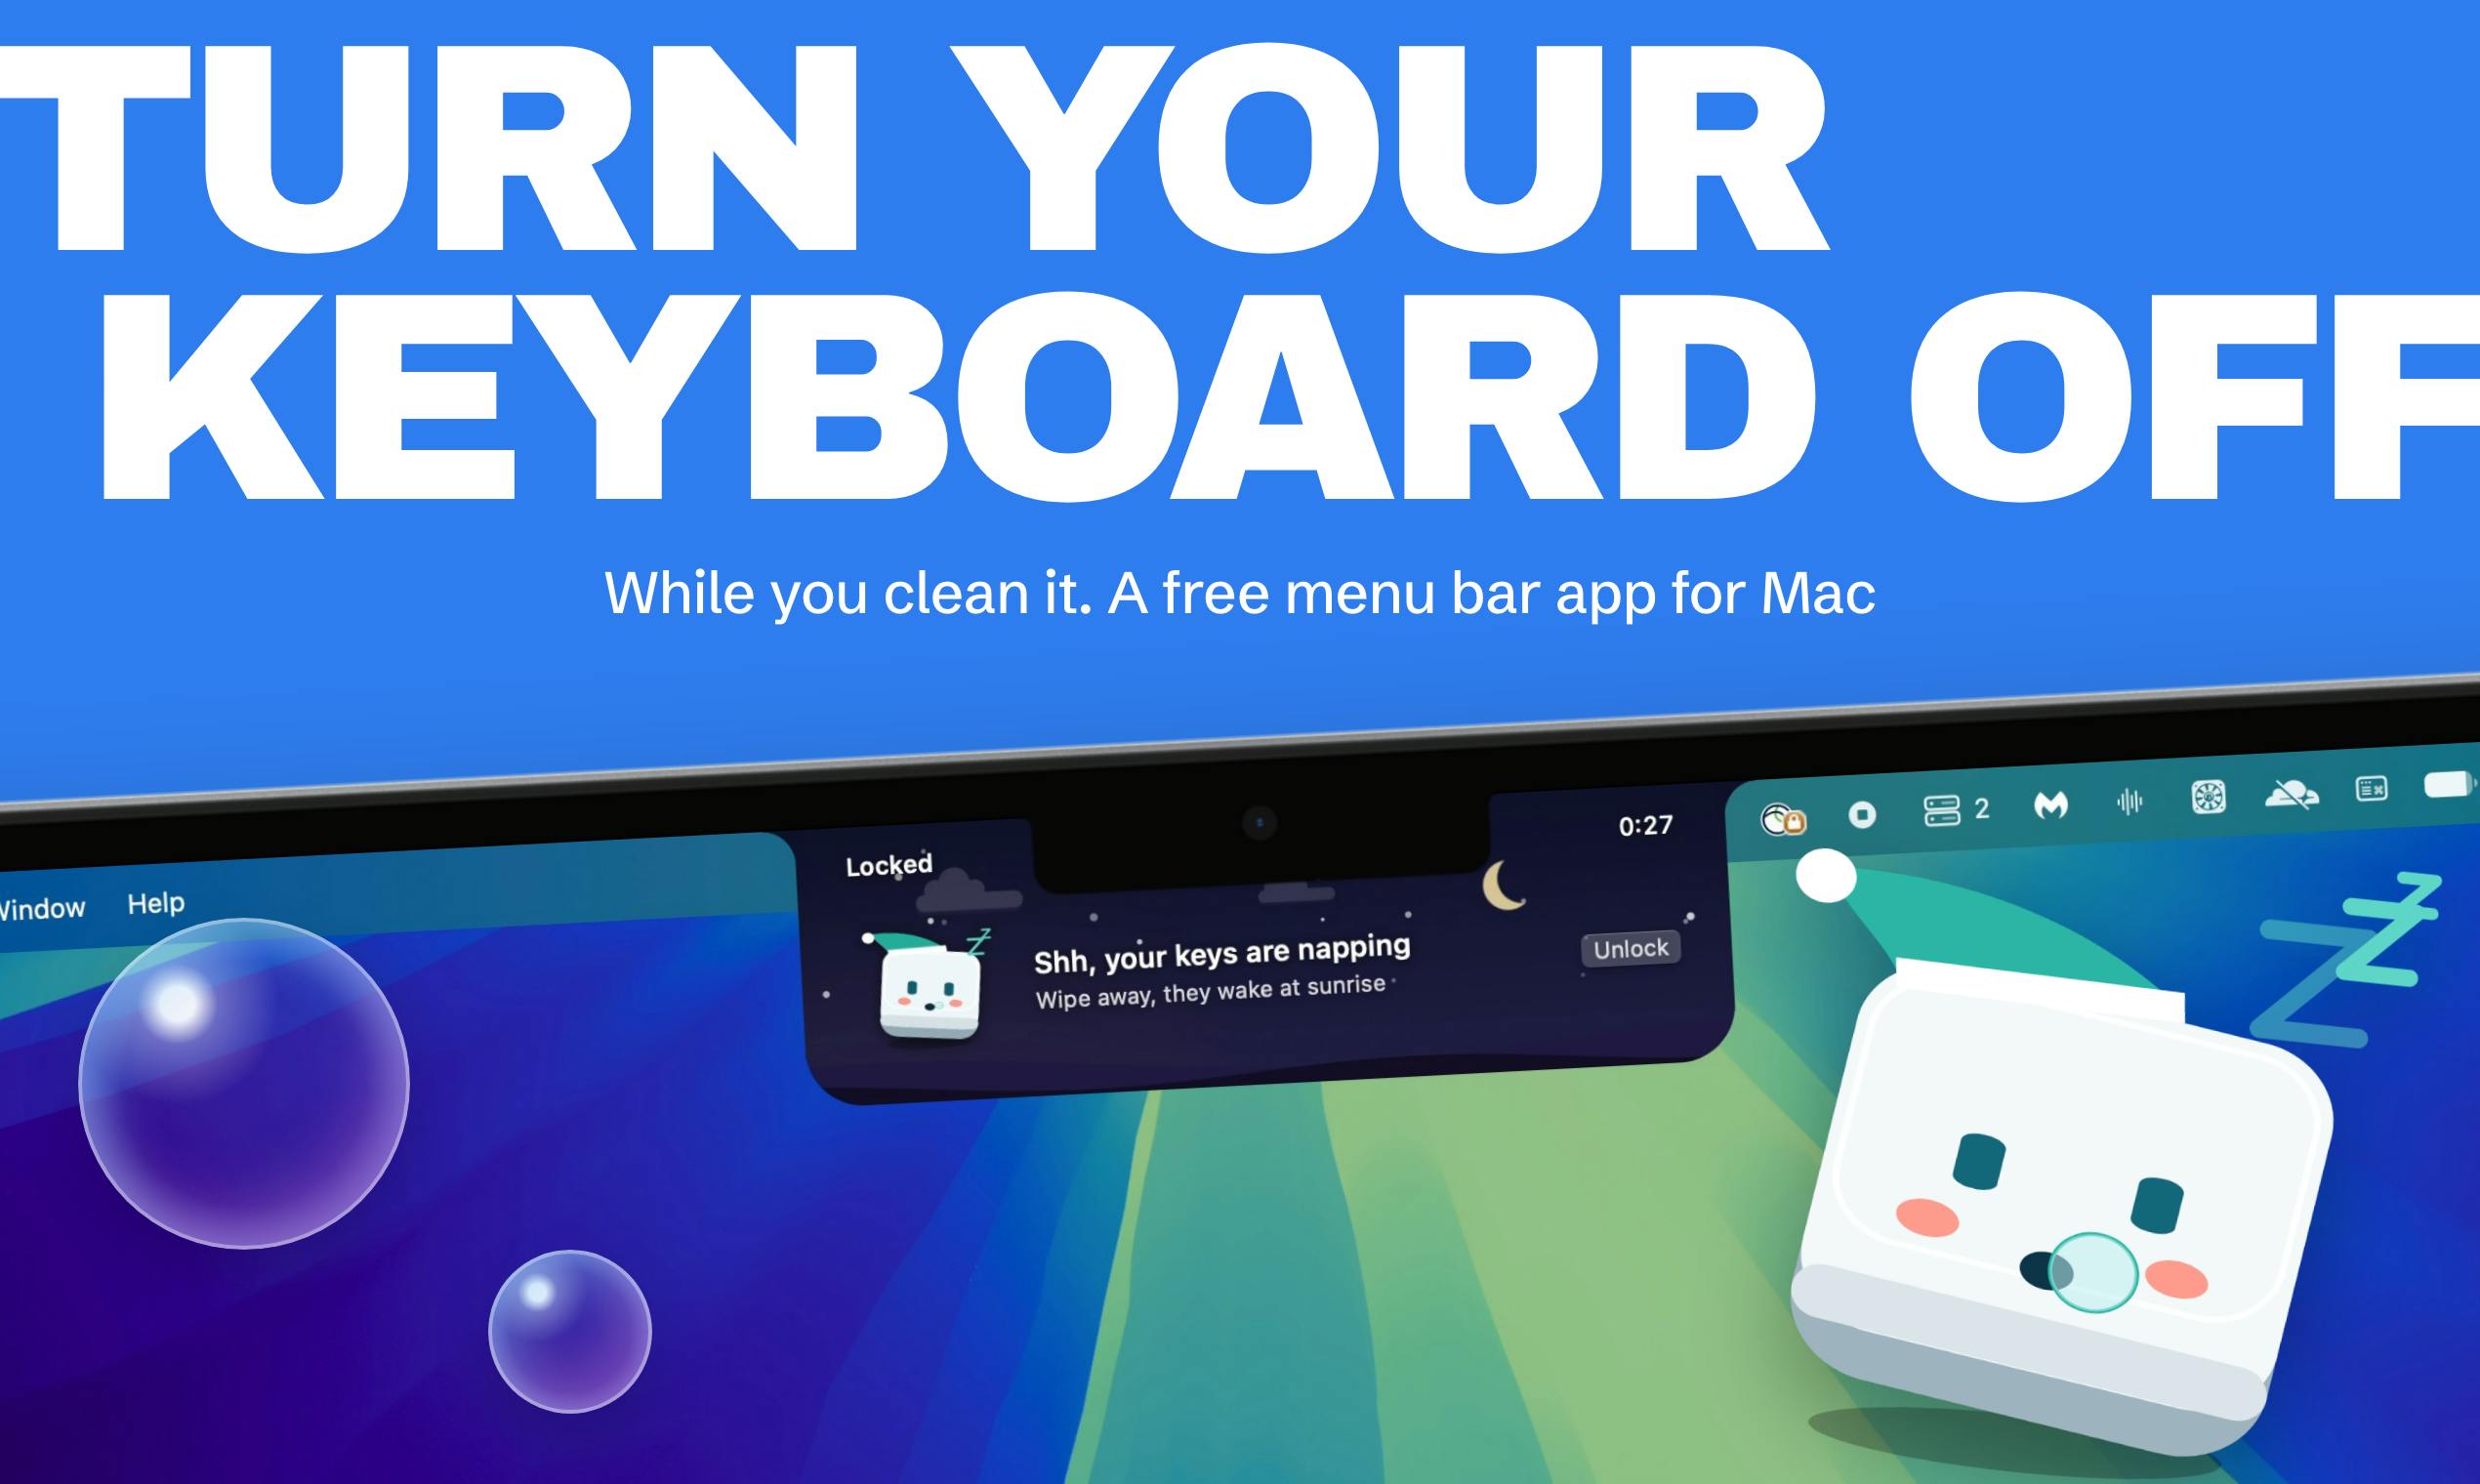
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。