AMD核显跑26B大模型实测:统一内存架构下全GPU推理与mmap优化指南

一个耐人寻味的实验
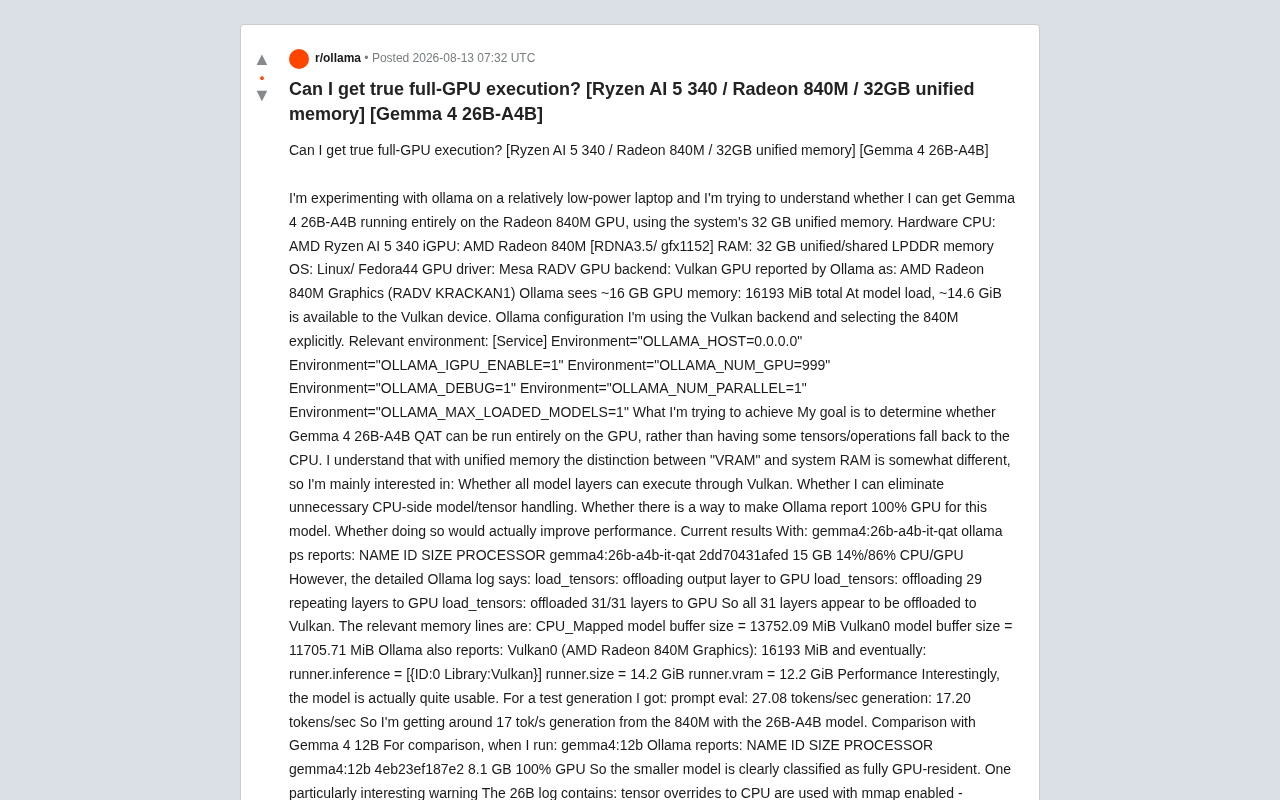
一位Reddit用户在自己的低功耗笔记本上做了一个颇具代表性的实验:能否让Gemma系列的26B-A4B模型(MoE架构,激活参数约4B)完全运行在AMD Radeon 840M核显上,借助系统的32GB统一内存(unified memory)。
这里需要先理解MoE(Mixture of Experts,混合专家)这一架构设计。MoE并非让所有参数同时参与每个token的计算,而是在模型内部设置了多个并行的"专家"子网络(Expert),并由一个轻量级的路由器(Router/Gate Network)根据输入动态选择其中少数几个专家进行计算。Gemma 26B-A4B中的"26B"代表模型总参数量为260亿,"A4B"则表示每次推理时实际激活(Active)的参数仅约40亿。这种稀疏激活策略的核心价值在于:模型可以拥有大参数量带来的知识容量和表达能力,同时将每次推理的实际计算量(FLOPs)控制在小模型的水平。这使得MoE架构成为在消费级硬件上运行"超出常规能力范围"模型的理想选择——你需要足够的内存来存放全部26B参数,但GPU只需要有算力处理4B参数级别的计算。
MoE架构的设计灵感源于人脑的功能分区——不同脑区负责处理不同类型的信息。在工程实现上,Google的Switch Transformer(2021年)是将MoE大规模引入语言模型的里程碑之作。Gemma 26B-A4B采用的是Top-K路由策略,即每个token只激活K个专家(通常K=2),其余专家保持休眠。这种设计带来一个有趣的推理特性:虽然模型的知识分布在26B参数中,但每个token的前向传播路径仅经过约4B参数的计算图,这意味着FLOPs与一个4B密集模型相当,而模型的知识容量却接近26B密集模型的水平。
这个问题看似简单,却触及了当下本地大模型部署中一个日益重要却常被误解的领域——基于APU统一内存架构的推理。随着AMD Ryzen AI系列处理器和苹果M系列芯片的普及,越来越多用户开始在没有独立显卡的设备上尝试运行大模型,而统一内存架构下的"GPU显存"概念,与传统独显有着本质区别。
在传统的独立显卡系统中,CPU使用系统内存(DDR4/DDR5),GPU拥有自己专属的高带宽显存(GDDR6/GDDR6X/HBM)。当大模型需要在GPU上推理时,模型权重必须通过PCIe总线从系统内存拷贝到显存中,这个过程存在明显的延迟和带宽瓶颈。而在统一内存架构(Unified Memory Architecture, UMA)中,CPU和GPU共享同一块物理内存池——无论是苹果M系列芯片的LPDDR5/5X,还是AMD APU搭配的LPDDR5。这种设计从根本上消除了CPU-GPU之间的数据搬运开销,GPU可以直接访问系统内存中的模型权重,无需经历"加载到显存"这一步骤。但这种架构的代价同样明显:LPDDR内存的带宽(通常为50-100 GB/s)远低于独立显卡的专属显存(如GDDR6X可达1 TB/s,HBM3e可达数TB/s),这使得内存带宽成为统一内存设备推理性能的核心瓶颈。
硬件配置一览
- CPU:AMD Ryzen AI 5 340
- iGPU:AMD Radeon 840M(RDNA 3.5 / gfx1152)
- 内存:32GB 统一/共享 LPDDR
- 系统:Fedora 44 Linux
- 驱动/后端:Mesa RADV + Vulkan
这里值得展开说明几个关键技术组件。AMD Radeon 840M基于RDNA 3.5架构(内部代号gfx1152),这是AMD最新一代面向移动端和集成显卡的GPU微架构。相比RDNA 3,RDNA 3.5在能效比和AI推理方面有针对性的优化,尽管其计算单元(CU)数量有限,但对于MoE模型这类每次推理计算量较小的场景,算力往往不是瓶颈。
RDNA 3.5是AMD在2024年推出的GPU微架构迭代,主要面向Ryzen AI 300系列(代号Strix Point)中的集成显卡。相比桌面级的RDNA 3,RDNA 3.5在Compute Unit设计上进行了面积和功耗优化,同时改善了对INT8/INT4等低精度数据类型的支持。Radeon 840M通常配备4个CU(256个流处理器),理论FP16算力约4-5 TOPS,看似微不足道,但对于MoE模型中仅4B激活参数的计算量而言,算力并非主要瓶颈。值得注意的是,AMD Ryzen AI系列处理器还集成了专用的NPU(XDNA架构),但当前llama.cpp等主流推理框架尚未充分利用NPU,因此GPU(iGPU)仍是这类设备上最实际的AI推理加速路径。
在软件栈方面,这套配置使用了完全开源的图形驱动方案:Mesa是Linux下最主流的开源图形驱动框架,RADV是其中针对AMD GPU的Vulkan驱动实现。Vulkan则是由Khronos Group维护的低开销、跨平台的图形和计算API,它比OpenGL提供了更细粒度的硬件控制,近年来也被llama.cpp等推理框架采用作为GPU计算后端。与NVIDIA的CUDA生态不同,Vulkan是一个开放标准,使得AMD、Intel甚至移动端GPU都能通过统一的接口进行通用计算(GPGPU),这对于非NVIDIA硬件上的大模型推理至关重要。
Vulkan自2016年发布以来,逐渐从纯图形渲染API发展为通用计算的重要平台。对于大模型推理而言,Vulkan的关键优势在于其跨厂商兼容性:同一套Vulkan计算着色器(Compute Shader)可以在AMD、Intel、NVIDIA乃至高通的GPU上运行,无需为每个硬件平台维护独立的后端代码。llama.cpp在2023年底引入了Vulkan后端支持,使得大量非NVIDIA用户首次获得了GPU加速推理的能力。相比之下,CUDA虽然性能优化更成熟、生态更丰富,但完全锁定在NVIDIA硬件上。AMD自己的ROCm计算栈虽然也是开源的,但对消费级GPU和集成显卡的支持一直不够稳定,尤其在Linux桌面环境中,Mesa RADV + Vulkan的组合往往比ROCm更可靠、更易配置。
在这套配置下,Ollama将840M识别为拥有约16GB显存(16193 MiB),模型加载时约14.6 GiB可供Vulkan设备使用。
核心矛盾:31/31层已卸载到GPU,为何还显示14% CPU?
实验中最让人困惑的现象是这样的:ollama ps命令报告模型为 14%/86% CPU/GPU,看起来有相当一部分计算还在CPU上跑。
但详细的加载日志却清楚地写着:
load_tensors: offloading output layer to GPU
load_tensors: offloading 29 repeating layers to GPU
load_tensors: offloaded 31/31 layers to GPU
所有31层都被卸载到了Vulkan(GPU)。这两个信息看似矛盾,实则揭示了Ollama在统一内存架构下内存统计方式的关键细节。
内存缓冲区的双重记账机制
日志中的两行数据是理解问题的钥匙:
CPU_Mapped model buffer size = 13752.09 MiB
Vulkan0 model buffer size    = 11705.71 MiB
在统一内存系统中,这种"双份"缓冲区记账其实是正常现象。由于CPU和GPU共享同一块物理内存,llama.cpp在使用mmap(内存映射)加载模型权重时,会将权重先映射到CPU可访问的地址空间(即CPU_Mapped部分),再由Vulkan后端访问。
这意味着**CPU_Mapped并不代表这部分计算发生在CPU上**,而更多是内存映射的记账方式。ollama ps中的"14% CPU"很可能正是源于这部分被mmap映射、由CPU侧地址空间持有的张量缓冲区,而非真正的CPU计算负载。
mmap警告:统一内存架构下的性能瓶颈
26B模型的日志中出现了一条关键警告:
tensor overrides to CPU are used with mmap enabled
- consider using --no-mmap for better performance
这条提示直指mmap可能是那14% CPU占比的来源。
mmap(memory-mapped file,内存映射文件)是操作系统提供的一种机制,它将磁盘上的文件直接映射到进程的虚拟地址空间,使程序可以像访问内存一样访问文件内容。在大模型推理中,mmap被广泛用于加载GGUF格式的模型权重文件:它允许操作系统按需(lazily)将模型数据从磁盘加载到物理内存中,而不是一次性将整个模型文件读入内存。这在独显场景下特别有用——当模型太大无法完全放入GPU显存时,mmap允许部分权重保留在系统内存中(甚至回退到磁盘交换),CPU处理溢出的层,GPU处理已加载的层,实现一种灵活的"部分卸载"策略。
mmap的底层实现依赖于操作系统的虚拟内存子系统。当llama.cpp通过mmap加载一个15GB的GGUF模型文件时,操作系统并不会立即分配15GB的物理内存,而是在进程的虚拟地址空间中创建一个15GB的映射区域,并建立从虚拟页到磁盘文件偏移的映射关系。只有当程序实际访问某个虚拟地址时,才会触发页面错误(page fault),内核随之将对应的4KB(或更大的hugepage)页面从磁盘读入物理内存。这种惰性加载(lazy loading)机制在独显场景中非常有价值——它允许系统优雅地处理模型大于可用内存的情况,通过页面换入换出(swap in/out)实现"虚拟显存"效果。但对于统一内存架构,这种间接性意味着GPU通过Vulkan访问这些mmap区域时,可能需要额外的地址转换步骤,甚至触发不必要的CPU侧页表遍历(page table walk),引入微秒级的访问延迟。
然而,在统一内存架构下,mmap的优势大打折扣。由于CPU和GPU本就共享同一块物理内存,不存在"显存搬到系统内存"的问题。但mmap引入的间接寻址层——操作系统需要维护虚拟地址到物理地址的页表映射、处理可能的页面错误(page fault)、以及通过CPU侧的地址空间中转访问——反而可能产生额外的开销。具体来说,当模型体积逼近Vulkan设备报告的可用内存上限时,llama.cpp可能会将部分张量"溢出"到CPU_Mapped缓冲区中,通过mmap维护。这些张量虽然在物理上与GPU可访问的内存位于同一块LPDDR芯片上,但由于经过了CPU侧的地址空间和mmap机制,可能涉及额外的内存拷贝或地址转换开销。
如何在Ollama中关闭mmap提升推理性能?
原作者尝试寻找OLLAMA_NO_MMAP=1这样的环境变量,但发现它似乎不存在。实际上,Ollama对mmap的控制通常需要通过Modelfile中的参数或API请求参数来实现:
- 在Modelfile中添加:
PARAMETER use_mmap false - 或在API调用的options中设置:
"use_mmap": false
对于统一内存设备,关闭mmap往往能减少CPU侧的张量处理开销,让权重直接以GPU可访问的方式常驻内存,从而可能提升推理性能并让ollama ps更接近"100% GPU"的显示。关闭mmap后,模型权重会通过标准的内存分配(malloc)直接加载到内存中,Vulkan后端可以直接管理这些内存区域,避免了mmap带来的虚拟内存管理层开销。
与12B模型的性能对比
说个细节,当运行更小的gemma4:12b(8.1GB)时,Ollama明确报告为 100% GPU。这进一步印证了一个推测:26B模型之所以显示14% CPU,很可能是因为其15GB的体积逼近了Vulkan设备可用的约14.6 GiB上限,触发了mmap的溢出映射机制,而12B模型完全放得下,无需mmap回退。
换句话说,模型大小与可用GPU显存的比例关系,直接决定了内存管理策略,进而影响了这个百分比的显示。这也是统一内存架构下一个常见的"陷阱":虽然物理内存总量(32GB)远大于模型体积,但操作系统和Vulkan驱动分配给GPU的可用内存份额是有限的(本例中约为物理内存的一半,即16GB左右),超出这个份额的部分就会被记账为CPU_Mapped,触发与独显场景类似的"溢出"逻辑。
核显推理性能实测:17 tok/s的实用价值
实测数据相当亮眼:
- Prompt eval:27.08 tokens/sec
- Generation:17.20 tokens/sec
对于一颗核显跑26B(激活4B)的MoE模型而言,17 tok/s的生成速度已经完全可用。这得益于A4B架构——虽然总参数26B,但每次推理仅激活约4B参数,大幅降低了实际计算量。
那么这是840M的实际上限吗?答案是:可能还有提升空间。如果那14%的CPU映射张量确实带来了额外开销,通过关闭mmap,理论上可以榨出更多性能。但对于核显这类内存带宽受限的设备,最终瓶颈往往不在计算单元,而在LPDDR内存的带宽。
要理解这一点,需要了解大模型文本生成(decode阶段)的内存访问特征。在逐token生成时,每生成一个token,模型需要读取几乎全部的模型权重(对于MoE模型则是被激活专家的权重),但每个权重只参与极少量的计算(通常是与一个token的隐藏状态做矩阵-向量乘法)。这意味着decode阶段是一个极度受内存带宽限制(memory-bandwidth bound)的操作——GPU的计算单元大部分时间在等待数据从内存传输过来。对于本例中的LPDDR5内存,其带宽通常在50-90 GB/s范围内。以4B激活参数(Q4量化后约2-2.5GB)计算,理论上每秒最多可以读取模型权重约25-40次,对应25-40 tok/s的理论上限。实测的17 tok/s考虑到KV缓存读写、注意力计算等额外开销,已经是相当不错的成绩。
这里提到的量化技术对核显推理的实用性至关重要。量化将模型权重从FP16(每参数2字节)压缩到Q4(每参数约0.5字节)等低精度格式,同时减少了内存占用和带宽需求。以Q4_K_M量化为例,26B参数的模型从约52GB(FP16)压缩到约15GB,4B激活参数从约8GB压缩到约2-2.5GB。由于decode阶段的性能公式近似为 tok/s ≈ 内存带宽 / 每token需读取的字节数,更激进的量化直接转化为更高的推理速度。GGUF格式(由llama.cpp项目定义)支持多种量化方案的混合使用,允许对模型的不同层采用不同精度,在质量和速度间取得平衡。
KV缓存(Key-Value Cache)的影响也不容忽视。在逐token生成过程中,模型会缓存所有已处理token的Key和Value向量,避免重复计算。KV缓存的大小与上下文长度成正比:对于一个4B激活参数的模型,每1024 token的上下文大约需要数百MB的KV缓存空间。这部分内存开销必须从GPU可用内存中扣除,同时KV缓存的读写也消耗宝贵的LPDDR带宽——在注意力计算阶段,模型需要读取所有历史token的KV向量来计算当前token的注意力分数,这使得长上下文推理对内存带宽的压力更大。
因此提升幅度可能有限,17 tok/s大概率已接近该硬件的实用天花板。
给APU用户的本地大模型部署建议
综合这个案例,对于在AMD APU或统一内存设备上运行大模型的用户,可以总结出以下要点:
正确理解Ollama的GPU/CPU占比显示
ollama ps的百分比在统一内存架构下并不能直接等同于"计算负载分配"。只要日志显示offloaded N/N layers to GPU,就说明所有transformer层都在GPU上执行。这个百分比更多反映的是内存缓冲区的记账归属,而非实际的算力调度。在传统独显系统中,这个百分比通常能准确反映计算负载分配,但在统一内存架构下会产生误导——用户不必因为看到"14% CPU"就认为推理效率受到了严重影响。
优先尝试关闭mmap优化性能
对于逼近显存上限的大模型,通过PARAMETER use_mmap false关闭内存映射,通常能减少CPU侧开销。
关注模型大小与可用显存的比例
选择能完全放入可用GPU内存的模型(如本例中12B完美适配),可以避免mmap回退带来的复杂性。在实际选择模型时,建议留出10-15%的显存余量用于KV缓存和其他运行时开销。例如,本例中Vulkan报告14.6 GiB可用,那么模型文件大小控制在12-13 GiB以内会是较安全的选择。
内存带宽是核显推理的真正瓶颈
对于核显推理,LPDDR内存带宽是决定生成速度的核心因素。MoE架构(如A4B)通过减少激活参数,是这类设备运行大模型的理想选择。从硬件选购角度来看,选择支持更高频率LPDDR5X内存的平台(如8533MHz vs 6400MHz),对推理速度的提升可能比选择更多GPU计算单元更为显著。此外,双通道内存配置对于统一内存架构也至关重要——单通道配置会直接将可用带宽减半,严重影响推理性能。
结语
这个实验生动展示了统一内存架构下本地推理的独特性。传统上我们习惯于"独显VRAM vs 系统RAM"的二分思维,但在APU和统一内存时代,这种界限正在模糊。理解Ollama和llama.cpp的内存记账逻辑、合理配置mmap,是发挥这类硬件潜力的关键。
随着AMD Ryzen AI、苹果M系列等统一内存平台的普及,如何在这些设备上高效运行大模型,将成为越来越多开发者需要掌握的技能。而17 tok/s的Gemma 26B推理成绩,也证明了核显本地大模型部署已经具备了相当的实用价值。值得一提的是,这个领域的软件优化仍在快速迭代——llama.cpp和Ollama对统一内存架构的支持在不断改善,未来的驱动更新和框架优化有望进一步释放这类硬件的推理潜力。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。