Android Tracing 2.0:七倍提速与上下文传播的追踪革命

Android Tracing 2.0 重写底层,提速七倍并首次带来上下文传播与自定义元数据。
Android 的追踪 API 自 2012 年 Jelly Bean 引入 1.0 后十四年未实质演进,留下后端锁死 Atrace、128 字符标签限制、无法附加元数据和单次埋点约 1200 纳秒开销等包袱。Google 工程师 Rahul 介绍的 Tracing 2.0 从底层重写,调用方式几乎不变但性能提升七倍,且刻意规避了 Perfetto SDK 约四兆的 APK 体积代价。新版本为 Kotlin 协程提供开箱即用的上下文传播,并用 propagation token 覆盖回调加 executor 的老代码,使跨线程因果链得以保留;自定义元数据则让 Compose 1.13 的重组追踪能指出具体状态变更与调用栈。后端 sink 交还开发者,可对接 Perfetto 或 OpenTelemetry。Wyze 启动提速 45%、R8 优化提速 25%、Metalava 后提交时间缩短 15%,验证了追踪对工具链的反哺价值。
Android Tracing 2.0:七倍提速与上下文传播的追踪革命
Android 的追踪 API 自 Jelly Bean 时代引入 1.0 版本以来,已经超过十四年没有实质演进。Google Android 开发者体验团队的工程师 Rahul 在技术演讲中系统回顾了这套 API 的历史包袱,并详细介绍了全新的 Tracing 2.0——一个从底层重写、性能提升七倍、且首次把上下文传播和自定义元数据带给应用开发者的追踪库。
先厘清概念:追踪与性能分析不是一回事
Rahul 在开场特意建立了一套共享词汇。他所说的 tracing 指的是显式追踪——手动在代码中埋点,让系统知道你正在做什么;而 profiling 则指自动化的性能分析器,比如 ART 方法追踪、SimplePerf 的栈采样,或者内存泄漏与堆分析。
两者定位不同。手动追踪是留在代码库里的面包屑,方便日后回答"当时到底发生了什么",它比日志更容易可视化、有明确的时长和结构,还能交给自动化工具甚至 AI 代理去分析。而自动性能分析通常是在问题已经暴露之后,用来缩小范围、定位瓶颈的手段。Rahul 强调,如果事先没有埋点,出问题时就得靠 profiler 补位,但两者的价值无法互相替代。
Atrace 是 Android 系统内置的追踪基础设施,全称 Android Trace,由 atrace 命令行工具和内核中的 ftrace 机制共同支撑。应用通过 Trace.beginSection() 等 API 写入的标记,最终都会落在 Atrace 维护的环形缓冲区里,并与系统层面的调度、binder 事务、图形渲染等事件混在一起,由 Perfetto 或 Systrace 统一解析展示。它的优势是与系统事件天然对齐,缺点是格式封闭、面向调试而非生产遥测——这也正是 Tracing 1.0 把后端锁死在 Atrace 后难以转向线上监控的根源。
Perfetto 则是 Google 主导的下一代系统级追踪平台,既包含设备端的守护进程与数据源,也提供跨平台的 trace 解析与可视化工具。它定义了开放的 Trace Protocol Buffer 格式,任何生产者都可以按此格式写入数据,再交给 Perfetto UI 或 trace_processor 查询分析。Tracing 2.0 官方提供的 sink 实现正是输出 Perfetto 兼容格式,这意味着应用自定义的追踪可以和系统 trace 在同一时间轴上对照解读。
1.0 的三大历史包袱
Tracing 1.0 于 2012 年随 Jelly Bean 引入,此后只在 Android 10 补充了异步事件和计数器,再没有实质更新。Rahul 指出这留下了几个硬伤:
- 后端被锁死:任何 trace 段都固定写入系统的 Atrace 缓冲区。想把追踪数据转成线上遥测,就得自己去啃 Atrace 的存储格式,成本极高。
- 标签长度限制:slice 名称被限制在 128 个字符以内,超长部分会被截断,而截断本身还带来额外开销。2012 年这个限制尚属合理,放到今天则显得格格不入。
- 元数据无处安放:除了名称,无法给 trace 附加任何额外信息,调试时只能把信息硬塞进名称里。
- 开销偏高:在 Pixel 6a 搭配 Android 16 的环境下,单次插入 begin/end 段约消耗 1200 纳秒。对于埋点密集的代码路径,这部分时间本可以用于渲染帧。
一个直观的例子是:当你想知道 initializeComponent 究竟初始化了哪个组件时,1.0 下唯一的办法是把组件名拼进 slice 名称,结果因长度限制被截断,还额外付出截断开销。
2.0 的 API 变化与性能账本
从调用方式看,Tracing 2.0 与 1.0 惊人地相似:从 androidx.tracing.trace 换成 tracer,从 trace 换成 tracer.global.trace,多了一个 category 参数,其余保持原样。但底层变化巨大。
性能方面,团队曾在 AndroidX Perfetto SDK 上做过实验,虽然大幅改善了状态,但因为它是带 JNI 绑定的 C SDK,会在 APK 里塞进约四兆的体积,团队从未打算让开发者直接发布它。Tracing 2.0 是专门构建的库,Rahul 给出的结论是快了七倍,留给应用自身逻辑的时间更多了。
这些性能红利在真实场景中迅速兑现。依赖注入库 Metro 通过 Kotlin 编译器插件集成 Tracing 2.0,让每一个 @Inject 的成本都可见。金融应用 Wyze 据此将应用启动速度提升了 45%,靠的是推迟启动阶段不必要的初始化,并发现了一些本应是单例却被错误作用域的绑定;从启动指标看,他们不仅改善了首帧时间,也改善了完全显示时间。BandLab 则在 CI 中使用同样的信息,不仅知道每个绑定的成本,还能知道是哪个线程承担了成本,从而定位主线程上的昂贵绑定,并把性能回退追溯到引入它的那次代码变更。
上下文传播:跨线程与协程的因果链
这是 2.0 最具突破性的新能力。现代应用的工作负载分布在多个线程、协程和进程之间,而 1.0 里一旦你把工作挪到别的线程,slice 的层级关系就断了,只能靠读代码才能推断"是谁触发了谁"。
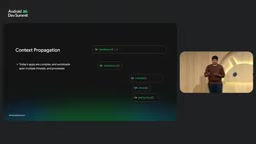
2.0 为 Kotlin 协程提供了开箱即用的上下文传播。以一个 fetchProfile 挂起方法为例:它调用 client.get,随后切换到 dispatchers.default 反序列化响应——这是再常见不过的协程代码。加上追踪后,你能在 trace 里看到工作从 worker 1 开始,发生上下文切换后转移到 worker 3,并有箭头标出这层因果关系。放大中间的区块还能看到,反序列化其实在 worker 1 就已开始,是 withContext 触发了切换,而协程机制为减少切换次数让 fetchProfile 在 worker 3 上恢复。协程何时挂起、何时恢复、完整因果链如何,全部一目了然。
对于非协程的老代码,2.0 也给出了方案。以使用回调配合 executor 的传统 API 为例,只需在追踪 API 中接受一个可选的 propagation token,并把 token 传给内层追踪调用;调用方用 suspendCoroutine 桥接协程世界与回调世界,再从协程上下文中取出 token 传入。这样即便跨越了协程与线程池的边界,因果链依然完整。
Kotlin 协程的上下文(CoroutineContext) 是一组随协程传播的元素的集合,最典型的是 CoroutineDispatcher 和 Job,开发者也可以自定义元素并借助 ThreadContextElement 或普通上下文元素实现跨挂起点的数据传递。Tracing 2.0 的上下文传播正是利用了这一机制:追踪框架把一个 propagation token 作为上下文元素随协程携带,协程在 withContext 或挂起恢复时切换线程,token 依然跟随,于是新线程上的 slice 能自动挂到发起方 slice 之下。
这也解释了为什么对回调式老代码需要手动传递 token——回调与 executor 不参与协程上下文,框架无从自动携带,只能由调用方在 suspendCoroutine 桥接处显式取出并传入。理解这一点,就能明白 2.0 并非“魔法般”地修复跨线程层级,而是把因果关系的载体交给了语言层面的上下文机制。
自定义元数据与 Compose 重组追踪
2.0 允许在 trace 中挂载任意数量的元数据条目,而不再只有名称这一个工具。这项能力在 Jetpack Compose 的重组追踪中发挥到了极致——该功能随 Compose 1.13 发布,今天即可使用。
传统的组合追踪只能告诉你某个 composable 及其子 slice 的相对成本和所在线程,却回答不了"为什么重组"。重组追踪通过向 trace 注入自定义元数据,清楚标出触发重组的输入事件,点击后还能看到具体是哪个状态发生了变化——比如某个可变状态值从 true 切换为 false,甚至能给出导致变化的完整调用栈:AbstractClickableNode.performClick 触发状态变更,状态变更引发重组。这类信息在以往是拿不到的。
Jetpack Compose 的重组(recomposition) 是 Compose 声明式 UI 的核心机制:当 composable 读取的状态(State 或 MutableState)发生变化时,Compose 运行时会重新执行读取了该状态的 composable 函数,以更新界面。重组本身是正常且必要的,但多余或过于频繁的重组会直接拖慢帧渲染,因此“某次重组由哪个状态变化触发”是性能调优的关键信息。
在 Tracing 2.0 之前,重组追踪只能记录 composable 的进入退出与耗时,属于“结果”层面的观测;借助自定义元数据,框架得以把触发重组的输入事件、变化前后的状态值乃至调用栈一并写入 trace,把观测推进到“原因”层面。这与 Compose 编译器插件在编译期为每个 composable 生成追踪代码的能力相配合,使得重组追踪在 Compose 1.13 中开箱可用。
可定制的后端与多平台布局
1.0 把追踪数据锁进 Atrace,2.0 则把 sink 交还给开发者。初始化分三步:创建 sink(定义 wire format 与输出位置,官方提供 Perfetto 格式的开箱实现,你也可以自行实现以对接 OpenTelemetry 等系统);用 sink 创建 trace driver,并可选地指定开启哪些 category——这让 release 与 debug 可以按重要性区别对待;最后通过 setGlobalTracer 注册。还可以用 add attribute 写入构建版本、渠道等全局信息。在 Android 上,只需实现 TraceDriver.Factory 的 create 方法,注册由框架代劳。
Rahul 强调多平台是一项刻意的设计决策:目前支持 Android 与 JVM,但实现为未来平台留出了空间,这与 Compose 的多平台方向一脉相承。
谷歌自家工具已经在吃红利
R8 和 Metalava 这两个 AndroidX 工程师日常依赖的工具,也在用 Tracing 2.0 优化自己。R8 借此把代码压缩与优化速度提升了 25%。具体看,旧逻辑要等所有 Gradle worker 读完输入 jar 才开始解析,trace 里留下了明显的 CPU 空闲区间;AGP 9 改为读完即处理,等待时间大幅缩短。
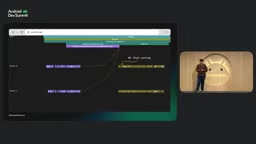
Metalava 则把 post-submit 时间缩短了 15%:它原本要对受限 API 和公开 API 各跑一遍检查,两轮都重复读取程序输入、构建 PSI 和 AST 这类昂贵的前置工作,改为只做一次并复用,节省自然发生。
R8 是 Android 官方的代码压缩、混淆与优化工具,取代了早期的 ProGuard,在 AGP 构建流程中负责把字节码收缩、重命名并做全局优化,其耗时直接影响大型项目的构建体验。Metalava 则是 AndroidX 用来从源码中提取并校验 API 签名的工具,它需要解析整个代码库构建 PSI 与 AST,因而天然是构建流水线中的重负载环节。两者都是“自身性能即开发者体验”的基础设施,也因此成为 Tracing 2.0 最早的内部受益者——它们的优化案例反过来验证了细粒度追踪在定位 CPU 空闲区间与重复前置工作上的实际价值。
该追踪什么:来自实践者的清单
Rahul 提醒,追踪重要,知道追踪什么同样重要。他给出的判断标准包括:在系统 trace 中寻找线程处于运行状态却无法解释的空隙;优先覆盖应用启动和核心用户旅程;关注深调用栈和无法解释的 CPU 占用;检查线程睡眠是否都有正当理由(等待 IO、binder 事务或外部输入),无法解释的睡眠往往藏着问题。埋点完成后应转化为 benchmark 持续跟踪指标漂移。他还半开玩笑地建议,可以把这套准则做成 skill,直接交给 AI 代理去执行。
上手方式
接入方式相当朴素:声明对 androidx.tracing.wire 的依赖,它组合了 Perfetto 兼容的 trace driver 与 tracing 本体,当前稳定版本为 2.0.5。Perfetto、AndroidX Benchmark、新的 Android Performance Analyzer 以及旧的 Android Profiler 均已支持 Tracing 2.0。
相关推荐

Anthropic IPO揭秘:AI热潮的燃料还是泡沫导火索?
Anthropic递交IPO申请,代码ANT。拆解招股书:80%收入来自按量付费、净亏807亿中720亿为账面费用、900%净收入留存率,以及SpaceX等历史IPO的首日与三年表现对比,回答AI泡沫之问。

AI会杀死研究论文吗?数学家给出新答案
数学家们在Lex Fridman播客中讨论AI是否会让研究论文消亡。从期刊审稿压力到Lean形式化验证,从GitHub开源疲惫到Mathlib的众包模式,探讨学术贡献形态的演变与数学知识验证的未来。

企业级大模型开发:从RAG到多Agent实战
企业级大模型应用开发课程解析:从提示工程、RAG到多Agent工程实战与FDE项目交付,帮助开发者理解Agent技术为何成为企业落地重点,系统化学习少走弯路。