Anthropic「巴拿马计划」曝光:图书扫描训练AI引争议

TF1记者Reddit征集Anthropic图书数字化项目线索,掀开AI训练数据供应链一角。
法国电视一台记者在Reddit发帖,征集曾参与Anthropic「巴拿马计划」的现任或前任员工,该项目被描述为将图书数字化以训练AI模型。帖子承诺匿名保护信源,但未透露更多细节。Anthropic此前曾因使用盗版书籍数据集面临版权诉讼并和解,巴拿马计划暗示其正在建立更系统化的图书数字化管道。文章分析了图书扫描的法律灰色地带、记者调查路径的局限,以及事件折射出的AI行业训练数据透明度缺失问题,指出头部实验室的数据实践正受到越来越多审视。
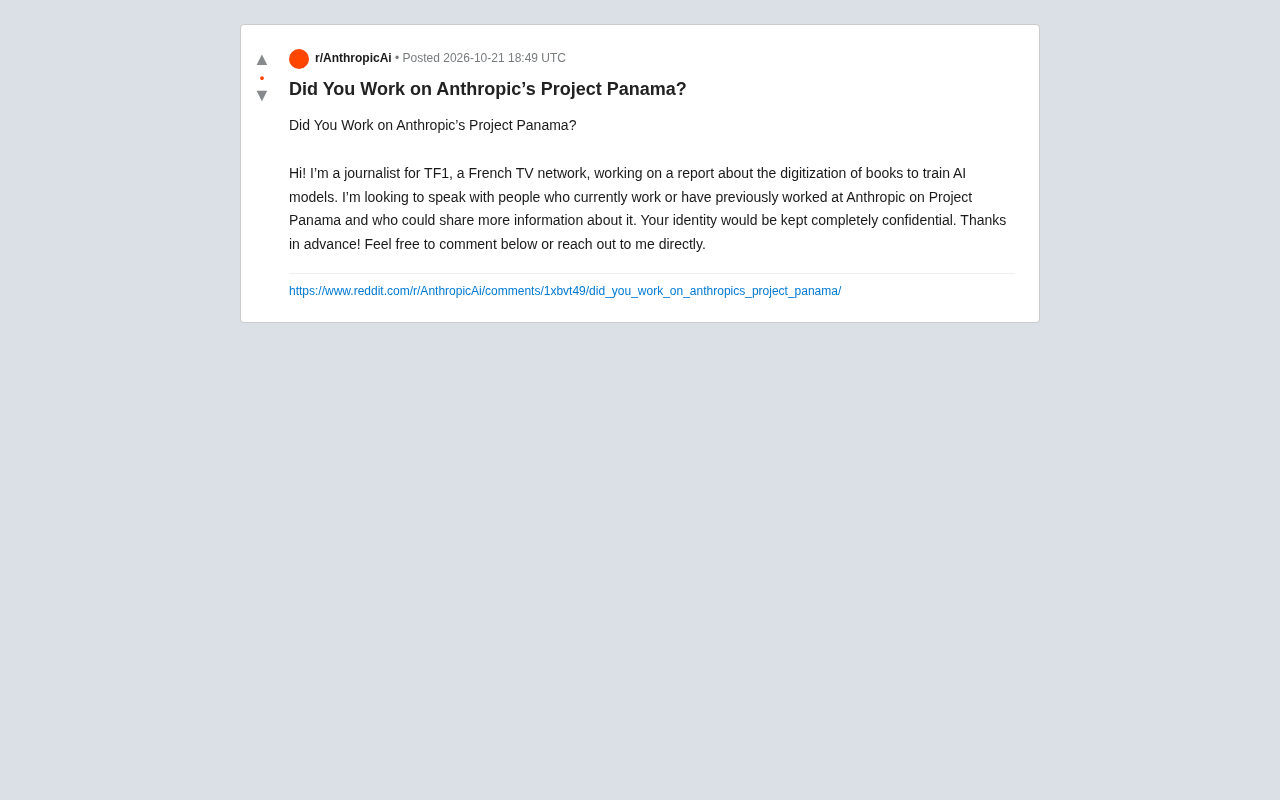
一位法国电视一台(TF1)的记者在 Reddit 上发帖,寻找曾参与 Anthropic「巴拿马计划」(Project Panama)的现任或前任员工。这个项目被描述为「将图书数字化以训练 AI 模型」。帖子要求受访者匿名,但并未透露更多项目细节。这条看似普通的招募帖,意外掀开了 AI 训练数据供应链的一角。
巴拿马计划是什么?
根据记者帖子的描述,Project Panama 的核心工作是将纸质图书扫描、数字化,用于训练 Anthropic 的 AI 模型。这并非 Anthropic 第一次因训练数据来源受到关注。此前,Anthropic 曾因使用盗版书籍数据集面临版权诉讼,最终以和解告终。巴拿马计划的出现,暗示这家公司正在建立更系统化、规模更大的图书数字化管道。
帖子本身信息有限,但它传递了几个关键信号:项目有专门的代号,说明它在内部被当作独立工程推进;记者愿意在 Reddit 上公开征集线索,说明外部对项目细节知之甚少;受访者被承诺匿名,侧面反映话题的敏感性。
Anthropic 盗版书籍诉讼和解案
2024 年,作家 Andrea Bartz、Charles Graeber 和 Kirk Wallace Johnson 对 Anthropic 提起集体诉讼,指控其通过「Books3」等盗版电子书数据集获取作品用于训练 Claude。Books3 是一个包含约 19 万本图书的公开数据集,曾被广泛用于大模型训练,后因版权争议被下架。2025 年,Anthropic 与原告达成和解,据报道和解金额高达 15 亿美元,成为 AI 训练数据版权领域规模最大的和解之一。该案的关键裁决之一是:训练本身可能构成合理使用,但通过盗版渠道获取图书不构成。巴拿马计划正是在这一背景下出现,暗示 Anthropic 试图通过合法或更可控的渠道重建图书语料供应链,以降低法律风险。
为什么图书扫描成了敏感话题
AI 模型训练需要海量高质量文本,图书因其结构完整、语言规范,一直是理想的训练语料。但图书受版权保护,大规模扫描并用于商业模型训练,在法律上处于灰色地带。
据帖子中记者的表述,其报道主题正是「图书数字化用于训练 AI 模型」。这说明媒体关注的不是某一家公司的个别行为,而是整个行业的做法。Anthropic 作为头部 AI 实验室,其数据获取方式自然成为焦点。巴拿马计划如果确实存在,它如何获取图书、是否获得授权、扫描规模有多大,都是外界想弄清楚的问题。
合理使用(Fair Use)与文本与数据挖掘例外
图书扫描训练 AI 的法律争议,核心在于版权法中的「合理使用」原则(美国版权法第107条)以及欧盟等司法辖区近年引入的「文本与数据挖掘例外」。合理使用通常考量四个因素:使用目的与性质(商业性还是教育性)、原作性质、使用部分占原作的比例、以及对原作潜在市场的影响。AI 训练属于典型的商业性使用,且往往复制整本图书,因此很难直接套用传统合理使用抗辩。欧盟《数字单一市场版权指令》第3、4条则允许科研机构及在特定条件下进行文本与数据挖掘,但对商业主体设有「权利保留」机制——权利人可声明保留其作品不被挖掘。这些法律框架的模糊与碎片化,正是图书扫描项目游走灰色地带的根源。
记者的调查路径与局限
TF1 记者选择在 Reddit 发帖,而不是通过官方渠道联系 Anthropic,这一做法值得玩味。一方面,匿名信源能绕开企业公关的过滤;另一方面,公开征集线索也让 Anthropic 有机会提前准备回应。
目前没有任何 Anthropic 员工公开回应此帖。帖子的信息量仅限于「项目存在」和「涉及图书数字化」,缺乏可验证的细节。作为单一信源,这篇帖子不足以支撑对巴拿马计划的完整描述,但它为后续调查提供了一个起点。
保密协议(NDA)与吹哨人保护
科技公司通常要求员工签署保密协议,禁止其对外披露内部项目、数据来源和商业策略。违反 NDA 可能面临违约诉讼、经济损失赔偿乃至职业声誉受损。对于参与敏感数据项目的员工而言,公开谈论工作内容还可能触发竞业限制或引发劳动法纠纷。记者承诺匿名,正是为了降低信源的法律与职业风险。在新闻伦理中,匿名信源需满足「信息至关重要」且「无法通过其他途径获取」等条件;Reddit 发帖征集是一种低成本、广覆盖的触达方式,但也意味着记者需自行验证信息真伪,单一匿名信源的证据效力有限。
对 AI 行业数据实践的启示
巴拿马计划引发的讨论,本质上是 AI 训练数据透明度的老问题。模型能力越来越强,但训练数据的来源、获取方式和授权状态,对公众仍然不透明。图书扫描只是其中一环,网页抓取、用户生成内容、学术论文等渠道同样面临类似质疑。
Anthropic 一直以「负责任 AI」自我定位,如果其数据实践与这一形象存在张力,公众的追问只会越来越多。记者的这次征集,或许只是更大规模媒体调查的前奏。
训练数据透明度与「负责任 AI」
训练数据透明度是当前 AI 治理的核心议题之一。模型的能力边界、偏见来源和版权风险都与训练语料密切相关,但大多数头部实验室并不公开其数据集的完整构成。Anthropic 发布的「负责任扩展政策」(Responsible Scaling Policy)主要聚焦模型能力评估与安全措施,对数据来源的披露要求相对有限。欧盟《人工智能法案》则对通用目的 AI 模型引入了训练数据摘要披露义务,要求提供「足够详细」的数据来源概述。行业自律与监管要求之间的落差,使得媒体调查和外部审计成为推动透明度的重要力量。图书扫描只是数据供应链的一环,网页抓取、用户生成内容和学术论文等渠道同样面临授权与披露的追问。
常见问题
巴拿马计划是否已被 Anthropic 官方确认? 目前没有。所有公开信息仅来自 Reddit 上记者发布的征集帖,Anthropic 未对此作出回应。
为什么记者要匿名保护受访者? 员工可能受保密协议约束,公开谈论内部项目存在职业风险,匿名是获取真实信息的常见妥协。
图书数字化训练 AI 是否违法? 取决于具体司法辖区和授权情况,目前多国法律仍在演变中,行业实践普遍处于灰色地带。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。