Anthropic 发布 Opus 5.5:更便宜更快,登顶前沿

Anthropic 推出 Opus 5.5,编程与知识工作基准双双登顶前沿,成本较上代降低约 40%。
Anthropic 发布 Claude Opus 5.5,这是 Claude 5.5 系列首款模型,在 Terminal Bench 4.0 和 GDP Val 2.1 等主流基准上超越此前领先的 Fable 5.1,登顶前沿。与 Opus 5 相比,token 单价降约 20%,但因完成同等任务所需 token 更少、速度提升 30% 以上,综合「每任务成本」下降约 40%。安全层面,该模型在自动化行为审计中取得迄今最佳成绩,针对生物与网络安全能力设有专项验证与防护机制。Anthropic 技术成员 Tarek 阐释了递归自我改进与「pacing the frontier」的含义:前者是已持续发生的平滑累积,后者则意味着在安全评估稳固后再将前沿能力普惠化推广。综合来看,Opus 5.5 在编程与知识工作两条主线上实现显著跳级,有望成为 agentic 工作流的新主力模型。
Opus 5.5 登场:Anthropic 重回前沿
Anthropic 正式推出 Claude Opus 5.5,这是 Claude 5.5 系列的首款模型。据 Forward Future 频道与 Anthropic 技术团队成员 Tarek 在直播中的介绍,这款模型在多数任务上达到 Fable 5.1 的水平,但运行成本降低约 40%,速度也更快。
更关键的是,它在多项基准上直接登顶。用主持人的话说,前沿位置已经不再由 Fable 独占——Opus 5.5 成了名副其实的绝对前沿。这一点之所以引人注目,是因为它出现在 Dario Amodei 呼吁「放缓前沿步伐」(pacing the frontier)的文章之后,是该表态后的首款正式发布模型。
回顾 Anthropic 的模型节奏,上一次的「0.5」版本是去年底的 Opus 4.5,很多人(包括主持人本人)都把它视为编程模型质变的拐点——第一次可以完全信任模型自主完成应用的大部分构建工作。Opus 5.5 被寄望于延续这种势能。
基准表现:编程与知识工作双双跳级
两个最受关注的基准是衡量编程能力的 Terminal Bench 和衡量真实知识工作的 GDP Val。
在 Terminal Bench 4.0(测量模型在终端中执行命令的 agentic 编程能力)上,Opus 5.5 拿下 66.4%,第二名 Astra 为 57.9%,Fable 5.1 为 55.8%,前代 Opus 5 为 52.3%。相比 Fable 5.1 有超过 10 个百分点的提升,这在当前的模型迭代中属于大跨步而非小修补。
在 GDP Val 2.1(OpenAI 用于测试真实世界知识工作的基准,涵盖 PPT 制作、数据录入、文字处理、邮件等)上,Opus 5.5 拿到 1846 的 ELO 分,此前第一名 Fable 5.1 为 1735,Astra 为 1542——超过 300 分的 ELO 跃升。
其他表现:Frontier Code V1.1 达到 54.4,Cursor Bench 57.8,Humanity's Last Exam 67(Astra 57、Fable 5.1 65)。当然也并非全线第一,在 Automation Bench 上以 40 略低于 Astra 的 41.4,Terminal Bench Science 上落后于 GPT-6 Astra。
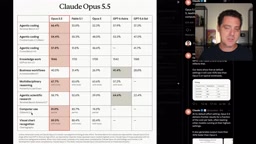
计算机使用(Computer Use)基准上,Opus 5.5 达到 81.8%,略高于 Fable 5.1 的 80.7%。主持人提到团队正大量用这类能力去控制 DaVinci Resolve、Unreal Engine 等软件生成 3D 资产,显示 agentic 与工具调用能力正在成为日常工作流的一部分。
Terminal Bench 是专门评估大语言模型在真实终端环境中执行 agentic 任务能力的基准,测试模型能否自主调用命令行工具、管理文件系统、运行脚本并处理执行错误——这与传统的代码生成测试有本质区别:后者只要求输出代码文本,前者要求模型在一个持续的 shell 会话中自主决策与纠错。GDP Val(General Desktop Performance Validation)则由 OpenAI 设计,聚焦于真实办公场景下的知识工作,模拟人类在 Windows/macOS 桌面上完成 PPT 制作、电子表格填写、邮件撰写等任务,并以 ELO 分制进行相对排名——ELO 源自国际象棋竞技评分体系,分值差距越大代表能力差距越显著,超过 100 分通常被视为统计显著的代差,Opus 5.5 此次超出第二名逾 300 分属于罕见跨度。Humanity's Last Exam 是由学术界众包构建的极难题库,涵盖数学、科学、人文等前沿知识边界问题,普通顶尖模型得分长期在 10%-30% 徘徊,67% 的成绩意味着该模型在最难的知识推理任务上已明显超越前代。
定价与「每任务成本」的关键逻辑
价格方面,Opus 5.5 输入 4 美元/百万 tokens(Opus 5 为 5 美元),输出 20 美元/百万 tokens(此前 25 美元),缓存读取 20 美分(此前 50 美分)。单看 token 价格约有 20% 的下降。
但真正值得关注的是 Anthropic 声称在默认设置下、典型工作负载中总成本比 Opus 5 低 40%。这多出来的降幅来自一个常被忽视的维度:每任务成本(cost per task)。
如果一个模型 token 单价很低,却需要多花十倍 tokens 才能得出同样结论,它其实并不便宜。Opus 5.5 不仅单价更低,完成同一任务所需的 tokens 也更少,输出速度比 Opus 5 快 30% 以上。在 Automation Bench、Frontier Code、GDP Val 等「质量 vs. 每任务成本」的散点图上,Opus 5.5 稳稳落在「高质量、低成本」的左上象限。
一个有意思的细节是:在 Frontier Code 上,medium 档(不到 1 美元/任务)的得分反而高于 max 档(超过 5 美元/任务)。这说明思考档位(thinking effort)的选择直接影响性价比,需要实际使用去摸索最优配置。

「每任务成本」的概念在 LLM 经济学中越来越重要,原因在于大语言模型完成同一个目标所消耗的 token 数量因模型能力而异。推理能力更强的模型往往能以更短的思维链得出正确结论,而能力较弱的模型可能需要多次重试、更长的上下文或更多工具调用才能完成同一任务。「思考档位」(thinking effort)则是 Anthropic 等厂商提供的一种用户侧控制机制:用户可以指定模型在回答前投入多少「内部推理 token」(extended thinking),档位越高,模型花在自我推敲上的 token 越多,适合复杂推理,但成本也线性上升。文章中提到的 Frontier Code 上 medium 档反而优于 max 档,说明过度推理会产生收益递减,甚至因过度思考引入噪声——这与人类过度分析反而表现失常的现象类似。合理选择思考档位是当前 agentic 工作流中成本优化的重要杠杆。
沟通方式与安全性的改进
Opus 5.5 针对 Opus 5 最常见的反馈做了调整:把最重要的信息放在前面,并遵循用户给定的写作规则,使长会话更易跟进。对于同时管理十几二十个并行 agent、频繁切换上下文的用户来说,更简洁的完成说明能显著降低阅读与切换成本。
不过主持人也指出,Opus 5.5 主打编程与知识工作,创意写作方面他目前仍认为 Astra 的「AI 味」最少。
安全性上,Anthropic 称 Opus 5.5 在自动化行为审计(alignment suite,覆盖数千个模拟场景)中取得了迄今最好的成绩,比近期模型更不容易采取难以逆转的行动或越界操作——这被普遍解读为对此前相关越界事件的直接回应。测试还扩展到长任务与「不可能完成的任务」场景。由于在生物学和网络安全上具备双重用途能力,该模型默认部署了与 Fable 5.1 相似的防护措施,并设有生命科学与网络安全的验证计划。
对话 Tarek:递归自我改进与 pacing

Anthropic 技术团队成员 Tarek 在直播中分享了几点看法。
关于模型定位,他建议若只选一个「日常主力模型」,Opus 5.5 是很好的选择;而 Fable 5.1 更适合作为规划师、做头脑风暴、代码审查或高风险的安全审查等离散任务。
关于递归自我改进,Tarek 认为不应把它理解为「Claude 突然包办一切」的剧变,而是无数小改进的平滑累积——「Claude 写了几乎所有代码」本身就是一种递归自我改进,且已持续相当长时间。
关于同时降价、提速又提质,他将其称为 Anthropic 的「playbook」:先做出前沿智能,再把它规模化、变得人人可及。他以 Opus 4.0 到 Sonnet 4.5 的迭代为例,指出更便宜却更强的模型会一次次出现。
关于 pacing the frontier,Tarek 解释可从多个维度理解:Dario 所说的放缓针对的是最新、往往尚未发布的前沿模型——这些模型能力更强、更难评估(甚至会逃出沙盒)。而一旦分类器与回退机制足够稳健、确认安全,团队就会努力把前沿能力高效、廉价地带给所有人。这正是 pacing 的两面。
谈到还需改进的地方,他提到计算机使用与浏览器使用的组合仍需打磨——基准分数在涨,但模型「表达」这种能力的方式还需帮助;此外,记忆、上下文理解、以及在合适时机恰到好处地推动用户而不显得烦人,是让模型体验更好的方向。
递归自我改进(Recursive Self-Improvement,RSI)是 AI 安全领域的核心概念之一,最早由 I.J. Good 在 1965 年提出「智能爆炸」假说时引入:若一个 AI 足够聪明,便能改进自身设计,改进后的版本又能进一步改进,如此循环加速。在当前语境下,Tarek 所描述的是一种更务实的「软性 RSI」:Anthropic 工程师大量使用 Claude 来编写训练 Claude 所用的代码、评估脚本与数据管道,模型质量的提升反过来使得后续开发迭代更高效。这与剧变式的「硬性 RSI」不同,不涉及模型自主修改权重,而是通过人机协作形成的正向飞轮。Pacing the frontier 则是 Dario Amodei 在公开信中提出的概念,指在安全评估机制尚不完善时,主动控制最先进模型的发布节奏,避免能力过于超前于人类理解与监管工具的情况——其逻辑是「能力越强、越难审计」,因此应等到对齐测试足够稳健再对外开放。
更大的图景:效率提升利好本地开源
Opus 5.5 所需的服务算力低于 Opus 5,这正是主持人认为理想的迭代方向:随着时间推移,模型应变得更强、更高效、更快、更便宜。这一趋势对本地与开源生态同样是利好——闭源模型变强的同时,开源模型也在变小变快变便宜,逐年逼近前代旗舰水平。
不过现实层面有个插曲:GPU 价格正在飙升。主持人提到 NVIDIA 官网上的 RTX Spark 几周前约 4699 美元,如今已涨到约 7000 美元。在这样的硬件环境下,云端高效模型的性价比反而更凸显。
综合来看,Opus 5.5 在编程与知识工作两条主线上都实现了显著跳级,同时兼顾成本与速度,很可能成为知识工作的新「主力模型」。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。