Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆

Anthropic新模型Fable 5.2以三行提示词造出可玩游戏与完整应用,能力惊人但成本高昂。
AI博主Matthew Berman对Anthropic新模型Fable 5.2进行了十余项极限测试。仅用三行提示词,模型便在数天内生成可玩的《战争机器》克隆,单项目消耗数十亿tokens、成本上万美元;类似方式还复刻了《糖豆人》、Excel、DaVinci Resolve视频剪辑器、纯手写WebGL2的物理模拟、Blender建筑方案以及单条提示词生成的科普动画。基准测试显示Fable 5.2在Frontier Suite、OSWorld 2.1、Humanity's Last Exam等榜单上多数领先Opus 5.5,但并非全胜。定价较上代下调约20%,仍显著贵于Opus 5.5,质量与成本需权衡。
在AI编程模型竞争白热化的当下,Anthropic悄然放出了被多位开发者称为「地表最强」的新模型——Fable 5.2。知名AI博主Matthew Berman在最新视频中用它做了十余个极限测试,结论相当惊人:只要三行提示词,几天时间就能造出一款可玩的《战争机器》克隆。
一句话提示词,造出可玩3A级游戏
Berman展示的第一个demo是一个完整的《战争机器》克隆游戏,基于Unreal Engine构建。他只写了三行提示词:「用Unreal Engine复刻《战争机器:E-Day》,只需一个关卡,但画面、玩法、角色要尽可能接近原版。」然后开启Ultra Code模式让它自己跑。
结果这个项目消耗了约85亿tokens,按API定价折合大约1.5万美元。游戏包含掩体系统、战术换弹、AI敌人、光影和贴图,全部由模型生成。Berman在试玩时反复感叹「这真的很好玩」,甚至一度忘记自己在录视频。
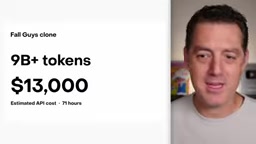
同样的思路也复制到了其他经典游戏上:一个《糖豆人》克隆「Tumble Beans」用约90亿tokens、71小时构建,预估成本1.3万美元,支持多人联机,物理弹跳和关卡复杂度都达到了可发售水准;一个基于Unreal Engine的东京城市3D可视化项目消耗67.2亿tokens、约70小时,预估成本1.1万美元,包含实时交通、行人、列车进站和光线追踪反射。
Unreal Engine(虚幻引擎) 是Epic Games开发的一款主流商业游戏引擎,广泛用于3A级游戏、影视虚拟制片和建筑可视化。它以高保真渲染(Lumen全局光照、Nanite微多边形几何)和蓝图可视化脚本系统著称,但传统上需要美术、程序、策划分工协作数月才能产出一个可玩关卡。文中的"Ultra Code模式"指模型在长时间自主运行中不断编写、编译、调试代码的智能体工作流,相当于让模型独立完成一个中小型工程项目的开发闭环。
不只是游戏:从Excel到视频剪辑器
如果认为这只能做游戏,那就低估了它的通用性。Berman用它构建了一个功能完整的微软Excel克隆,耗时近50小时,全部公式可点击编辑,支持数据透视表和示例数据加载,而且是浏览器端运行、可以直接发布链接给人试用。
另一个案例是本地运行的DaVinci Resolve克隆——波形显示、视频预览、剪辑分割、磁性吸附、关键帧、完整键盘快捷键一应俱全。有意思的是,Berman团队的另一位成员Alex独立用同样的方式做出了自己的视频编辑器,并且已经在用它剪片子了。
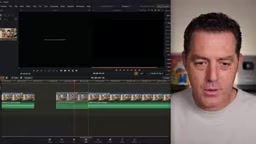
这类项目暴露出一个趋势:过去需要整个工程团队数月完成的工作,现在一个人加上一个模型就能在几十小时内交付原型。
WebGL2 是浏览器端的底层图形API,允许JavaScript直接调用GPU进行硬件加速渲染,无需插件。文中"纯手写WebGL2、不依赖three.js"意味着模型没有借助任何封装库,而是自行编写着色器(GLSL)、顶点缓冲区管理和渲染管线,这对代码生成的正确性和一致性要求极高。数据透视表则是Excel最具代表性的功能之一,涉及分组聚合、行列交叉计算和动态重算,通常被视为检验电子表格类应用完成度的关键指标。
物理模拟与3D生成:从水球到东京
在科学可视化方向,Fable 5.2同样表现抢眼。一个「子弹击穿水球」的物理模拟demo被要求只用单个HTML文件,不依赖three.js或任何外部库,纯手写WebGL2。结果模型生成了包含光线追踪、实时物理重算、可调子弹速度/口径/光照/重力的完整交互场景,总消耗仅4100万tokens、约2.5小时、成本约91美元。
3D建模方面,模型在Blender中生成了一个带泳池、太阳能板、露台和车库的住宅建筑方案,总消耗1300万tokens、成本约30美元。还有一个3D打印承重塔设计,在10克以内、0.4mm喷嘴PLA的约束下生成结构,最终成功承受住笔记本电脑、Mac mini、DGX Spark甚至电钻的堆叠。
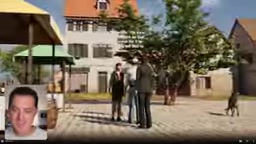
Berman还让它生成了一个完整的3D欧洲小镇,居民、动物、车辆全部由AI驱动,市民之间会进行完整对话。这类「世界模拟」场景此前属于研究级项目,现在变成了单次提示词的产物。
动态图形与解释类内容被「解决」
视频中最具实用价值的发现,可能是运动图形(motion graphics)生成能力。Berman用单条提示词生成了近2分钟的「软件反编译原理」科普动画,以及「LLM工作原理」解释视频,涵盖embedding、transformer层、训练过程、loss曲线、next token prediction等概念的可视化。
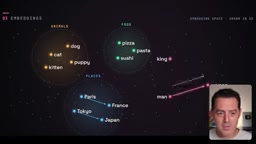
这类内容过去需要专业动效团队数周制作,现在单条提示词、45分钟、约25美元即可完成。对于内容创作者而言,这可能是最直接的生产力变革。
基准测试:全面领先但并非全胜
Berman引用的基准数据显示,Fable 5.2在Frontier Code 2.0、Frontier Suite(69.9分)等主要榜单上全面压制此前的旗舰Opus 5.5。在操作系统控制基准OSWorld 2.1上拿到89.3分,远超Astra的79.5和Opus 5.5的87。Humanity's Last Exam得分74.2,比Fable 5.1高出约10分。
也有例外:Automation基准上Carbon以微弱优势领先(Fable 5.2为51分);Terminal Bench上同日发布的Mythos 5.2以75.3分险胜Fable 5.2的74.6分。
更值得关注的是实际使用体感。Berman称自己「已经在这个模型上烧了超过一千亿tokens」,最突出的感受是自主性极强——它会替你做决定,且九成以上符合你的预期。开启max thinking加Ultra Code做全代码库审查时,过去需要60到120分钟的任务现在10分钟内完成,同时发现了大量bug、安全问题和UI不一致。
OSWorld 是一个评估AI智能体操作系统控制能力的基准,任务包括跨应用操作文件、编辑文档、配置系统设置等真实桌面场景,考验的是多步规划与GUI交互能力,分数越高说明模型越能独立完成"用电脑办事"。Humanity's Last Exam(HLE) 则由数千道跨学科高难题组成,覆盖数学、物理、人文等领域,被视为当前最难的综合知识推理测试之一,得分普遍偏低,因此几分的差距往往意味着显著的能力提升。Terminal Bench 专注于命令行环境下的真实工程任务,如仓库修复与脚本编写。
定价与取舍:更强,但更贵
Fable 5.2的定价相比Fable 5.1下调了约20%,为每百万输入tokens 8美元、输出tokens 40美元。Fast模式可提速2.5倍,但价格翻倍至16/80美元。
Berman给出的结论很明确:Fable 5.2确实强于Opus 5.5,但Opus 5.5更快、更便宜、效率更高。日常项目是否切换到Fable 5.2,取决于任务对质量的要求是否值得付出数倍成本。
从这些demo来看,一个更值得思考的问题是:当模型能用三行提示词生成可发售的游戏,软件开发的护城河究竟还剩什么。Berman在视频中反复说「软件已死」,这句话当然夸张,但他用几十个小时和上万 token 成本造出的东西,确实在重新定义「一个人能做出什么」的上限。
背景补充
运动图形(Motion Graphics) 指以动画方式呈现图形、文字与数据的内容形式,常见于科普视频、产品演示和品牌包装,典型工具包括After Effects。其制作难点在于时间轴编排、缓动曲线、图层合成与视觉叙事节奏的统一。Embedding 是把离散的词语或概念映射为高维稠密向量的表示方法,语义相近的向量在空间中距离更近;Transformer 则是当前大模型的主流架构,依靠自注意力机制建模序列中任意位置之间的依赖关系。让模型把这些抽象概念转化为连贯动画,意味着它同时具备领域知识与视觉编排能力。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。