Ollama选模型完全指南:从配置到量化避坑

按配置、标签、参数、量化、上下文五步流水线,教你用 Ollama 选对本地模型。
文章把 Ollama 选模型拆成一条可复用的流水线:先用任务管理器确认内存、CPU 和显存家底;再到 ollama.com/library 认识 Local/Cloud、Tools、Thinking、Vision、Embedding、Decision 等标签;接着理解 7B、14B 等参数规模与 Q4、Q8 量化的关系,提出“买大的别买精的”——同空间下 9B 的 Q4 通常比 4B 的 Q8 更聪明;然后算清上下文占用约等于模型体积加 KV 缓存,日常 8K 够用,强行调高会闪退;最后给出 pull、run、桌面端三种下载方式和 list/ps 两个确认命令。
选模型前先摸清家底
下模型像开盲盒?看别人跑得飞起,自己一下载就卡死闪退?问题往往不在电脑本身,而在选型方法。Jingjing 的这期视频把 Ollama 选模型拆成了一条流水线:先看配置,再逛库,认标签、选参数、懂量化、算上下文,最后下载回家。
第一步是搞清楚自己有多少家底。按 Ctrl+Shift+Esc 打开任务管理器,切到性能页,看两样:内存多大、CPU 什么级别。再看显存——没有独显的核显轻薄本,模型会全部吃内存。把这两个数字记下来,后面每一步都用得上。
逛模型库:先认标签再动手
浏览器打开 ollama.com/library,这就是官方货架。每个模型卡片上有名字、介绍、可下载的参数档、下载次数和更新时间。先看最右边那一排:Any 表示全部,Local 是本地,Cloud 是云端。Cloud 是官方机房跑的,不占你资源但要联网;Local 才是待会儿要下到你硬盘里的。
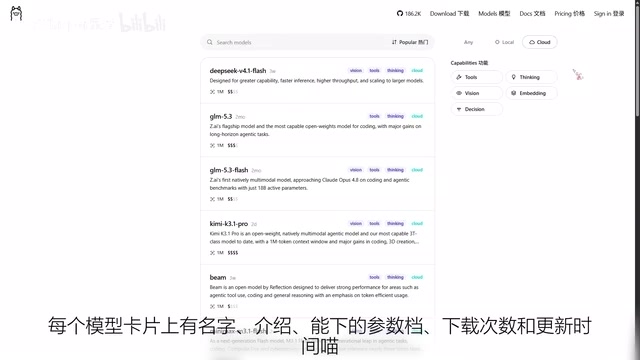
下面的功能筛选得一个一个讲。Tools 标签表示模型会调工具,能联网、能操作文件,做智能体必选。Thinking 会让模型先思考再回答,数学推理强,但速度慢、消耗上下文。Vision 是看得懂图片。Embedding 把文字变成向量,只做检索和知识库,不能聊天。另外还有带 Audio 标签的模型,能听声音也能说话,不过它没有单独的筛选按钮,看到徽章认识一下就好。
最后是新出的 Decision 决策模型。它不聊天,专做判断题、分类、路由、打分,走单独的街口,又快又省资源,做自动化流程的人一定要认识它。
标签还可以叠加,一个模型可以同时会看图、会调工具。
Embedding 模型与聊天模型的区别:Embedding 模型输出的是固定维度的向量,而不是自然语言,它的作用是把文本映射到语义空间,供向量数据库做相似度检索。典型用途是 RAG(检索增强生成):先用 Embedding 模型把文档切块建索引,用户提问时检索最相关的片段,再交给聊天模型生成答案。它不能直接对话,但常与聊天模型配合使用,这也是模型库里单独给它一个标签的原因。
参数与量化:买大的别买精的
模型名字后面的 7B、14B、27B,B 是十亿,指参数规模。规模越大越聪明,也越大越慢。以作者机器上现成的三个模型为例,9B 的模型体积约 6.6 个 G,27B 约 17 个 G,34B 约 19 个 G。记不住就看体积,体积直接决定你的内存够不够。日常聊天 7 到 9B 够用,想干重活再往上加。
同一个模型名字带 Q4、Q8,是把模型压成不同精度的量化版本。数字越大越准,体积也越大。新手无脑选 Q4_K_M,速度效果最平衡。重点来了:量化和参数可以互相交换。内存不够跑 4B 的 Q8,同样的空间可以直接换成 9B 的 Q4。记住这句话:买大的别买精的,大部分时候 9B 的 Q4 就是比 4B 的 Q8 聪明。
量化(Quantization)的原理:大模型参数默认以 16 位浮点数(FP16)存储,一个 7B 模型光权重就要约 14GB。量化是把权重压缩到更低位宽,比如 Q4 指约 4 位整数,体积直接缩到三分之一左右,代价是精度损失。Ollama 常用的 GGUF 格式里,Q4_K_M 中的 K 表示对关键层(如注意力权重)做混合精度保留,M 表示中等粒度,它在速度和精度之间取得了很好的平衡,因此成为社区默认推荐。Q8 接近无损但体积大,Q2、Q3 虽然更小,但回答质量下降明显,一般不建议日常使用。
上下文:不是白开的总占用
上下文就是 AI 一次能记住多少内容,在 Ollama 设置页用滑块条调。它不是白开的,总占用约等于模型体积加上 KV 缓存。7B 的模型 8K 上下文缓存只要 1.5 个 G,开到 32K 缓存直接涨到 6 个 G。6G 显存跑 7B Q4,本体 4.5G 加缓存 1.5G 刚好稳稳跑;你强行开 32K,它就闪退给你看。所以日常聊天 8K 够用,读长文档再往上开。
KV 缓存是什么:Transformer 模型在生成每个 token 时,需要缓存之前所有 token 的 Key 和 Value 矩阵,避免重复计算,这就是 KV 缓存。它的体积与上下文长度成正比,也与模型的层数、隐藏维度成正比,所以同样 8K 上下文,大模型的缓存比小模型更大。Ollama 默认会按模型能力分配上下文,手动调高滑块后,缓存会实时占用显存或内存,一旦超出可用容量就会 OOM 闪退。理解这一点,就能明白为什么“模型本体装得下”不等于“跑得起来”。
下载的三种方式
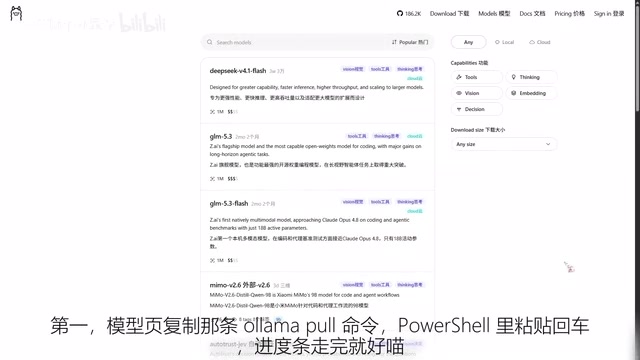
第一种,在模型页复制那条 ollama pull 命令,在 PowerShell 里粘贴回车,进度条走完就好。第二种,直接 ollama run 模型名,没下载它会自动先拉,拉完直接进对话。第三种,桌面端聊天界面发一句话,它检测到没有这个模型也会自动下。下完用 ollama list 确认,再用 ollama ps 看它跑起来占了多少内存。
下载服务器在国外,慢的话就换早上或凌晨。
ollama list 与 ollama ps 的区别:list 列出的是硬盘上已经下载的模型清单,包括名字、大小和修改时间;ps 列出的是当前正在运行、已加载进内存的模型,并显示其实际占用。模型闲置一段时间后会被自动卸载,ps 里就看不到了,下次调用会重新加载。所以排查“内存被谁吃了”时,ps 比 list 更有参考价值。
选型决策流
把整套方法压成一句话:先看配置,再逛库;认标签,参数选体积;量化做交换,上下文算总账;最后 pull 回家。新出的 Decision 决策模型做自动化的记得认识一下。遇到报错扔评论区,心虚的一个一个看。
相关推荐

Agentic Paper Bomb:用多智能体自动生成企业合规文档
Reddit 开发者分享 Agentic Paper Bomb 实验:让五个 AI 智能体扮演高管角色,自动生成企业合规、安全、DevOps 等文档。探讨多智能体协作生成文档的潜力与隐忧。

《Rob Roy》经典台词解析:领导者的代价与生存抉择
解析《Rob Roy》中Rob Roy与Sibbald的经典对峙台词,探讨领导力的代价、生存与尊严的权衡,以及权力博弈背后的人性洞察。

黄仁勋被曝聘请擅长处理丑闻的公关公司
据 Wired 报道,黄仁勋在《纽约时报》报道其妻子商业往来后,聘请了一家曾处理高知名度性丑闻的公关公司。本文分析这一举动背后的危机管理信号及其对英伟达声誉的影响。