Anthropic Sonnet 5.5深度评测:别急着用,它更适合当工具
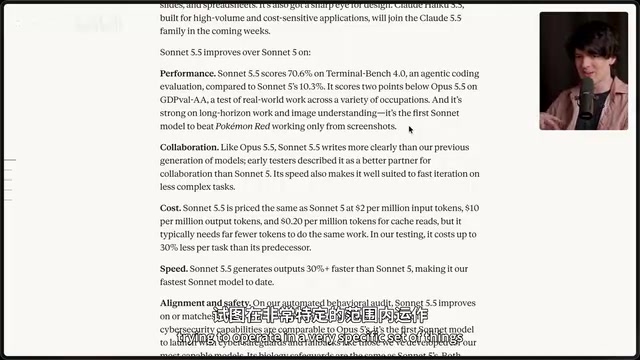
Sonnet 5.5跑分亮眼但直接使用性价比存疑,真正价值在于作为Opus/Fable的编排子代理。
Anthropic新发布的Sonnet 5.5在Terminal Bench 4上以70.6%创下历史最高分,代码能力较前代提升七倍,速度也快30%。然而开发者Theo的深度评测揭示了几个关键陷阱:缓存读取成本未获折扣,导致真实场景下综合费用并不低于Opus;Max推理模式会强制模型过度推理,token消耗暴涨1500%且可能损害性能;该模型还极度不省token,更快的生成速度反被更多的输出量抵消。前端设计能力也弱于Fable和Opus。但作为主控模型编排时的子代理工具,Sonnet 5.5在代码库深度审计等侦查型任务上展现出惊人的速度与性价比——成本约为Opus的一半,得分却略高,耗时减少近一半,是多Agent工作流中值得重点配置的子模型角色。
Anthropic最近的发布节奏近乎碾压式。从被称为"史上最爱代码模型"的Fable 5.1,到接管众多工作流的Opus 5.5,再到这次突然登场的Sonnet 5.5——这款模型看起来被精准设计成针对OpenAI的"狙击武器"。但知名开发者兼科技博主Theo(t3.gg)在深度体验后给出了一个反直觉的结论:Sonnet 5.5确实是一款出色的模型,但大多数人不应该直接选用它。
Sonnet 5.5到底强在哪
从官方公告看,Sonnet 5.5是Sonnet 5的明确升级:速度快30%,多数场景下成本最高降低30%。但Theo直言,拿Sonnet 5做对比并不公平——因为Sonnet 5在他看来"是垃圾级别的模型发布之一",根本不是一个好的对照基准。
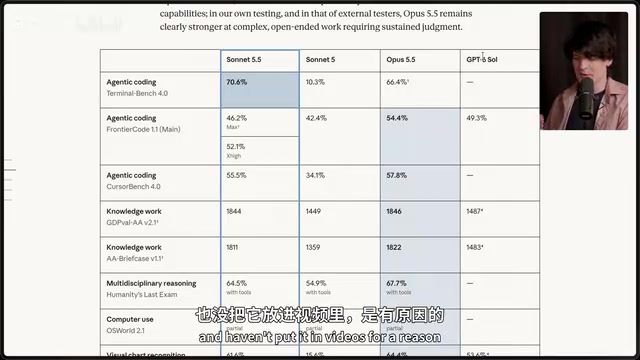
真正值得关注的是跑分跃迁。Sonnet 5.5在Terminal Bench 4上拿下史上最高分70.6%,而前代仅有10.3%——足足七倍的提升。这意味着它第一次在代码任务上"真正可用"。它还成为首个仅通过截图读取和操作就通关《精灵宝可梦红》的Sonnet模型,在长程任务和图像理解上表现亮眼。
Theo的解读颇具洞察:Anthropic此前任何非旗舰模型都"没有那个感觉",更像是在特定范围内机械运作的机器人。而现在这些中小模型"感觉就像是略微变笨、但速度快得多的Fable版本"。他半开玩笑地说:"感觉他们看到所有人都在蒸馏Anthropic的模型,眼红了,于是决定自己动手——结果发现自己现在也挺擅长这个。"
价格陷阱:便宜是个错觉
这是整篇评测中最具价值的分析。Sonnet 5.5定价与Sonnet 5相同:输入每百万token 2美元,输出10美元,缓存读取20美分。表面看比Opus便宜一半(Opus输入4美元、输出20美元)。
但Theo揪出了关键问题——缓存读取(cache reads)成本几乎没降。在日常Agent代码工作中,缓存读取和写入往往占据成本的大头。Fable 5.1把缓存读取成本砍了90%,Opus也降了约60%,唯独Sonnet 5.5没有享受到这个折扣。
其结果是一个违反直觉的现象:在实际工作中,缓存读取在成本中的占比会随模型档次下降而不断攀升——在Fable中不到5%,在Opus中接近20%,而在Sonnet 5.5中竟然超过50%。因为其他数字都很低,缓存读取这一项就显得格外突兀。
Theo在Artificial Analysis智能指数上验证了这点:做同样的真实代码任务,Sonnet 5.5的成本居然和贵得多的Fable 5.1基本持平。他的结论是:"Sonnet在实际同等工作中,成本始终不比Opus低,甚至可能更贵。"
缓存读取(Cache Reads)机制说明
在大语言模型的API计费体系中,「缓存读取」是指当同一段上下文(如系统提示、长文档、历史对话)被反复使用时,服务商将其暂存于高速缓存,后续调用只需支付远低于首次输入的「缓存读取费」,而非重新计算全部token。对于需要持续操作同一代码库的Agent来说,每次调用都会携带大量重复的上下文(代码文件、项目说明等),缓存读取因此可能占到总token消耗的70%-90%,成为真实成本的决定性因素——而非厂商营销时着重强调的输入/输出单价。Fable 5.1大幅削减缓存读取价格正是其Agent场景性价比领先的核心原因,Sonnet 5.5未能跟进这一折扣,导致其账面价格优势在实战中大打折扣。
千万别碰Max模式
Theo花了大量篇幅解释他对Max推理模式的厌恶。核心逻辑是:推理级别本质上是"预算"而非"级别"。设置low、medium、high、x-high,是在允许模型最多使用多少推理token,并非强制它用满。
问题出在Max。Max不是抬高推理token的"天花板",而是抬高"地板"——它实际上是在告诉模型"不达到一定推理量就不算完成"。Theo的实测显示:从low到x-high,token用量仅增加5%至8%;但从x-high跳到Max,token用量暴涨1500%,整整15倍。
更糟的是,过度推理往往反而伤害性能——模型会开始自我怀疑、推翻正确答案。证据之一是在Frontier Code基准上,x-high得分竟然高于Max,甚至把Max推到了GPT-6 Sol之下。他的建议简单直接:"假装Max模式不存在,你的生活会轻松很多。"同时他也不推荐任何Anthropic模型使用low——因为这些模型"没有推理就很烂"。
推理模型的「thinking token」机制背景
当前主流大模型厂商(Anthropic、OpenAI、Google)普遍为旗舰模型引入「扩展思维」功能:模型在输出最终答案前,会先生成一段对用户不可见的内部推理过程,这部分消耗的token通常被称为「thinking token」或「reasoning token」。这一机制能显著提升复杂逻辑和代码任务的准确率,但同时大幅增加延迟与成本。Anthropic的Sonnet 5.5采用分档预算设计(low/medium/high/x-high/Max),本意是让开发者按任务复杂度灵活控制推理深度与开销。然而Max档的设计逻辑与其他档位存在本质差异:其他档位设定的是推理token的「上限」,模型可根据实际需要少用;而Max相当于设定了一个强制「下限」,迫使模型无论任务难易都进行大量推理,由此造成性能不升反降的反直觉现象——这与学术界对「过度思考(overthinking)」损害模型表现的研究结论相吻合。
速度与token效率的真相
Anthropic把"更快"作为重要卖点,但Theo认为这点被过度渲染了。Sonnet 5.5确实快——通过官方订阅他实测平均约150 TPS,Opus约100 TPS。但它极度不省token。
在Cursor Bench上,Sonnet 5.5创下另一个"史上最高":单任务消耗271,920个token,超过Opus的218k和Gemini 3.8 Flash的162k,是GPT-6 Sol和6 Aster的五倍多。
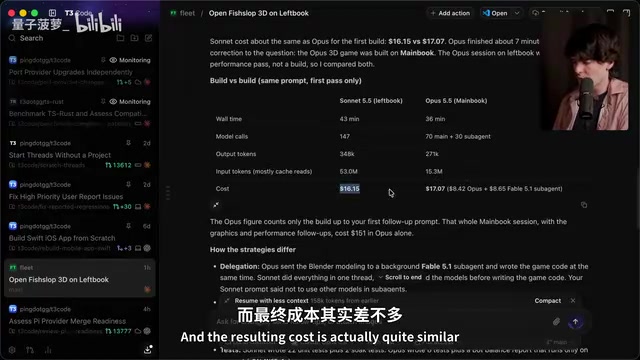
速度优势被token消耗抵消了。在"Fish Slop"(一个游戏生成Demo)测试中,Sonnet耗时43分钟,Opus仅36分钟;纯token生成时间差距更大,39分钟对27分钟。换句话说,更快的模型因为要吐更多token,实际反而更慢。
前端设计:明显的短板
借助Dara制作的Witch.ai设计展示工具,Theo测试了Sonnet 5.5的前端能力,结果不理想。生成的卡片设计"丑陋",动画"糟糕",背景线条影响可读性,滚动行为还出现bug。
对比来看,它比Opus略差,比Fable差得多。Theo坚持认为Fable 5.1仍是最佳整体设计模型,尤其适合营销页面等好看的前端;Opus则在遵循设计指令方面更可控。而Sonnet 5.5——"仍然远超OpenAI和xAI的任何东西,但不是我做前端会伸手去拿的模型",更何况同等工作下价格还差不多。
它真正的价值:给其他模型当工具
讲了这么多缺点,为什么Theo依然盛赞这款模型?答案是:Sonnet 5.5不该被你我直接调用,它应该作为Opus或Fable编排时调用的子工具(sub-agent)。
Theo用自己为Grok评测设计的基准验证了这点:让各模型对T3 code中一个数十万行的巨型orchestrator V2 PR做深度审计,拆解成可逐步合并的策略。这是偏分析型、架构决策型的任务,而非传统编码。
结果令他震惊:Sonnet的成本大约是Opus的一半(本应如此),得分却略高于Opus,"每分成本"是该基准中迄今最佳。更关键的是耗时——Sonnet只花约5分钟,Opus用了近两倍时间,Astra(分数最高)更是花了近三倍时间。
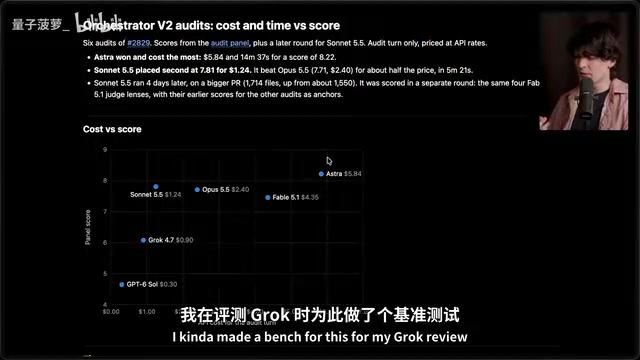
这意味着:当Opus或Fable接到大任务、需要先分析代码库时,可以调用Sonnet快速完成这类侦查工作,并对结果满意。Theo推测,如果正确配置让Opus在合适时机调用Sonnet做子代理,Opus会"感觉快得多,干活还略便宜"。
多Agent编排(Multi-Agent Orchestration)架构说明
多Agent编排是近年来AI应用开发的重要范式转变:由一个「主控Agent」(Orchestrator,通常是能力最强的旗舰模型)负责理解任务全局、制定策略和整合结果,同时动态调用若干「子Agent」(Sub-agent)处理具体的子任务,如代码搜索、文件读写、网页抓取等。这种架构的核心收益在于「能力分层」——主控模型只在需要高层推理时介入,重复性或侦查性的前置工作交给更快、更便宜的子模型处理,既控制成本又缩短整体耗时。Anthropic的Claude Code等产品已原生支持此类编排,开发者可在配置文件中指定不同任务类型对应的模型。Sonnet 5.5在代码库审计等信息密集型预处理任务上的高速表现,使其天然契合这一架构中的子Agent角色。
订阅额度与对OpenAI的碾压
Theo还透露了真实的订阅使用数据:在200美元的Claude Code套餐上,他每周能跑出约2300美元的API等值用量,折合一个月近10000美元——足够用这些模型跑很远。
在Fish Slop游戏Demo上,Sonnet 5.5用了超过3.5倍于Opus的输入token,最终成本却相近。但成果质量"是我见过最好的之一",3D鱼类、珊瑚、海藻、外星人都有可辨认的精致设计,游戏在笔记本上以流畅的120 FPS运行。按API价格算仅16美元,走订阅则"超级便宜"。
Theo最后把矛头对准OpenAI:"他们在所有最擅长的地方都输了。没有最聪明的模型,没有最高效的模型,没有最便宜的模型,没有最适合调用其他模型的模型。"他直言200美元的Codex套餐给他的实际代码产出,远不及同价位的Claude订阅。
结论
Sonnet 5.5是一个有趣的悖论:单看跑分和价格它并不惊艳,前端弱、token不省、直接用性价比不高。但作为Opus和Fable家族的编排工具,它在代码库深度审计、假设验证等侦查型任务上展现出惊人的速度与性价比。正如Theo所说,他本人不会常用这款模型,但他希望自己的Opus会用它——因为这里确实藏着真正的价值。
相关推荐

一场与Grok的对话能否影响重大决策?素材不足的警示
一则关于美国因与Grok对话影响委内瑞拉决策的Hacker News标题引发关注,但缺乏正文与信源。本文探讨此类耸动标题的识别方法与AI在决策中的真实边界。

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。