Anthropic发布Claude Opus 5.5:更快更省,对齐能力创新高
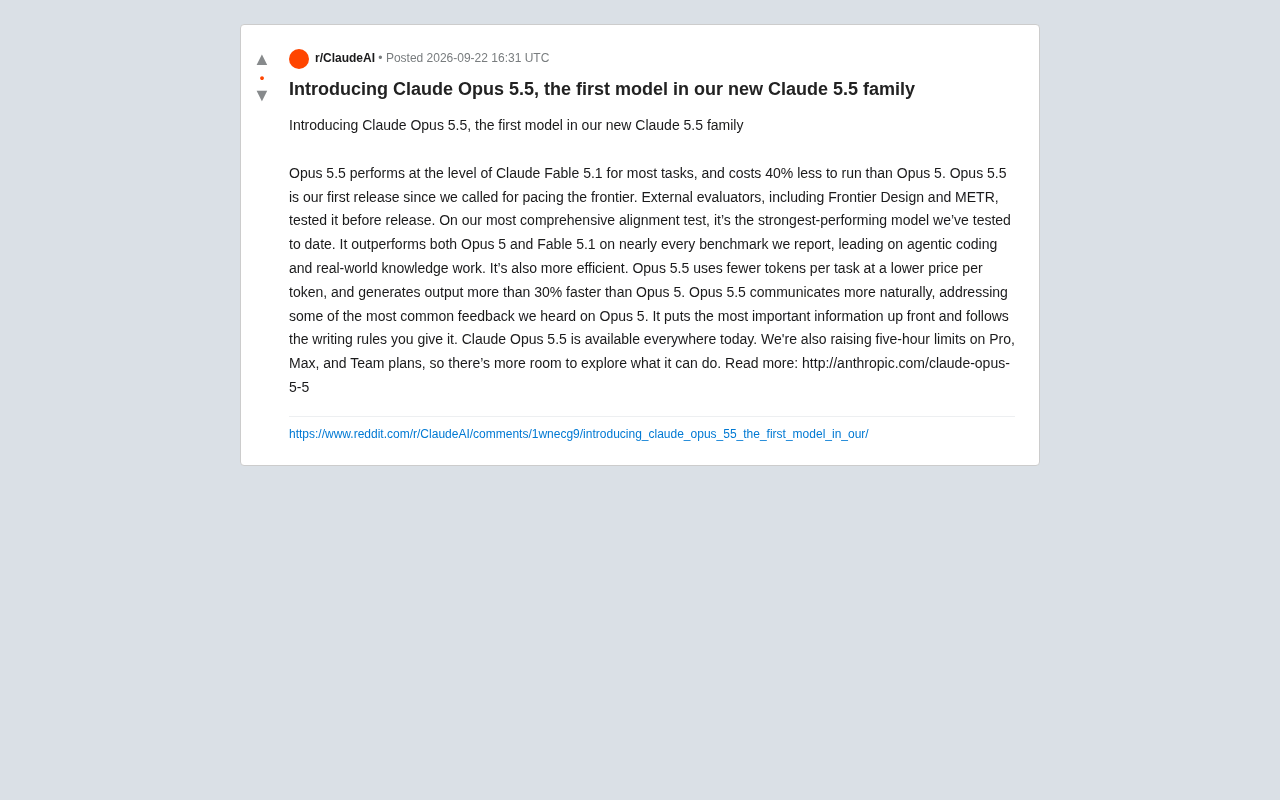
Anthropic发布Claude Opus 5.5:成本降40%、速度提升30%,对齐测试创历史最强。
Anthropic推出Claude 5.5家族首款模型Opus 5.5,核心亮点是在性能全面领先的同时大幅降低使用成本。与上代Opus 5相比,运行成本下降40%,生成速度提升逾30%,每任务token消耗也更少。模型在几乎所有报告基准上超越前代,尤以智能体编程和真实世界知识工作见长。安全方面,Opus 5.5在Anthropic迄今最全面的对齐测试中表现最强,并经METR、Frontier Design等独立机构外部评估,体现了Anthropic"能力与安全并进"的差异化定位。交互体验上,新模型沟通更自然、信息前置、更严格遵循用户规则。即日起全平台上线,Pro、Max、Team套餐同步放宽使用限额。
Anthropic正式推出Claude Opus 5.5,这是全新Claude 5.5家族的首款模型。这次发布之所以引人关注,不仅在于性能提升,更在于它是Anthropic提出"放缓前沿竞速"(pacing the frontier)主张后的第一款产品——某种程度上,它是Anthropic对自身安全承诺的一次实践检验。
性能与成本:用更少的钱做更多的事
Opus 5.5最直观的卖点是效率。根据官方数据,它在多数任务上的表现已达到Claude Fable 5.1的水平,但运行成本比Opus 5低了40%。这意味着对于依赖大模型批量处理任务的企业和开发者而言,同样的预算能撬动更多算力产出。
效率提升体现在三个维度:每个任务消耗的token更少、每个token的单价更低、生成速度比Opus 5快超过30%。这三者叠加,实际的成本与延迟改善会比单一指标更显著。对于agentic(智能体)类应用来说,速度和成本往往是决定能否规模化落地的关键瓶颈,Opus 5.5在这两点上的优化具有实际意义。
"放缓前沿竞速"(pacing the frontier)是Anthropic在2024年前后提出的一项政策主张,核心思路是:AI头部实验室应在部署最强能力模型前,确保安全评估与对齐研究能够跟上能力进步的速度,必要时主动放慢发布节奏。这一立场与OpenAI、Google等竞争对手的激进发布策略形成对比,也是Anthropic"负责任扩展政策"(Responsible Scaling Policy,RSP)的延伸。RSP规定,一旦模型达到特定危险能力阈值,必须满足对应的安全标准才能继续训练或部署。Opus 5.5作为该框架下通过外部评估后发布的模型,是这套体系的实际运行案例。
基准测试:几乎全面领先
Anthropic表示,Opus 5.5在其报告的几乎所有基准测试上都超越了Opus 5和Fable 5.1,尤其在智能体编程(agentic coding)和真实世界知识工作两个方向上处于领先地位。
这两个方向的选择并非偶然。智能体编程是当前大模型商业化最热门的战场,涉及代码生成、调试、多步骤自主执行等复杂能力;而"真实世界知识工作"则指向办公、研究、分析等高价值场景。Anthropic近年来在Claude Code等编程工具上持续投入,Opus 5.5在编程能力上的领先,延续了这一战略重心。
智能体编程(agentic coding)与传统代码补全有本质区别:它要求模型不只是生成单段代码,而是能够自主规划多步骤任务、调用工具、处理执行结果并根据反馈迭代修正,接近于一个"能独立工作的初级工程师"。评估这类能力的常用基准包括SWE-bench(模拟真实GitHub issue修复)和各类多步骤工具调用测试。Anthropic的Claude Code产品正是这一方向的商业落地,Opus 5.5在该领域的领先意味着其作为编程助手在复杂任务上的实用性进一步提升,而非仅限于简单的代码片段生成。
对齐测试:迄今最强表现
值得单独讨论的是安全与对齐方面的进展。Anthropic称,在其最全面的对齐测试中,Opus 5.5是迄今测试过的表现最强的模型。发布前,模型还接受了包括Frontier Design和METR在内的外部评估机构的测试。
引入第三方评估是Anthropic一贯强调的做法,也呼应了它"放缓前沿竞速"的立场——即在推进能力的同时,不牺牲安全审查的严谨性。将"最强对齐表现"与"能力全面领先"同时列为卖点,本身就是Anthropic差异化定位的体现:它试图证明安全性和能力并非零和关系。
METR(Model Evaluation & Threat Research)是一家专注于评估前沿AI模型潜在风险的独立研究机构,尤其关注模型在自主性、欺骗性行为和危险能力(如网络攻击、生化知识辅助)方面的表现。Frontier Design同样是专注于AI安全评估的第三方机构。引入这类外部机构的意义在于避免"自评自查"的公信力问题——如果只由开发商内部测试,结论的独立性天然受质疑。目前业界对于"对齐测试"尚无统一标准,各家厂商的测试框架和披露程度差异显著,因此外部评估机构的参与是提升透明度的重要机制,也是Anthropic区别于部分竞争对手的做法之一。
体验优化:回应用户真实反馈
Opus 5.5在交互体验上也做了针对性改进。Anthropic直言,这些改动是为了回应用户对Opus 5最常见的抱怨。
具体来说,新模型沟通更自然,会把最重要的信息放在前面,并且更严格地遵循用户给定的写作规则。对于长期使用Claude处理写作、总结类任务的用户,"信息前置"和"守规矩"这两点会明显改善使用感受——过去大模型冗长铺垫、不听指令的问题一直是高频吐槽点。
可用性与使用额度放宽
Claude Opus 5.5即日起在所有平台上线。同时,Anthropic放宽了Pro、Max和Team套餐的五小时使用限制,给用户更多空间去探索模型能力。
提高使用额度是一个务实的信号:结合前面提到的成本下降40%,Anthropic有底气让更多用户高频使用新模型,而不必担心算力成本失控。这种"降本"与"放量"同步推进的策略,往往意味着厂商对新模型的商业化前景有较强信心。
小结
Opus 5.5的看点可以概括为:性能全面提升、成本大幅下降、速度更快、对齐测试创新高,以及更贴合用户习惯的交互体验。作为Claude 5.5家族的开篇之作,它既是一次常规的能力迭代,也是Anthropic在"负责任地推进前沿"这一理念下的一次公开表态。对于开发者和企业用户,更低的成本和更高的额度是最实际的利好,值得实测验证其在具体工作流中的表现。
相关推荐
人类能离太阳多近?帕克探测器穿越日冕的科学原理
人类能离太阳多近?NASA帕克太阳探测器曾飞至光球层上方380万英里,深入数百万度的日冕。本文解析为何探测器不会被汽化——温度与热量的区别、阳光强度及隔热罩设计的科学原理。
从空气中制造汽油:合成燃料为何尚未普及?
合成燃料能用空气中的二氧化碳、水和电力制造汽油、甲烷和火箭推进剂。本文解析萨巴蒂埃反应与费托合成的化学原理、热力学税、碳中和账本,以及合成燃料为何尚未普及、又将如何重塑能源地缘格局。
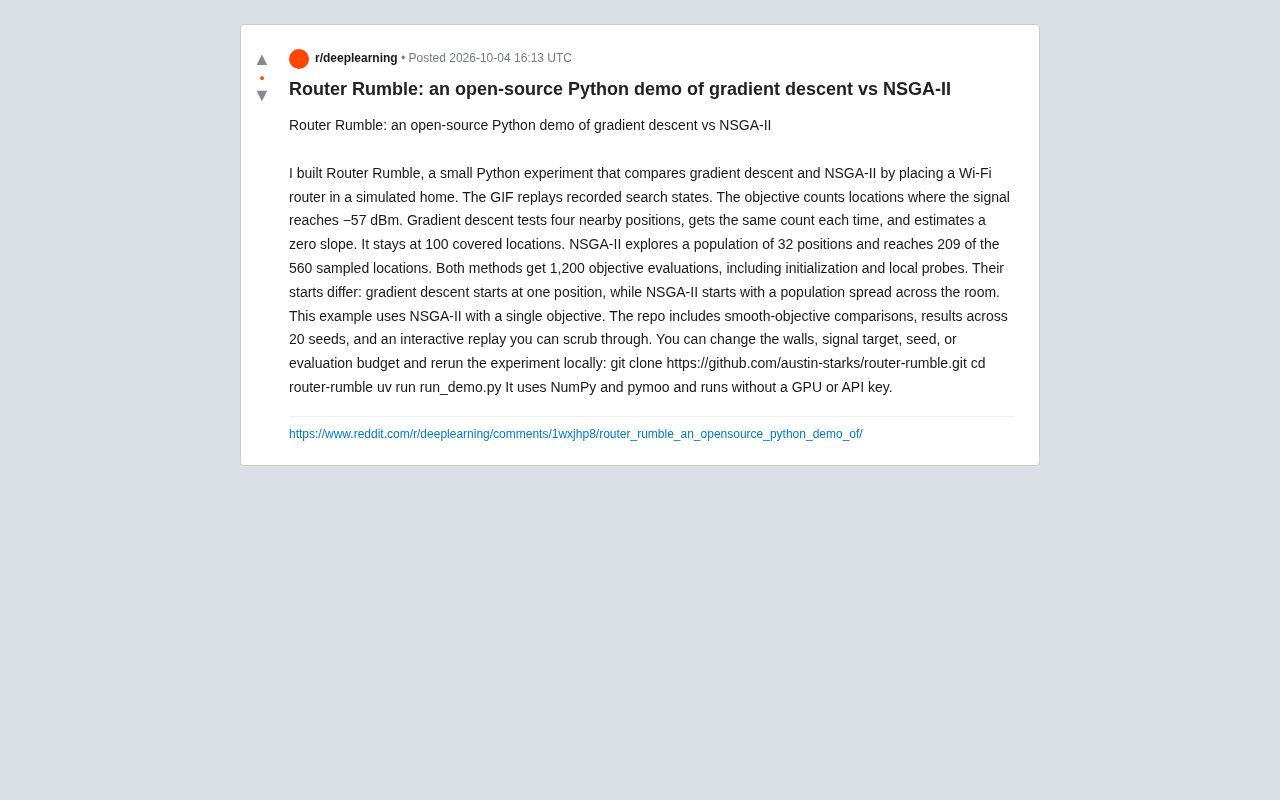
Router Rumble:用WiFi路由器演示梯度下降为何败给NSGA-II
Router Rumble 是一个开源 Python 项目,通过在模拟房间摆放 WiFi 路由器,直观对比梯度下降与 NSGA-II 进化算法在离散目标函数上的表现,揭示无梯度优化方法的优势。