Anthropic日合并3万代码,为何98%开源Issue无人认领?

Anthropic日均合并三万次代码,却有超98%的公开Issue无人负责,暴露反馈回路淤塞。
文章从 Reddit 上一则质疑出发,对比 Anthropic 每天超过 30,000 次代码合并的工程效率与 Claude Code 公开仓库中 16,060 个打开 Issue 里 15,766 个(超 98%)无负责人的现实。作者承认内部合并与开源 Issue 处理性质不同,但指出比例悬殊反映的是流程设计上的选择性忽视,而非单纯人力紧张。文中列举一个可追溯数月的 User-Agent 隐私问题,说明安全类报告长期滞留公开队列的风险,并质疑公司有余力做像素爱心彩蛋却不用 Claude 做 Issue 分诊。作者认为技术障碍不大,真正的阻碍在治理与优先级层面。
Anthropic 的工程博客曾透露,公司每天合并超过 30,000 次代码变更。这个数字放在任何工程团队面前都堪称惊人。但另一边,其公开的 Claude Code GitHub 仓库里,16,060 个处于打开状态的 Issue 中,有 15,766 个——超过 98%——没有任何负责人。两者并列,构成了一幅颇具讽刺意味的图景:一边是代码合并的流水线高速运转,一边是外部反馈的入口近乎淤塞。
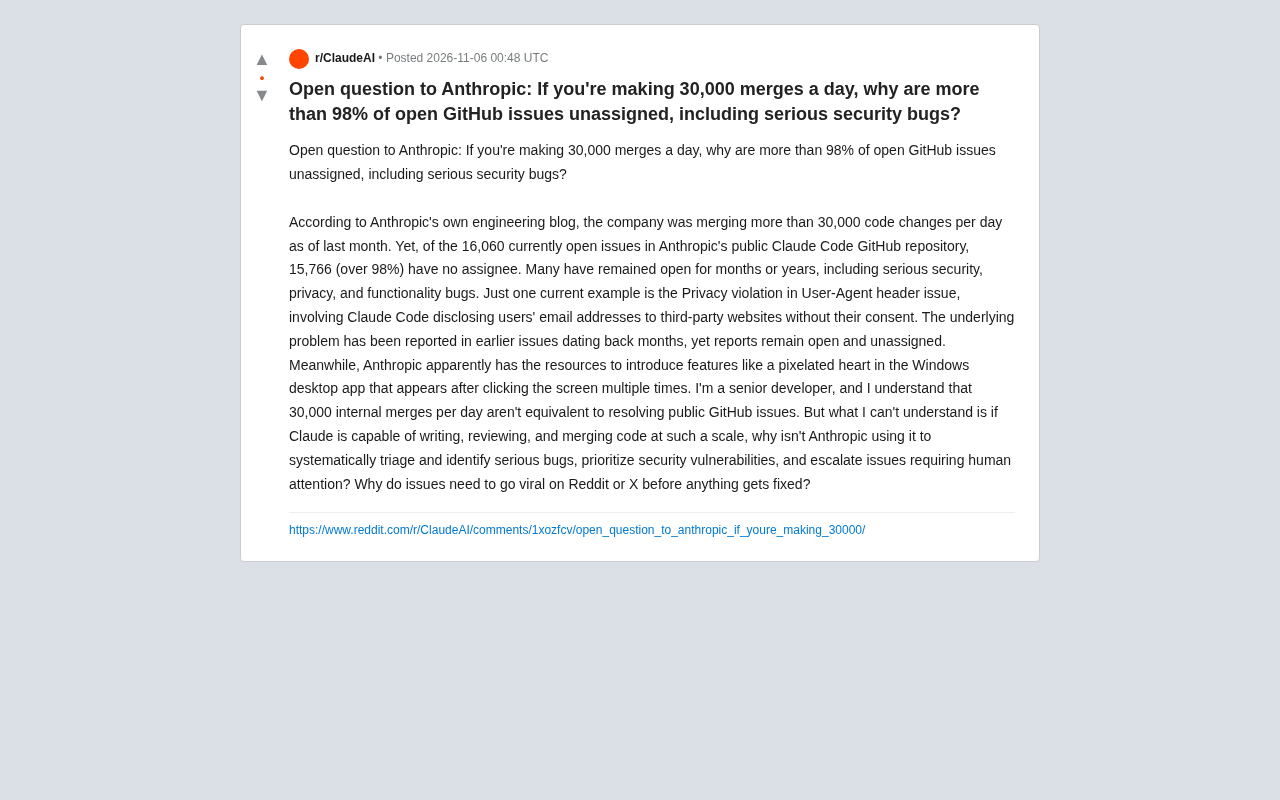
这个问题由一位自称资深开发者的用户在 Reddit 上提出,核心质疑并不复杂:如果 Claude 具备大规模编写、审查和合并代码的能力,为什么不用它来系统性地分诊 Issue、标记安全漏洞、把真正需要人处理的问题挑出来?
合并量不等于 Issue 处理量,但差距为何如此悬殊?
这位开发者自己也承认,每天 30,000 次内部合并与解决公开 GitHub Issue 并不是一回事。内部合并可能是小步提交、自动化重构、依赖更新,而开源 Issue 需要阅读、复现、判断优先级、分配人力。两者在性质上确实不同。
但问题在于比例。超过 98% 的未分配率意味着,绝大多数外部反馈连"被看见并指派"这一步都没有走到。许多 Issue 已经开放了数月甚至数年,其中不乏安全、隐私和功能性缺陷。一个健康的开源项目通常会有一定比例的 Issue 处于未分配状态,但当这个比例逼近全部时,它反映的就不再是人力紧张,而是流程设计上的选择性忽视。
代码合并(merge) 在 Git 工作流中指的是把一条分支上的提交整合进主干分支的操作。它通常以 Pull Request(PR)或 Merge Request 的形式经过评审后触发,单次合并可能只包含几行改动,也可能是一次依赖版本号的自动升级。因此"每天 30,000 次合并"衡量的是变更吞吐量,而非解决的问题数量——大量合并来自机器人、CI 自动提交和小步迭代,与人工阅读一条外部 Issue 所需的时间完全不可比。
Issue 分诊(triage) 借用自医疗领域,指在正式处理前对问题做初步归类:判断是否重复、评估严重程度、贴上标签、指派负责人或升级给特定团队。成熟开源项目通常有轮值或机器人辅助的分诊流程,未分配率是衡量反馈回路是否畅通的关键指标之一。
安全漏洞在队列里排队
帖子举了一个具体例子:一个关于 User-Agent 头的隐私问题,涉及 Claude Code 在未经用户同意的情况下向第三方网站泄露用户邮箱地址。该问题在更早的 Issue 中已有报告,时间可以追溯到数月之前,但相关报告至今仍处于打开且未分配的状态。
这触及了开源安全治理中最敏感的部分。安全类 Issue 的公开披露本身就有风险,如果长期无人响应,报告者既得不到修复反馈,也无法判断是否应该走其他披露渠道。更现实的后果是,问题可能一直停留在公开仓库里,直到被更多人注意到、在社交平台上发酵,才被迫进入处理流程。
帖子中那句反问相当尖锐:为什么问题必须先要在 Reddit 或 X 上 viral,才会被修复?
负责任披露(Responsible Disclosure) 是安全领域的通行惯例:发现者先私下通知厂商,给予其一段修复窗口期,之后再公开细节。厂商通常会在仓库中提供 SECURITY.md 或专门的安全报告邮箱作为私下渠道。当公开 Issue 长期无人响应时,报告者面临两难——继续等待可能无限期拖延,直接公开又可能让用户暴露在风险中。这也是为什么"安全问题必须先上社交平台才被处理"被视为治理缺陷:它把本应走私下流程的披露逼回了公开渠道。
资源分配的信号:像素爱心与安全漏洞
发帖者还提到一个细节:Anthropic 有资源为 Windows 桌面应用加入一个彩蛋式功能——多次点击屏幕后出现像素化的爱心——却在公开 Issue 的分诊上显得迟缓。
单个功能的存在当然不能证明资源错配,彩蛋可能只占极小的人力。但作为对外可见的信号,它确实容易被解读为优先级排序的体现。当安全漏洞和隐私问题在队列中等待数月,而面向用户的趣味功能照常上线,外部贡献者和用户自然会质疑:这个项目的反馈回路到底服务于谁?
用 Claude 分诊 Issue,技术上有障碍吗?
这是整篇帖子最值得认真对待的部分。发帖者并不是在要求 Anthropic 用 AI 取代人工修复,而是提出一个更窄的设想:用 Claude 来做 Issue 的初步分诊——识别重复报告、按严重程度归类、标记安全相关条目、把需要人类判断的问题升级出来。
从能力上看,这类任务恰恰是当前大模型比较擅长的:文本分类、相似度匹配、信息抽取、优先级初判。技术障碍并不明显。真正的问题可能在于治理层面——自动分诊会不会误判、公开仓库的 Issue 是否值得投入工程资源去搭建流水线、以及当公司自身的合并节奏已经极快时,外部 Issue 在内部优先级列表上排在什么位置。
发帖者的观察点是:Anthropic 对外展示的工程能力与对外部反馈的处理速度之间存在明显落差,而这个落差本可以用它自己卖的产品来弥合一部分。这个质疑成立与否,取决于 Anthropic 是否愿意把 Claude 用在自家开源项目的维护上,而不只是用在代码生产端。
自动分诊在工程上通常由规则引擎、分类模型和最近邻检索组合实现:用文本嵌入计算 Issue 之间的相似度以识别重复,用分类器打上组件与严重程度标签,再按置信度决定是否升级给人工。大语言模型在此类任务上的优势是无需为每个仓库手工编写规则,可直接读取标题、正文和评论做语义判断;局限则在于误判成本——把安全 Issue 错标为普通问题,或把重复报告错误合并,都可能造成新的信息丢失。因此实践中多采用"AI 初筛 + 人工复核"的混合模式,并把模型输出作为建议而非最终指派。
这不是一家公司的问题
把视角拉远,Claude Code 仓库的处境在 AI 公司中并不孤立。快速迭代的产品、大量涌入的外部反馈、有限的开源维护人力,三者叠加很容易产生高未分配率的 Issue 队列。区别在于,Anthropic 恰好是少数同时拥有大规模代码自动化能力和大量公开 Issue 的公司,因此这个矛盾在它身上格外显眼。
对使用 Claude Code 的开发者来说,这件事的实际含义是:提交 Issue 未必能得到响应,安全类问题的披露路径需要自己多留一手。对 Anthropic 来说,30,000 次合并是工程效率的证明,但 98% 的未分配率是另一份成绩单,而后者同样会被社区看见。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。

Commodore 64经典赛车游戏迎来Driver AI
探索Commodore 64经典赛车游戏《Stunt Car Racer》中的Driver AI实验,了解在资源受限的8位平台上实现自动驾驶AI的技术挑战与启示。

黄仁勋若被替换,开源AI会否生变?Reddit激辩
Reddit网友激辩:如果黄仁勋被替换,英伟达会反对开源AI吗?讨论指出英伟达支持开源AI源于商业利益,需拓宽GPU客户群,而非一人决策。