Anthropic如何用Claude在两周内让Claude.ai提速3倍
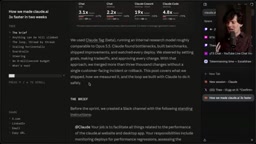
Anthropic用Claude自身将产品核心体验提速3倍,但激进缓存策略同时引入了数据一致性回归。
Anthropic在两周内将Claude.ai和桌面应用的核心路径提速约3倍,方法论核心是"先让模型能测量、再优化":借助Valgrind指令计数和React commit次数等确定性指标在实验室中验证改进,并在CI流水线中设置单向递减护栏防止回归。技术博主Theo肯定了这套工程方法论,同时在实测中发现激进缓存导致侧边栏不失效、线程刷新丢失等数据一致性问题——这正是以减少网络请求为目标的指标驱动优化的典型副作用。文章还延伸到工程文化讨论:Anthropic作为最早大规模实验"让AI写太多代码"的公司,正在用更强的模型清理自己积累的技术债;而"读代码不再是解决性能问题的关键、与AI生成的slop共事"正成为新的工程范式。
Anthropic最近发布的一篇文章引发了开发者社区的热烈讨论:他们在两周内将Claude.ai和Claude桌面应用的核心用户体验提速了约3倍,而完成这件事的主力恰恰是Claude自己。YouTube技术博主Theo(T3生态创始人)对这篇文章做了一次深度拆解,既肯定了其中的工程方法论,也毫不留情地指出了随之产生的性能回归问题。
性能提升的真实数据
根据Anthropic的说法,他们聚焦于占用户活动95%的四条核心路径:启动应用、开始对话、加载已有对话、发送消息。在75分位数的测量下,Claude.ai的首次加载从3.1秒降到了0.55秒,启动新Claude Code会话从0.8秒降到0.3秒,加载Claude co-work会话从近3秒降到了1秒以内。
更细粒度的数据同样惊人:co-work中发送消息从1秒降到48毫秒,桌面端的Claude Code从250毫秒降到52毫秒。Anthropic估计这些改进每天为用户节省了数万小时的等待时间。
Theo作为长期的性能发烧友,确认了自己确实感知到了这种差异。他甚至在更早的时候就注意到Claude.ai在移动热点下的加载速度明显变快,并发现他们已经迁移到了TanStack Router这类更利于处理导航场景的框架。
核心方法论:先测量,后优化
整个优化过程最被反复强调的一句话是——「一旦Claude能够测量某件事,它就能让它变快,于是我们不断寻找更多可以测量的东西」。
Anthropic先让Claude通过Datadog MCP服务器分析使用数据,识别出四条最高影响力的用户旅程,拆解为13个独立的测量点。他们为每个点建立基线仪表,确保每次测量都从用户交互开始、到结果渲染结束,并明确区分客户端与服务端的工作。
Theo特别认同这一点。他回忆起过去在职场中无数次因为性能问题与人争论的经历:对方的仪表盘显示某操作只花了200毫秒,但那只是从组件渲染到加载完成的时间,而不是从页面加载到真正可交互的全过程。「如果到达那一步花了8秒,那你的trace根本不重要。」衡量错误是性能工作中最常见的陷阱。
他们如何让Claude在实验室里验证改进
为了让Claude能异步工作数小时甚至通宵,Anthropic不满足于依赖线上部署后的真实数据,而是构建了可以在「实验室」中衡量性能的确定性指标。
对于纯JS热路径,他们用Valgrind配合node --predictable来测量指令计数,一次运行即可比对基线,无需统计学处理。对于浏览器路径,由于Chromium下无法做指令计数,他们改用一系列确定性计数:React每次交互的commit次数、V8精确覆盖率提供的函数调用次数、布局与样式重算次数、DOM变更次数。
关键在于,他们对每个新基准都保持怀疑态度:每个基准有两个任务——既要成为Claude能在实验室中优化的指标,又要作为CI中的护栏,数字只能单向下降(ratchet down)。如果某个基准不稳定或与真实用户延迟不相关,就直接丢弃,而不是让Claude去爬错误的山。
Theo对这一做法深有共鸣。他在T3 Code的数据层优化中最重要的改动并非性能代码本身,而是搭建了一个GitHub Action,用真实请求格式测试数据加载量,从而防止回归。这个「slop测试套件」可能有数千行,他承认自己根本没细读代码,但它持续地阻止了回归发生。
Valgrind 是一个经典的 Linux 程序分析框架,其核心工具 Callgrind 可以模拟 CPU 执行并统计每条指令的调用次数,从而产生与实际时钟时间无关的确定性度量。node --predictable 是 V8 引擎的一个特殊标志,关闭了随机化的垃圾回收调度与 JIT 编译的不确定性,使得同一段代码在两次运行中产生几乎完全相同的指令序列。两者结合后,性能对比不再依赖「跑 100 次取均值」的统计学方法,而是可以用单次运行的指令差值直接判断某次代码改动是快了还是慢了。这种方式对 CI 流水线尤为友好:不需要专用的高性能机器,也不受系统负载波动影响,任何一台普通 runner 都能给出可重复的结果。代价是它只能覆盖纯 Node.js 路径,无法模拟浏览器内的渲染行为,这也是 Anthropic 对浏览器场景另辟一套基于 React commit 数和 V8 覆盖率计数的原因。
被忽视的代价:过度缓存引发的数据回归
Theo在直播中实测了Claude.ai,发现性能确实变好了,但也暴露出严重的数据一致性问题。他在一个浏览器中删除了侧边栏的会话,刷新另一个浏览器后,被删除的会话依然显示,点击会报错却永远不会重新校验侧边栏。提交新prompt时,线程甚至可能在持久化到侧边栏之前就因刷新而「永久消失」。
他的判断是:Anthropic通过「让东西永远不更新」来提升性能——缓存过于激进,而缓存失效却远远不够频繁。他推测,当Claude盲目地以减少React commit或V8调用次数为目标时,很容易关掉那些并不真正影响可交互性的网络请求,比如不再及时从网络同步侧边栏数据。这正是指标驱动优化的风险所在:V8调用计数看不到页面何时变得可交互,但能看到每一个请求,于是agent倾向于粗暴地砍掉请求。
Theo的解法与之不同:在T3 Chat中,加载态下的旧数据以淡化模糊的样式显示,直到从服务器拿到真实数据才取消淡化,避免对不准确的数据表现出自信。
这里描述的问题在前端工程中有一个专门的术语——stale-while-revalidate(SWR)策略滥用。SWR 的本意是:先立刻返回缓存中的旧数据以加快渲染,同时在后台发起网络请求更新数据,新数据到达后再替换界面。这一策略能显著改善感知速度,但前提是必须有配套的缓存失效(cache invalidation)机制:当用户执行了写操作(删除、创建、修改),相关缓存条目必须立即标记为脏数据,否则下次读取时旧数据仍会被当作有效值展示。Anthropic 的回归正是失效逻辑不完整的典型表现——删除会话后,侧边栏列表的缓存未被清除,导致跨标签页或刷新后幽灵条目持续出现。这是分布式系统领域著名的「缓存失效是计算机科学中最难的问题之一」的 Web 端具体案例。当优化指标(减少网络请求次数)与数据正确性目标(及时同步状态)未被同等纳入护栏时,agent 的局部最优解很容易在全局层面制造这类静默错误。
工程文化之辩:会做模型不等于会做软件
文章还引出了一场关于工程文化的讨论。Convex的Jamie评论道:「擅长做模型的公司未必擅长软件工程。」Theo进一步延伸了这个观点。
他认为Anthropic实际上是第一家大规模实验「让AI写太多代码会怎样」的公司。由于在Sonnet 4时期大量使用模型生成代码,他们积累了一个充满slop的代码库,而现在正用更强的模型回头清理自己制造的烂摊子——Claude.ai、桌面应用乃至Claude Code本身,都是这种dogfooding的产物。
他还抛出一个大胆的观点:OpenAI与Anthropic的根本分歧,可能不只是安全理念,更是工程与研究文化的差异。OpenAI由工程师主导,用工程标准要求研究者;而Anthropic相对不那么重视软件工程师,这反过来影响了他们的工程招聘质量。「难以自动化你不理解的东西,也难以理解你不尊重的东西。」
值得借鉴的工程实践
抛开争议,Theo认为这篇文章里有大量可学习的工程智慧:
- 保持composer常驻:在会话间不卸载composer,并在用户悬停时预取会话,使重渲染减少了90%,导航感觉快到离谱。
- 横向扩展:一旦端到端流程跑通,就能在多台机器、多个实例上并行开出大量线程。Theo自己的agent曾自动合并了40个性能优化PR,其中38个是真实收益。
- 大胆地prompt:Anthropic的工程师会用「be ambitious」「boil the ocean」「我开放各种疯狂的想法」这类措辞激励模型。Theo解释,这些词能把模型从安全的「happy path」拉向更激进但往往更有效的路径——前提是你有足够的护栏兜底。
- 处理非拉丁字符的妙招:Claude发现只要Markdown中含有一个弯引号或em dash这类非Latin-1字符,V8就会把整个字符串按UTF-16存储,导致语法高亮的正则走上更慢的双字节路径。一个20行的改动(高亮前先把代码块转成单字节字符串)就解决了问题。
Theo也给出了自己更进一步的建议:把语法高亮搬到Web Worker里用Wasm执行,彻底不阻塞主线程。
文中提到的 V8 字符串存储问题涉及 JavaScript 引擎的一个底层细节:V8 对字符串有两种内部表示,若内容全部落在 Latin-1(ISO 8859-1)范围内(即码点 0–255),则以每字符 1 字节的 one-byte string 存储;一旦包含任何超出此范围的字符(如弯引号 '、em dash —,或任何 CJK 字符),整个字符串会被升级为每字符 2 字节的 two-byte(UTF-16)string。正则表达式引擎针对这两种编码有不同的执行路径,two-byte 路径的吞吐量在密集匹配场景下可能慢数倍。对于语法高亮这类需要对代码块反复运行大量正则的场景,这一差异被成倍放大。Anthropic 的修复思路——高亮前先将代码块转为单字节字符串——属于一种「降级编码」技巧,牺牲了字符串的原始表示,换取正则在 one-byte 快速路径上执行。这类隐性性能陷阱通常不会出现在 JavaScript 语言规范或常见性能教程中,需要对引擎内部机制有相当深度的了解才能定位,也侧面印证了「让模型先找到可测量指标」的方法论价值——没有指令计数这把尺子,这个问题几乎不可能从源码层面被发现。
新时代的工程能力
Theo在结尾强调了一个颇具争议但他深信的观点:读代码已不再是解决这类问题的关键。他没有Anthropic的仓库权限,仅凭阅读博客和Claude的回复,就凭直觉推断出了侧边栏回归可能的成因。这种直觉来自他近十年手工优化性能的积累。
「如果你还认为读完所有代码就能解决这些问题,那你会遇到另一整套问题。学会与slop共事、绕过slop,正在成为新的meta。」这是一种需要新式巧思的工程——搭建让agent高效运作的系统与结构。
这篇文章最大的启示在于:如果你只是告诉模型「提升性能」,它会基于自己的理论尽力而为;但如果你让它「先找到衡量性能的方法、验证这些发现、然后再去优化」,效果会好得多。
相关推荐

AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。

@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。

ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。