Anthropic双版本登顶智能指数,API费降20%
Anthropic双版本同底座登顶并降价20%,模型竞争转向性价比与场景贴合。
文章梳理了同一天内 AI 领域的多条动态:Anthropic 发布 Fable 5.2 与 Mythos 5.2,共享同一底座、评测得分 65 登顶智能指数第一,同时 API 调用费下调 20%,以「同底座双版本」降低开发者选型成本;Google 新增两款第八代 TPU,一年内该代产品达四款,8i Max 通过封装两颗 8i 实现算力翻倍;Meta 推出主打小而快的 Muse Ember,每百万输入 token 定价 0.1 美元,专攻智能体重复任务;安全侧,研究指出 Claude Code 会将批处理命令原文写入项目文件,导致密码与令牌明文落盘;开源侧则有蚂蚁灵波 Limbo Touch 触觉基础模型与百度 Ernie Evolve 自动研究系统。整体指向模型竞争从「谁更强」转向「谁更划算、更贴合场景」。
Anthropic 在同一天抛出两个版本:Fable 5.2 与 Mythos 5.2,底座同源,评测得分 65 登顶智能指数第一。这不是一次简单的新模型发布,而是一套组合拳——用同一底层模型切出不同定位,同时把 API 调用费压低了 20%。
据 B 站科技区 UP 主梳理,这条消息的看点不在跑分本身,而在「双版本同底座」背后的产品策略,以及它对开发者调用成本的实际影响。
双版本同底座:一个模型,两种卖法
Fable 5.2 和 Mythos 5.2 共享同一个底层模型,评测得分均为 65,位列智能指数榜首。这种「同底座、双版本」的做法在业内并不常见——过去更主流的思路是为不同场景训练不同尺寸的模型,参数和算力投入差异明显。
Anthropic 选择的是另一种路径:底层能力不做区分,差异体现在版本定位上。对开发者来说,这意味着选型成本降低,不用在「强但贵」和「弱但便宜」之间反复权衡;对 Anthropic 来说,一次训练投入可以覆盖两条产品线,边际成本更低。
配合 API 调用费下降 20%,这套组合的意图很清晰:用评测榜首建立技术信任,用降价降低接入门槛,把开发者往自家生态里拉。
所谓「智能指数」(Intelligence Index),是部分第三方评测机构用于横向比较大模型综合能力的聚合指标:把数学推理、代码生成、指令遵循、知识问答等多类基准测试的得分归一化后加权汇总,得到一个便于排序的单一分数。它的价值在于可比较性,方便开发者快速定位模型所处梯队;局限在于权重选择带有主观性,且榜单成绩与真实业务场景的表现未必一致。因此 65 分登顶更多是营销与技术信任层面的信号,实际选型仍应结合自身任务做小样本验证。
Google TPU 继续堆料:第八代已出四款
同一天,Google 新增两款第八代 TPU,使得一年内发布的第八代 TPU 总数达到四款。其中 8i Max 把两颗 8i 封装在一起,算力达到两倍。
这个节奏值得注意。TPU 的迭代周期在缩短,而且产品线在细分——不是一款芯片打天下,而是围绕不同负载切出多个 SKU。8i Max 的封装思路本质上是「用互连换算力」,在单芯片性能提升放缓的背景下,通过封装层面的整合继续推高单节点算力上限。
对云厂商而言,自研芯片的密度和节奏,正在成为算力成本竞争的关键变量。Anthropic 降价 20% 的底气,某种程度上也来自上游算力供给的持续宽松。
TPU(Tensor Processing Unit)是 Google 自研的专用 AI 加速芯片,采用 ASIC 路线,针对矩阵乘法等张量运算做硬件级优化,与通用 GPU 相比在特定训练和推理负载上能效更高。其迭代以「代」为单位编号,每一代通常面向更新的模型规模与精度需求(如更低精度算力、更大显存带宽)。所谓 SKU 细分,指同一代芯片按算力、内存、互连能力切出多个型号,分别适配训练、推理、高密度部署等不同负载,这也是云厂商自研芯片的普遍做法。
Meta Muse Ember:把「小而快」押在智能体上
Meta 发布的 Muse Ember 官方定位是「体积最小、效率最高」,主攻智能体重复任务,定价为每百万输入 token 0.1 美元。
这个定价放在当前的模型市场里属于相当激进的位置。智能体场景的特点是调用频次高、单次任务简单、对延迟敏感,对模型「聪明程度」的要求反而低于对稳定性和成本的要求。Muse Ember 的产品定义几乎是对着这个场景写的。
这也反映出一个趋势:模型厂商不再只卷榜单分数,开始针对具体工作负载做专用化产品。通用大模型负责上限,小模型负责跑量,两者在智能体架构里各司其职。
智能体(Agent)指能够自主规划、调用工具、多轮执行任务以完成目标的 AI 系统,通常由大模型作为决策核心,配合工具调用、记忆与编排框架构成。其成本结构与聊天场景差异明显:一次用户请求可能触发数十次模型调用(规划、反思、工具结果解析等),token 消耗被成倍放大,因此单位 token 价格和推理延迟对总成本的影响远高于单次对话质量。这也解释了为何厂商开始为智能体高频、短任务、低延迟的负载专门设计小尺寸模型。
安全在补课:Claude Code 明文落盘问题
据 AP Arrow 研究,Claude Code 会把批处理命令原文写进项目文件,命令里夹带的密码与令牌随之明文落盘。
这是一个典型的「便利性优先、安全性补课」问题。AI 编程工具为了可追溯和可复现,倾向于把执行过程完整记录到项目目录里,但开发者往往在命令行里直接传参,敏感信息就这样进了文件系统。如果这些文件被提交到版本库,风险会进一步放大。
对使用 AI 编程工具的团队来说,这件事的提醒很直接:把密钥管理从命令行参数里挪出去,改用环境变量或密钥管理服务,并且在项目配置里显式排除这类记录文件。工具自身的安全设计也需要跟上,记录执行过程和安全隔离不该是二选一。
将密钥写入命令行参数是一种常见但危险的实践。在多数操作系统中,命令行参数会出现在进程列表、shell 历史文件(如 .bash_history)、系统日志与审计记录中,任何有本机读取权限的进程都可能获取。相比之下,环境变量、系统密钥链或专门的密钥管理服务(如 Vault、云厂商 KMS)提供了访问控制与轮换能力。安全工程中的通行原则是最小暴露面:敏感凭据不应进入可被持久化或转发的数据通道,包括日志、项目文件和版本库提交记录。
开源侧:蚂蚁灵波 Limbo Touch 与百度 Ernie Evolve
蚂蚁灵波开源了触觉基础模型 Limbo Touch,把异构触觉信号编码成统一的触觉 Token,面向机器人操作场景。
触觉数据的异构性一直是机器人领域的难点——不同传感器、不同采样率、不同物理量纲,很难像图像那样直接喂给模型。统一成 Token 的思路,本质上是把触觉拉进和语言、视觉相同的建模范式里,这对具身智能的基础设施建设有实际价值。
百度则发布了自动研究系统 Ernie Evolve,用双层循环组织方向选择与实验迭代,由 5 个角色分工推进研究。这套系统的思路是把科研流程拆解成可编排的智能体角色,用循环结构替代单次生成。自动研究赛道近期热度上升,但实际效果仍需更多公开验证。
一句话总结
旗舰模型在比价,算力在扩产,安全在补课。Anthropic 用双版本加降价抢开发者,Google 用 TPU 密度压成本,Meta 用小模型切智能体场景——三条线指向同一个方向:模型竞争正在从「谁更强」转向「谁更划算、更贴合场景」。
相关推荐
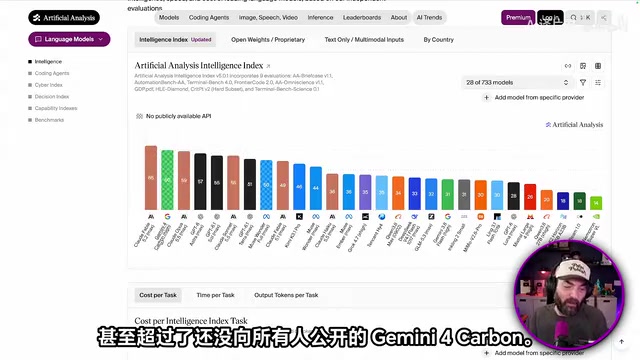
Anthropic发布Fable 5.2:号称全球最强AI模型
Anthropic发布Fable 5.2与Mythos 5.2,多项基准创纪录,科研任务提升显著。本文解析其基准表现、游戏与硬件实测、API定价,以及它究竟适合哪些用户。
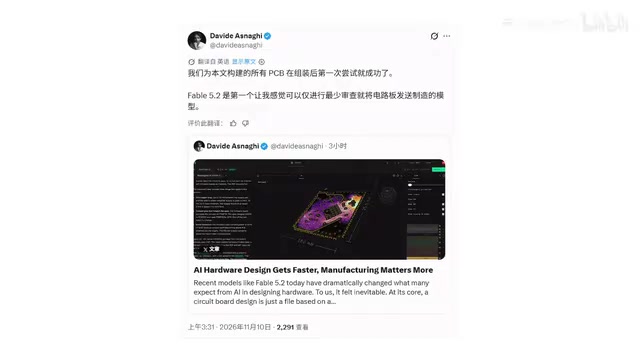
Claude Fable 5.2实测:1000智能体30小时证明费马大定理
Claude Fable 5.2与Mesos 5.2发布:1000个AI智能体30小时形式化证明费马大定理,价格降20%、速度提升30%,在电路设计、物理、化学、运筹与网络安全任务中展现长链条工程能力,同时被主动限制AI自我改进。
当AI遇上政治讽刺:Hegseth言论引爆的舆论风暴
一段YouTube政治讽刺节目引发热议,聚焦美国防长赫格塞斯过往关于女性参战的争议言论,以及其面临的性侵指控与母亲批评信。本文梳理事件核心争议与舆论反应。