Anthropic新研究:AI记忆如何避免「记错」?
Anthropic实验揭示AI跨会话记忆既能提升性能,也可能固化错误,关键在于证据驱动的维护。
Anthropic于11月6日发布的报告测试了在会话之间保存笔记的智能体,发现记忆机制具有两面性。在数据库任务中,跨会话保存的笔记显著提升了平均基准分数,且更强的模型能记录经过测试的规则并纠正错误答案;但在游戏实验中,笔记包含错误的位置信息,智能体通过对照原始对话记录才发现并修正了该错误。报告由此提出三条实践建议:保留证据、测试记忆中的规则、纠正过时笔记。Anthropic强调这些属于内部评估,不能外推为通用可靠性证明,但为开发者指明了方向——有用的记忆系统不是被动存储,而是证据驱动、持续维护的知识库。
记忆的两面性:从「记住」到「记对」
AI助手能否从昨天的错误中学习?Anthropic在11月6日发布的一份报告探讨了让记忆变得有用的关键因素。该研究测试了在会话之间保存笔记的智能体,发现记忆机制既能提升性能,也可能固化错误——关键在于如何设计和使用记忆。
据AI Uncovered Lab HQ的晨间新闻报道,在一项数据库任务中,保存的记忆显著提升了Claude 5.5的平均基准分数;更强的模型能够记录经过测试的规则并纠正错误答案。然而,记忆同样可能保留错误。
这揭示了一个被忽视的工程问题:记忆不是简单的「存储越多越好」,而是需要配套的验证与纠错机制。
实验证据:记忆何时有用,何时有害
Anthropic的测试覆盖了不同类型任务,展示了记忆的双刃剑效应。
数据库任务:记忆带来性能提升
在数据库任务中,智能体将跨会话保存的笔记作为上下文,其平均基准分数得到改善。更强的模型表现更为突出——它们不仅记录规则,还会对规则进行测试,并在发现错误时予以纠正。
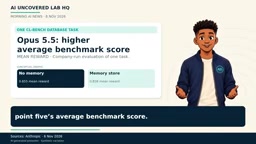
这说明模型能力与记忆质量存在正向关联:能力越强的模型,越能有效利用记忆,而不是被记忆中的噪声误导。
游戏实验:对照原始记录纠正错误
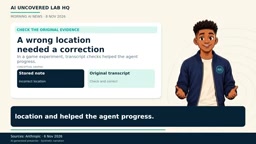
记忆并非总是可靠。在一个游戏实验中,智能体保存的笔记包含了一个错误的位置信息。当它对照原始对话记录检查笔记时,纠正了该错误,并因此推动了任务进展。
这个案例的核心启示是:记忆需要可追溯的证据源。原始记录(如对话transcript)为验证记忆提供了基准,使智能体能够发现并修正过时或错误的笔记。
会话间记忆(Cross-session Memory) 指智能体在多次独立对话之间持久化保存信息并在后续会话中调用的机制。常见的工程实现包括:将摘要或笔记写入外部存储(如向量数据库、键值存储或文件),在下一轮会话开始时作为系统提示或检索上下文注入。与依赖单次上下文窗口的临时记忆不同,跨会话记忆面临信息过时、冲突累积和错误固化的风险,因此需要配套的写入策略、检索策略与验证机制。Anthropic实验中的「保存笔记」正是这一机制的简化形态。
基准分数(Benchmark Score) 是衡量模型在标准化任务集上表现的量化指标,通常由一组带有标准答案或可自动判定的任务构成,取平均正确率或通过率作为分数。基准分数的价值在于可复现与可比较,但其局限也明显:任务分布固定、评分标准单一,高分不一定代表在开放场景中的可靠性。因此,跨会话记忆带来的分数提升应被理解为「在该任务分布下有效」,而非普遍能力的证明,这也是Anthropic强调其结果为内部评估的原因之一。
对话记录(Transcript) 指智能体与环境交互的完整原始日志,包含用户输入、模型输出、工具调用及其返回结果。与经过压缩或摘要的「笔记」相比,transcript保留了完整的证据链,可以被回溯、检索和比对。在记忆系统中,transcript通常作为事实来源(ground truth)使用:当笔记中的结论与原始记录冲突时,以transcript为准进行校正。这也解释了为何「保留证据」成为实践建议的第一条——没有可追溯的原始记录,记忆中的错误就无从发现。
对构建者的实践建议
这些发现来自Anthropic自身的评估,并不构成对通用可靠性的证明。但报告为智能体开发者提供了可操作的经验。
保留证据:记忆条目应关联原始来源,而非仅存结论。这样在后续会话中才有验证的依据。
测试记忆中的规则:不要假设保存的规则始终有效,智能体应在使用前进行验证。
纠正过时笔记:当记忆与当前证据冲突时,优先以原始记录为准,及时更新或删除失效内容。
这些原则指向一个共同方向:有用的记忆系统不是被动存储,而是主动维护的、证据驱动的知识库。
记忆可靠性的边界与开放问题
Anthropic明确表示,这些结果属于内部评估,不能外推为普遍可靠性。不同任务、不同模型对记忆的利用方式可能存在差异。
从工程角度看,记忆的可靠性问题本质上是知识管理问题:如何表示、验证和更新跨会话的知识。当前实验提供了初步证据,但距离通用解决方案仍有距离。对于构建AI助手的团队而言,将记忆视为需要持续维护的资产,而非一次性写入的缓存,可能是更务实的态度。
AI Uncovered Lab HQ的报道以一句简洁的总结收尾:保存证据,测试记忆中的规则,修正过时的笔记。这三条建议,或许正是让AI「记住对的事」的起点。
知识管理视角下的记忆 借鉴了人类组织管理知识的框架:知识需要被表示(结构化存储)、验证(与证据比对)、更新(淘汰过时内容)和检索(在正确时机调用)。在AI智能体语境中,这意味着记忆系统不能只关注写入吞吐量,还要设计版本控制、冲突检测与过期策略。将记忆视为需要持续维护的资产而非一次性写入的缓存,正是这一视角的核心主张,也解释了为何实验结论强调「主动维护」而非「存储更多」。
相关推荐
Claude Code额度不够用?实测哪些技巧真省额度
实测 Claude Code 20美元套餐:换用 Sonnet 或 Haiku、降低 effort 能让同样任务额度减半以上,而 /clear、/compact、plan mode 等流传技巧在短会话中几乎不省额度甚至更贵。
AI智能体记忆全解析:四层结构与“做梦”机制
解读Anthropic智能体记忆研究:记忆的四层架构、以CLBench和宝可梦实验检验“该记什么”,以及通过“做梦”修正笔记、构建wiki、提升上下文注入质量的机制与局限。
Anthropic智能体记忆架构:少即是多的记忆哲学
Anthropic通过Pokemon Red实验揭示智能体记忆的反直觉结论:保存413个文件的Claude反而不如维护简短仪表盘的Claude。本文解析四层记忆架构、Dreams离线修正机制与CLAUDE.md最佳实践。