Anthropic研发提速2倍的真相:METR报告深度拆解

METR外部评估称Anthropic过去一年AI研发提速约2倍,八成归因于AI辅助。
METR对Anthropic内部数据进行了十一周审查,判断其过去一年在AI测试上的推进幅度约等于此前两年,整体提速约2倍,区间为1.3至3倍。约80%的提速可能来自AI对员工的辅助,而非招聘或流程重组,但人类仍掌握方向与架构决策。报告最具信息量的证据被涂改处理,因此2倍属于方向性判断而非精确测量。Anthropic曾在八月称AI尚未让研发翻倍,METR认为这一自我判断过于自信。仅计入其他实验室模型时整体提速约为1.4倍,说明内部模型杠杆效应更强。
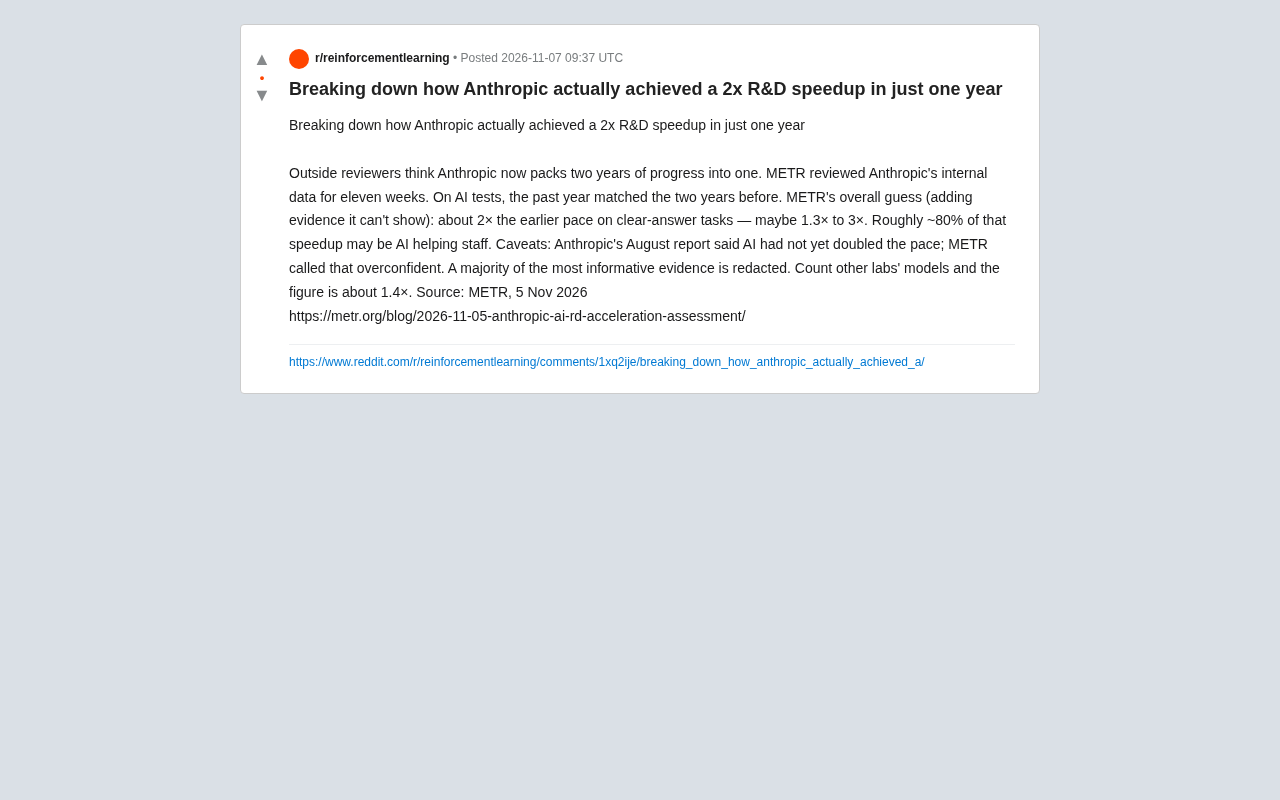
一份外部评估,揭开了Anthropic「一年顶两年」的底牌
AI公司用AI加速AI研发,这件事正在从愿景变成可测量的现实。METR对Anthropic内部数据做了长达十一周的审查,结论是:过去一年Anthropic在AI测试上的推进幅度,相当于此前两年的总和。换句话说,研发节奏大约翻了一倍。
这个数字之所以值得认真对待,是因为它不是Anthropic自己说的。METR是外部评估机构,报告中明确区分了「有据可查的部分」和「基于额外证据的整体推测」。翻倍这个结论属于后者——METR给出的区间是约1.3倍到3倍,中位估计在2倍左右。区间很宽,说明不确定性真实存在,但方向是清晰的。
更关键的归因是:这轮提速中大约80%可能来自AI对员工的辅助。也就是说,不是招聘扩张、不是流程重组的功劳,而是模型在帮人做研发本身的工作。
METR(Model Evaluation & Threat Research)是一家专注于前沿AI模型能力评估的独立研究机构,以设计可复现的基准测试和长期追踪AI系统能力进展而知名。与模型厂商内部评测不同,METR强调外部、第三方视角,其报告常被用作判断AI能力跃迁速度的参照。它此前因对自主复制、网络攻击等高风险能力的系统评估而受到关注,此次对Anthropic研发效率的审查,把评估对象从「模型能力」延伸到了「模型如何改变研发组织本身」,这也是该报告引发讨论的原因之一。
数字背后的归因逻辑:AI帮人,人做决策
把80%的提速归给AI辅助,这个比例需要拆开看。METR的逻辑大致是:在答案明确、可验证的任务上,研发效率的提升最为显著,而这恰恰是当前AI模型最擅长的场景。写测试、验证假设、排查已知类型的缺陷——这些工作的产出速度和一年前完全不是一个量级。
但「AI辅助」不等于「AI自主」。人类仍然掌握方向选择、架构决策和最终判断。80%描述的是效率增量的来源,而不是替代关系。理解这一点很重要,否则很容易把「研发提速2倍」误读成「AI独立完成了两倍的研发工作」。
这里还有一个容易被忽略的口径问题:2倍的估算只统计了Anthropic自家模型带来的加速。如果把其他实验室的模型也算进去,整体提速约为1.4倍。两个数字都成立,只是回答的问题不同——前者衡量的是内部模型的杠杆效应,后者衡量的是整个AI工具生态的综合影响。
「可验证任务」是理解这份报告的关键概念。它指的是那些有明确正确答案、结果可以被自动或快速检验的工作,例如编写单元测试、复现并定位缺陷、验证一个假设是否成立。这类任务的特点是反馈闭环短、评价标准客观,因此特别适合由模型承担高频试错。相比之下,前沿方向选择、架构权衡、跨领域直觉判断等任务缺乏即时可验证的反馈信号,模型难以独立判断对错,人类仍需主导。METR把效率增量主要归因于前者,正是基于这种任务可分性,而非笼统地认为AI在所有研发环节都同等有效。
报告里被红笔划掉的部分,才是争议所在
METR这份评估最诚实的地方,是它主动承认了自己的信息盲区。报告提到,最具信息量的证据大部分被做了涂改处理(redacted)。外部审查者能看到结论,却看不到支撑结论的完整原始材料。
这直接削弱了「2倍」这个数字的可复核性。METR没有掩饰这一点,反而在措辞上相当克制:整体猜测、加上无法展示的证据、区间1.3到3倍。这种表述方式本身就是在说——请把2倍当作一个方向性判断,而不是精确测量值。
另一层张力来自Anthropic自己的说法。据METR披露,Anthropic在八月的一份报告中表示,AI尚未让其研发速度翻倍。METR直接评价这一判断「过于自信」。一家公司对外说「还没到2倍」,外部评估机构说「你可能低估了自己」,这种反转并不常见,也说明双方对同一组内部数据的解读存在实质分歧。
「redacted(涂改处理)」在AI安全与能力评估报告中是常见做法,通常出于商业机密、内部数据敏感性或安全风险考量。但对评估结论而言,涂改会带来一个结构性问题:读者只能看到推断,无法复核推断所依据的原始证据,结论的可信度因此更多依赖评估机构的声誉而非数据本身。这也是METR特意标注「有据可查」与「整体推测」两类结论的原因——前者可被独立检验,后者只能作为方向性参考。理解这一区分,有助于判断报告中哪些数字可以当作事实引用,哪些只宜作为趋势信号。
当AI开始加速AI研发,行业该关心什么
这份报告真正的价值不在「2倍」这个数字,而在它验证了一个反馈回路的可行性:更强的模型带来更快的研发,更快的研发又带来更强的模型。METR的评估说明这个回路在Anthropic内部已经产生了可观测的效应,尽管幅度仍有争议。
对行业而言,这意味着两件事。第一,评估AI对研发效率的影响需要第三方介入,自报数据存在系统性偏差——Anthropic的自我判断反而比外部评估更保守,这个案例本身就打破了「公司一定会夸大宣传」的刻板印象。第二,可验证任务是当前AI加速的主要战场,那些难以量化验证的研发环节(比如前沿方向探索、跨领域直觉判断)能否被同样加速,报告没有给出答案。
至于「一年顶两年」到底是里程碑还是统计假象,更稳妥的读法是:在答案明确的任务上,提速是真实且显著的;在整体研发产出上,提速约为1.4倍;而80%的贡献来自AI辅助这一归因,是整份报告中最值得后续追踪的变量。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。