Anthropic研究:LLM让形式化软件验证规模化成为可能

Anthropic 证明大模型可在 RISC-V 汇编级为上百个开源库批量生成形式化不崩溃证明并挖出潜伏漏洞。
文章介绍 Anthropic Frontier Red Team 的研究:大模型已能把形式化验证从专家小众工作推向规模化。他们以 Faust 测试套件自动生成规格,建立任意 RISC-V 二进制在 Linux 上执行的通用模型,由 Claude 写证明并交 Rocq 内核检查,成功为 123 个 OSS-Fuzz 库、239 个入口点生成约 1.8 亿行不崩溃证明,过程中发现数百量级 Bug。文章同时强调形式化验证不等于没有 Bug,信任边界集中在 RISC-V/Linux 形式模型、定理陈述和 Rocq 检查器,当前假设单线程、静态二进制、固定内存预算。成本正在下降,证明可复用,路线是通用规格加二进制级验证,优先证 Glibc、OpenSSL、Curl 等关键共享库。
为什么形式化验证突然变得重要
软件经过多年测试和反复修补,依然会藏着致命漏洞。文章提到Linux内核近期披露的漏洞超过1000个,而更危险的是,前沿模型越来越擅长把看似无害的小问题串联成可利用的攻击链。理想的安全流程是找齐并修掉所有bug,再给出一份数学证明——按某套规则,没有更多可证的漏洞。这恰好是形式化验证要做的事:把代码建成数学模型,证明它永远遵守给定的安全规则。证不出来,往往暗示可能有违规bug。
代价一直高得吓人。文章给出的数据是:GCEL4实现大约需要两人年,形式化验证大约需要20人年。这种成本让形式化验证长期只适合航空这类真正关键的任务。Anthropic的Frontier Red Team在2026年10月22日发布的官方研究提出一个转折点:大模型已经能把形式化软件验证从专家小众活,做到在上百个真实开源库的RISC-V汇编级别批量出证明,并在证明过程中挖到了多年找不到的bug。
从测试到证明:规格难题的解法
用已有测试套件生成规格
形式化验证最难的环节是写规格。多数程序没有像PNG或RFC那样清晰的正确定义。Anthropic的做法是把已有可编译测试套件自动转成规格——这套测试永远通过,并建立在任意RISC-V编译二进制在Linux上执行的通用模型上。
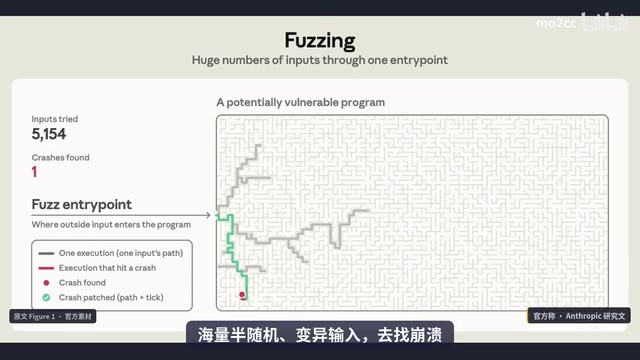
他们从Faust出发。Faust对同一个入口海量伴随随机编译输入去找崩溃,本质是暴力搜索输入空间,几乎无限,没法保证覆盖一切路径。他们把Faust改成对编译后RISC-V指令的规格:任意小于64MB字节的输入都不崩溃。若证成,则对该入口再跑Faust也不会再找到崩溃。
证明流水线怎么跑
整条流水线是:开源库加上已有Faust测试,先编译成RISC-V可执行文件,再叠上FreeRTOS的RISC-V与操作系统形式语义以及不崩溃性质,机械生成规格,然后由Claude写证明,交给Rocq内核检查。绿色表示在信任组件正确的前提下已经证过。
Faust(Fuzzing with Automated Unbounded Systematic Testing) 是一类基于模糊测试(fuzzing)的自动化测试框架,其核心思想是向程序入口持续注入随机或半随机输入,通过监控崩溃、断言失败等信号来发现缺陷。与形式化验证不同,模糊测试只能覆盖实际执行到的路径,无法穷举输入空间,因此只能证明“没找到崩溃”,而无法证明“不存在崩溃”。文章利用 Faust 测试套件作为规格来源的巧妙之处在于:把“Faust 永远找不到崩溃”这一经验性目标,转化为“任意小于 64MB 的输入都不崩溃”的可证明命题,从而在模糊测试与形式化证明之间搭起桥梁。
Rocq 是 Coq 证明助手在 2025 年更名后的名称,是一个基于依赖类型论的交互式定理证明器。它允许用户用形式化语言编写数学定义和定理,并通过内核机械地检查证明脚本的每一步推导是否合法。Rocq 的信任基础很小——只要内核正确,经过它检查的定理就成立。文章中的证明最终都交由 Rocq 内核检查,这意味着即使 Claude 生成了错误的证明脚本,也会被内核拒绝。
FreeRTOS 是一个广泛使用的开源实时操作系统内核,文章借助其 RISC-V 移植版本的形式语义来刻画操作系统层面的行为。将 FreeRTOS 的 RISC-V 形式语义与 Linux 进程模型结合,是为了在证明中覆盖系统调用、内存布局和线程调度等运行时假设,使“不崩溃”这一性质在真实执行环境中具有意义。
规模结果与Bug发现
官方称成功证明无崩溃的覆盖123个不同的OSS-Fuzz库,覆盖239个入口点。这些证明合计大约1亿8千万行Rocq,典型一份证明约60万行,中位二进制约18000条RISC-V指令。运行假设包括单线程静态二进制、固定内存预算、RISC-V处理器加Linux,信任边界主要是RISC-V与Linux进程形式模型、被证定理的陈述以及Rocq检查器本身。
证明过程中也在找Bug修Bug。官方称试图证明的过程发现了数百量级的Bug。为少打断人工,允许打补丁再重申规格继续证。例子包括:约20兆字节特定布局才触发的解压器整数下溢导致越界写;需约64兆字节输入并超过两级字节内存才触发的图像解码越界读;跨两个巨型特定调用顺序才会触发的越界写;以及在libxbat上重新发现了v202656132。也有不崩溃的逻辑bug,比如限制可加载文件的特性并未始终强制。
信任边界与不崩溃之外的性质
这里必须说清一条红线:形式化验证不等于没有Bug。Formally verified不等于Bug-free。剩余问题只可能落在信任组件里,或在证明范围之外。当前证明假定单线程静态RISC-V二进制、固定内存预算、Linux;多数人实际跑在X86或ARM再加动态链接的Glibc上。声称范围是许多OSS-Fuzz入口上任意小于64MB字节输入不触发崩溃,含ASAN,但ASAN并非检出全部内存安全问题,也未覆盖每库全部入口、死代码以及调用方误用——调用方误用需要调用方自己的合约。
不崩溃之外,还能证高层性质。例如往返编解码、代数律、差分测试等。文中一个C++网络库为避免标准库集合析构时递归爆栈,要在机器码上证明libstdc++红黑树在平衡时深度对数有限。形式化的不崩溃证明覆盖从入口可达的全部路径。
ASAN(AddressSanitizer) 是编译器插桩式的内存错误检测工具,能在运行时捕获越界访问、释放后使用、栈溢出等内存安全问题。文章中的证明包含“在 ASAN 下不崩溃”这一条件,意味着证明覆盖了 ASAN 所能检出的错误类别,但 ASAN 本身并非完备——它无法检测所有未定义行为、逻辑错误或数据竞争。因此,形式化证明的结论需要与 ASAN 的检测能力边界结合理解:证成的是“不会触发 ASAN 所监控的那类崩溃”,而非“不存在任何安全缺陷”。
成本正在下降,证明可以复用
单份证明可消耗数亿Token,必须降下来。官方称在36个小验证任务上,Opus 5.5挣到一半时大约比Opus少40%的Token。证明还能复用:共享工作区可复制彼此证明,大约少17% Token,部分原先单独失败的任务得以完成。大规模OSS-Fuzz中证明大量重叠在C运行时与ASAN初始化等公共部分,轻改、重改、新写各占一定比例。类比MathLib:形式化数学库积累近30万定理、700多名贡献者,证明可复用。
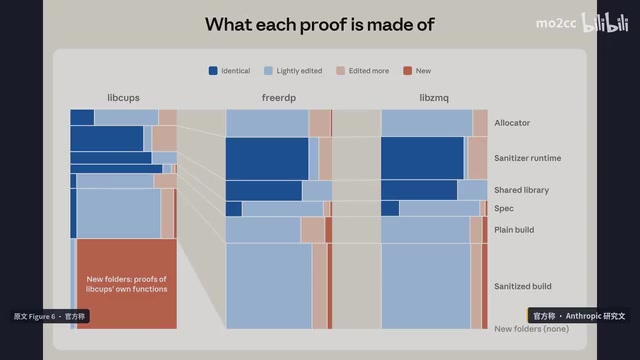
成本路线是通用规格加二进制级验证,避免整库重写,依赖成熟度率先证关键共享库,比如Glibc、OpenSSL、Curl,一次验证多处复用。
MathLib 是 Lean 定理证明器生态中的形式化数学库,已积累近 30 万条定理、700 多名贡献者。它的意义在于展示了大规模形式化证明的工程可行性:定理可以被其他证明引用和复用,贡献者可以在他人工作的基础上继续构建,而不必每次从零开始。文章用 MathLib 类比形式化软件验证的复用前景——当共享库(如 Glibc、OpenSSL、Curl)的证明被一次构建、多处引用时,单个程序的验证成本将大幅摊薄,这与 MathLib 中定理复用的经济逻辑一致。
这对开发者意味着什么
文章结论轨迹是:形式化验证将从只服务最关键任务的专家手搓,走向像今天的Fuzz一样可用于几乎全部生产软件。在大模型以大规模找洞的时代,需要能担保安全性质的流程,大模型规模化形式化验证是通往更大范围担保的路径之一。文章鼓励更多人用更强模型从事形式化验证,尤其是以前试过弱模型觉得不行的开发者。
一个值得思考的问题是:如果关键库真能像Fuzz一样批量出证明,你最想先给哪一类依赖加上形式化担保?Rust与Veil用Rust写Python字节集解释器,用Veil证明其遵循某学术论文所述CPython语义,实证约170万的随机Python程序与CPython 99.95%行为一致,其余为已知边角——这类端到端正确性尝试,或许正是答案的起点。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。