Anthropic研究员辞职发声:AI超级智能竞赛正在"拿人类性命豪赌"

Anthropic前研究员公开辞职批评AI安全,引发内部对齐负责人附和,掀起行业风险讨论。
Anthropic前预训练研究员Jason Coxon以一条获得1.72亿次浏览的推文公开辞职,批评OpenAI与Anthropic正不负责任地竞逐自我改进的超级智能,拿人类性命做赌注。更具冲击力的是,Anthropic对齐科学负责人Evan随即公开转发附和,并表示个人认为未来十年AI导致人类灭绝的概率超过10%。对比一年前Dario Amodei给出的25%风险估计,不同时间与人物的数字差异引发了带有黑色幽默色彩的讨论。此事件的深层议题在于AI行业安全与速度之间的根本性张力——当最了解这些系统如何被训练出来的内部人士开始以辞职方式公开发声,其警示意义值得整个行业严肃对待。
一条引爆科技圈的辞职声明
一位AI研究员的辞职声明近日在社交媒体上掀起轩然大波。这条推文获得了惊人的1.72亿次浏览量——按视频作者的说法,这不仅是AI安全领域史上最大的一条推文,更是整个科技圈Twitter的现象级传播。
声明的核心内容相当尖锐:"我今天从Anthropic辞职了。过去三年里,我先后在OpenAI和Anthropic从事预训练研究工作。这两家公司都没有尽到负责任的态度。它们正直奔自我改进的超级智能而去,拿我们所有人的性命做赌注。"
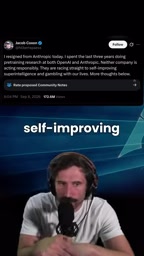
从OpenAI到Anthropic,这位研究员的履历覆盖了当下最前沿的两家大模型公司的预训练研究。正因如此,他的批评显得格外有分量——这不是外部观察者的揣测,而是来自核心研发环节的内部声音。
谁是这位发声者
这场风波的中心人物是一位名叫Jason Coxon的AI研究员。在社交媒体的传播中,他被戏称为"迷你Dario"、"Dario 2.0"等绰号——这些调侃显然指向Anthropic的CEO Dario Amodei,暗示这位研究员在AI安全立场上的某种延续性。
值得关注的是,他的观点并非孤立的个人情绪宣泄。真正让这件事发酵的,是业内其他研究者的公开附和。
内部人士的交叉背书
Anthropic的对齐科学负责人(alignment science lead)Evan转发了这条推文,并明确表态支持。他写道:"Jacob在这里说得没错。AI的风险是真实存在的,我们是真心实意地相信AI有可能杀死所有人类。我个人认为,未来十年内这种情况发生的概率超过10%。"
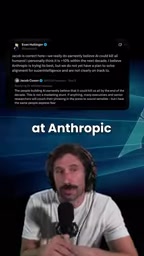
一位身处对齐科学核心岗位的负责人,公开给出"十年内超过10%的人类灭绝概率"这样的判断,其冲击力远超一条普通的离职吐槽。这意味着相关风险评估并非边缘人士的危言耸听,而是来自公司内部负责安全工作的技术领导层。
**对齐科学(Alignment Science)**是AI安全领域的一个核心研究方向,致力于确保AI系统的行为与人类意图、价值观保持一致。其核心问题是:随着AI能力不断提升,如何防止系统产生有害的、意外的或与人类目标相悖的行为?Anthropic将对齐研究视为公司存在的核心使命之一,并专门设立了对齐科学负责人这一岗位。正因如此,当这一岗位的负责人公开表态AI风险"真实存在"并给出量化概率时,其信号意义远超普通员工的个人意见——这代表着公司负责安全把关的技术核心层,对于当前发展轨迹的忧虑已足够深重,以至于选择以公开背书离职声明的方式表达出来。
风险概率的变化轨迹
视频特别对比了时间线上的一个细节。就在一年前的同一天,Dario Amodei本人曾公开表示,AI"有25%的概率导致非常非常糟糕的结果"。
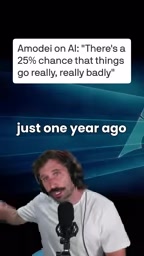
从Dario去年的25%,到如今对齐负责人的10%以上,不同人物、不同时间点给出的数字本身存在差异。视频作者用略带黑色幽默的口吻调侃道:"所以这意味着什么?情况在好转啊,兄弟们。"——这种反讽恰恰凸显了问题的荒诞之处:当业内顶尖专家讨论的是"人类灭绝概率从25%降到10%"时,所谓的"好转"依然是一个令人不安的数字。
这场争论背后的真正议题
抛开戏剧化的表达,这起事件触及了AI行业最核心的张力:安全与竞速的矛盾。辞职声明中"racing straight to self-improving superintelligence"(直奔自我改进的超级智能)的表述,直指行业当前的竞赛态势。
自我改进的超级智能,指的是AI系统具备持续优化自身能力的可能性。一旦模型能够递归地提升自己,其能力增长速度和可控性都将面临巨大的不确定性。批评者担心的正是:在商业竞争和技术军备竞赛的压力下,企业可能会牺牲必要的安全评估,优先追求能力突破。
一位前预训练研究员选择以辞职这样决绝的方式发声,加上对齐负责人的公开附和,反映出即便在这些以"安全"为旗号的公司内部,关于发展节奏和风险容忍度的分歧也相当真实。无论这些概率数字是否精确,这场由内部人士发起的公开讨论,本身就值得整个行业认真对待。
**递归自我改进(Recursive Self-Improvement)**是AI安全领域长期讨论的核心风险场景之一。其基本逻辑是:若一个AI系统足够智能,能够理解并改进自身的代码、架构或训练流程,那么每一次改进都会产生一个更有能力改进自身的系统,形成正反馈循环。理论上,这一过程可能以远超人类监管能力的速度推进,导致AI能力在极短时间内实现爆炸式增长,即所谓的"智能爆炸"(Intelligence Explosion)。这一概念最早由数学家I.J. Good在1965年提出,后经Nick Bostrom等人在《超级智能》等著作中系统阐述,成为现代AI存亡风险(existential risk)讨论的理论基础。辞职声明中"racing straight to self-improving superintelligence"的表述,正是直接援引了这一框架,暗示当前的预训练竞赛可能正在逼近这一临界点。
结语
这条1.72亿浏览量的推文之所以能破圈,不仅因为话题本身的争议性,更因为发声者的身份——他们是最了解这些系统如何被训练出来的人。当构建AI的人开始公开质疑构建AI的方式时,外界或许应当多一分审慎的倾听。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。