APTV+Ollama本地模型:0成本实现AI中文字幕实时翻译
用Ollama本地部署千问小模型,为APTV实现零成本AI实时中文字幕翻译。
本文介绍了一套基于 Ollama + APTV 的本地大模型实时字幕翻译方案,全程不依赖云端 API,无需付费。核心流程是:在本机安装 Ollama 并拉取千问 3(4B)模型,在 APTV 设置中填入本机 IP(127.0.0.1)、Ollama 默认端口 11434 及模型名称即可完成接入。由于 APTV 的"禁用思考"开关对 Ollama 模型失效,直连方案延迟较高,需借助优化脚本将翻译延迟降至三四秒。此外,APTV 的字幕功能依赖语音识别与翻译两个模型配合,必须提前下载对应语种的语音识别模型。最终效果略逊于 DeepSeek 云端方案,但完全免费、数据不出本地,适合低成本且注重隐私的用户。
想看全球电视直播却苦于没有中文字幕?这篇教程演示了如何用 APTV 配合 Ollama 本地大模型,在零成本的前提下搭建 AI 实时翻译字幕系统。与依赖云端 API 的方案不同,本地部署意味着不需要花钱购买翻译额度,所有算力都跑在自己的电脑上,隐私性和成本控制都更友好。
为什么选择本地大模型做字幕翻译
APTV 本身支持接入 AI 翻译 API,此前已经有基于云端服务(如 DeepSeek广告)的翻译教程。但云端方案的问题在于需要申请 API Key,部分服务还要按量付费。本地大模型则完全规避了这些门槛——模型下载完成后,翻译过程全部在本机运行,不产生任何调用费用。
本次演示使用的是 Mac mini M4 设备,运行千问(Qwen)3 系列的 4B 小模型。UP主坦言,由于设备性能有限,只能选择参数量较小的模型做演示;电脑配置更高的用户完全可以换用更大、翻译质量更好的模型。这也点出了本地部署方案的核心权衡:翻译精度和速度受限于本地硬件。
千问(Qwen)3 是阿里巴巴达摩院开源的多语言大语言模型系列,具备较强的中英文双语能力,适合翻译任务。「4B」中的 B 指 Billion(十亿),代表模型参数量约为 40 亿个,属于轻量级规格。相比之下,主流云端翻译服务背后往往使用几百亿乃至千亿参数的大模型,这也解释了为何本地小模型在翻译精度上会有所折损。参数量越大,模型对语义的理解和上下文把握能力越强,但对内存(尤其是显存/统一内存)的需求也成倍增加。Mac mini M4 配备苹果统一内存架构,CPU 与 GPU 共享内存池,相比传统 x86 平台在运行小模型时具有功耗低、延迟稳定的优势。
Ollama 安装与模型下载
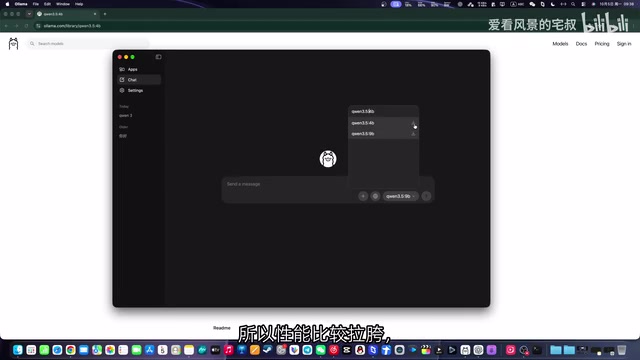
Ollama 是本次部署的核心工具,它负责在本地加载和运行大模型。安装方式有两种:
手动下载安装
进入 Ollama 官网,选择手动下载安装包。下载完成后像安装普通 App 一样拖动替换即可,整个过程与安装常规软件无异。
命令行拉取模型
安装好 Ollama 后,在它的对话框里直接输入模型名称(如千问 4B),再随便发一句"你好"之类的问候,Ollama 就会自动开始下载对应模型。下载完成后,这个 4B 模型就常驻在本地电脑上了。
模型名称一定要填写准确,这是后续能否正常调用的关键。Ollama 还会使用一个固定的默认端口(11434),这个端口信息在配置 APTV 时会用到。
Ollama 本质上是一个本地大模型管理和推理框架,类似于容器化工具 Docker,但专门针对大语言模型设计。它将模型权重的下载、量化格式转换、推理引擎(基于 llama.cpp)以及 HTTP API 服务全部打包在一起,用户无需手动配置 CUDA、PyTorch 等复杂环境。安装完成后,Ollama 会在后台以 REST API 形式对外暴露接口(默认监听 localhost:11434),任何支持 OpenAI 兼容接口的客户端都可以直接调用。模型文件以 .gguf 格式存储并自动进行量化压缩,4B 参数量的模型通常只需 2-4 GB 磁盘空间,对普通消费级硬件非常友好。
在 APTV 中配置本地模型
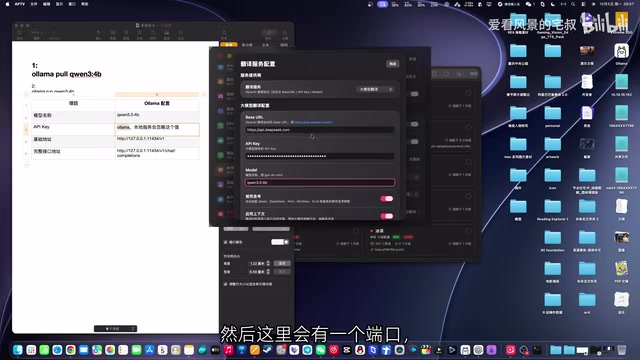
进入 APTV 的设置界面,填写方式与之前的云端 API 教程大体相同,但有几个本地部署特有的参数需要注意:
- 本机地址:如果 APTV 和大模型都装在同一台设备(本机安装),地址默认填
127.0.0.1;如果 APTV 装在其他设备上,就要把这个地址改成局域网内大模型所在设备的 IP。 - 端口:填写 Ollama 的默认端口 11434。
- 模型名称:填入下载好的模型名称。
填好这些参数后即可点击测试。不过 UP主在实测中遇到了一个"小插曲":测试响应转了很长时间。排查后发现,APTV 里的"禁用思考"开关对 Ollama 加载的这个模型没有起作用——也就是说模型在翻译时仍会输出冗长的"思考"过程,拖慢了响应速度。理论上禁用思考后速度能明显提升。
用脚本优化连接速度
为了解决"禁用思考"失效导致的延迟问题,UP主提供了一个优化脚本,Windows 和 Mac 通用。操作流程如下:
- 打开电脑终端,输入
python3后加一个空格,再把解压后的脚本文件拖进终端窗口。 - 按脚本提示操作,可先选择"清除"选项(选项 6)重置一遍,再选择安装(选项 2)。
- 按提示填写模型名称(务必准确)和端口(局域网内未被占用的任意端口即可,演示中用的是 1009)。
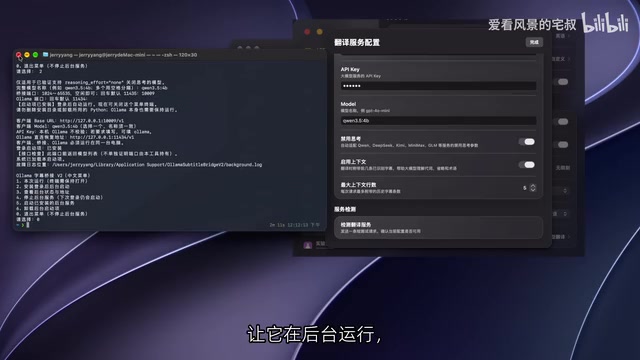
- 脚本会生成一个 base URL 地址,把它复制到 APTV 后台对应设置里,同时粘贴模型名称。
- 选择脚本的后台运行选项(选项 0),之后就可以关闭终端窗口。
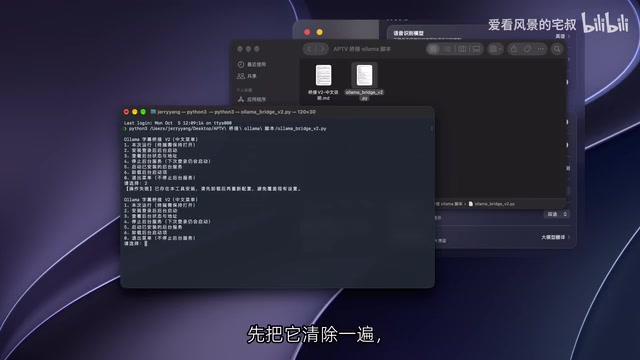
优化前的延迟非常高,经过脚本处理后,延迟降到了大约三四秒;再次点击测试时命中缓存,速度会更快。
别忘了下载语音识别模型
除了翻译模型,APTV 中还必须优先下载好语音识别模型。要根据电视节目的语种来选择对应的识别模型,比如英文节目就选英文识别模型,其他语种同理。语音识别负责把音频转成文字,翻译模型再把文字译成中文,两者缺一不可。
APTV 的字幕生成流程分为两个独立阶段:首先由语音识别模型(通常基于 Whisper 架构)将音频流实时转录为源语言文本,再由翻译大模型将文本转换为中文字幕。Whisper 是 OpenAI 开源的语音识别系统,支持 99 种语言的转录与翻译,不同语种对应不同的声学特征,因此选错识别模型会直接导致转录失败或乱码,翻译模型无论多强都无济于事。语音识别模型同样分大小规格(tiny、base、small、medium、large),较小的模型响应更快但准确率略低,实时字幕场景通常选用 small 或 medium 规格以平衡速度与精度。
效果与适用场景
UP主对最终效果给出了相对客观的评价:与此前使用的 DeepSeek 云端方案相比,本地开源模型在翻译精确度和速度上会有一定折扣,但整体"比较能用"。
本地方案的真正价值在于:
- 完全免费且开源,无需 API 付费;
- 对硬件要求不高,低配电脑也能跑起来,尤其在 Mac 上运行较稳定;
- 数据不出本地,隐私性更好。
对于追求零成本、看重隐私、又能接受翻译质量略有折损的用户来说,APTV + Ollama 是一个值得尝试的组合。而对翻译质量要求更高的用户,仍可考虑用更大参数的模型,或回归云端 API 方案。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。