Artificial Analysis智能指数v5大更新:开源与闭源差距拉大,评测可信度遭质疑
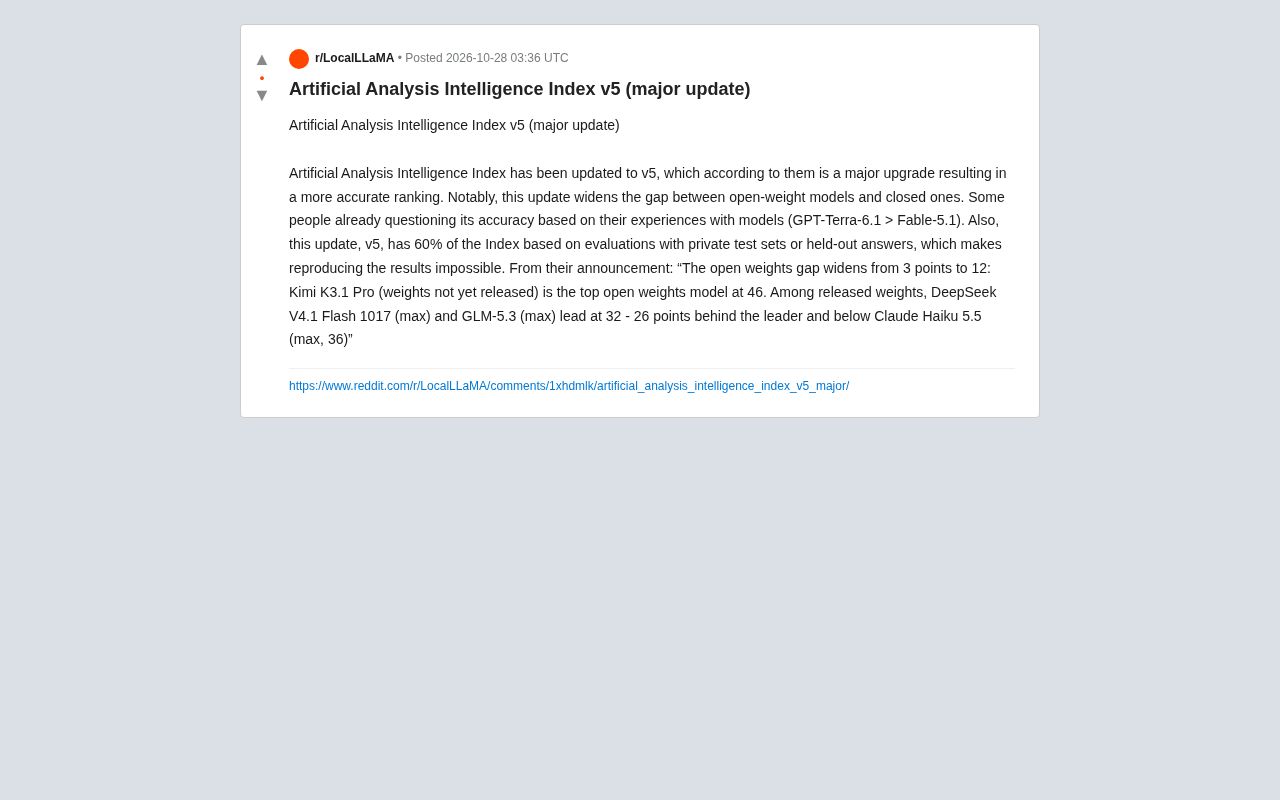
Artificial Analysis Intelligence Index v5 拉大开源闭源差距,但六成评测不可复现引发质疑。
第三方评测榜 Artificial Analysis 的 Intelligence Index 更新至 v5,官方称其为重大升级、排名更准确,但社区讨论远比排名复杂。数据上,开源权重与闭源模型的差距从 3 分扩大到 12 分;Kimi K3.1 Pro 以 46 分居开源榜首但权重未发布,已发布权重中 DeepSeek V4.1 Flash 与 GLM-5.3 以 32 分领先,落后榜首 26 分。方法上,约 60% 的指数得分来自私有测试集或保留答案,外部无法复现,透明度因此下降。社区质疑集中在两点:排名与实际使用体验错位,以及不可复现削弱榜单公信力。文章建议把榜单当作方向性参考,关注同阵营内相对差距,跨阵营比较需结合自有任务集验证。
第三方模型评测榜 Artificial Analysis 的 Intelligence Index 迎来 v5 版本更新。官方将其定性为一次"重大升级",声称排名因此更准确。但这次更新在社区引发的讨论远比排名本身复杂:一方面,开源权重与闭源模型之间的差距被显著拉大;另一方面,新版本有相当大比例的评测基于私有测试集,复现几乎不可能,这让榜单的独立参考价值再次被打上问号。
v5 改了什么:差距拉大与不可复现
最直接的变化体现在排名数据上。根据官方公告,开源权重的差距从原先的 3 分扩大到 12 分。排在开源阵营首位的是 Kimi K3.1 Pro,得分 46,但它的权重尚未发布。在已发布权重的模型中,DeepSeek广告 V4.1 Flash 1017(max 档)与 GLM-5.3(max 档)以 32 分领跑开源侧,距离榜首差了 26 分,甚至低于 Claude Haiku 5.5(max 档,36 分)。
另一个关键设计是评测构成。v5 中约 60% 的指数得分来自使用私有测试集或保留答案的评测,这意味着外部研究者无法复现这些结果。对于一个长期被当作选型参考的榜单来说,这是一项实质性的方法变化,而官方对此的表述相当简略,仅说明了比例和用途,没有给出更细的验证机制说明。
开源权重模型指模型参数对外公开、任何人可下载并在本地部署或微调的模型,如 DeepSeek、GLM、Llama 系列;与之相对的是仅通过 API 提供服务的闭源模型。二者的核心差别在于可审计性与可控性:开源权重的推理过程可在本地复现,便于做安全审查和二次开发,而闭源模型的行为只能通过接口观察。评测榜通常会把两类模型放在同一坐标系下比较,但开源模型存在"权重未发布"的中间状态——模型已进入榜单,社区却无法自行验证,这会使排名与可用性之间产生落差。
私有测试集是指评测方不公开题目与标准答案的题库,常见做法是从内部保留数据中抽样或使用合同约定不得外泄的题目。它的主要作用是防止模型厂商针对公开题库做定向优化(即刷榜),降低训练数据污染带来的虚高分数。代价是外部无法重跑实验,评测结果只能依赖发布方的流程自律。当私有部分在总分中占比很高时,榜单的可验证性会明显下降。
社区在质疑什么
Reddit 讨论中出现了两类典型反馈。第一类来自实际使用体验与排名的错位:有人举出 GPT-Terra-6.1 排名高于 Fable-5.1 的例子,认为这与自己的实际使用感受不符,进而怀疑指数的排序逻辑是否真的更"准确"了。这类质疑并非孤例,每次榜单大改版几乎都会出现体验派与指标派的拉锯。
第二类质疑更偏方法论。60% 的得分来自私有测试集,虽然能在一定程度上防止刷榜和数据污染,但代价是透明度的下降。当外部无法复核时,榜单的公信力就高度依赖发布方的自我约束,而这恰恰是第三方评测最难建立的部分。
需要说明的是,这些讨论目前主要来自社区用户的个人体验和推断,并非经过验证的结论。开源与闭源差距到底是被"拉大"了,还是此前被低估了,v5 给出的答案是后者,但缺乏可复现证据支撑。
**数据污染(benchmark contamination)**指评测题目以某种形式进入了模型的训练语料,使模型在测试时表现为"见过答案"而非真正具备能力。随着网络语料被大规模抓取,公开题库很容易被无意或有意纳入训练集,导致分数虚高。业内常见的缓解手段包括:定期更换题库、使用私有保留集、对题目做改写或动态生成。这也是主流评测机构向私有测试集迁移的直接动因,但如文中所述,抗污染能力的提升与外部可复核性的下降往往同时发生。
这份榜单还值得看吗
从实用角度看,Artificial Analysis 的指数仍然是快速了解模型相对位置的有效入口,尤其是它同时覆盖了开源与闭源、不同推理档位(max 等)的组合,信息密度较高。但 v5 的变化提示使用者需要调整解读方式:把榜单当作一个方向性参考,而不是绝对排序。
具体来说,值得关注的是同一阵营内部的相对差距,比如已发布权重的开源模型中 DeepSeek V4.1 Flash 与 GLM-5.3 几乎并列,这类信息对选型更有价值。而跨阵营的绝对分数对比,在 60% 评测不可复现的前提下,需要结合自身场景的实际测试来判断。对于把榜单当作采购或技术选型依据的团队,更稳妥的做法是先用榜单缩小候选范围,再用自己的任务集做小规模验证。
这次更新也反映出一个行业趋势:主流评测机构正在向私有测试集迁移,以对抗数据污染和针对性优化。这条路在提升抗刷榜能力的同时,也在削弱外部监督的空间。榜单的"权威"未来可能更多来自长期一致性,而非单次更新的说服力。
常见问题
v5 的开源模型第一名是谁?
Kimi K3.1 Pro,得分 46,但权重尚未发布。已发布权重中领先的是 DeepSeek V4.1 Flash 1017(max)和 GLM-5.3(max),均为 32 分。
为什么说 v5 的结果无法复现?
因为指数中约 60% 的得分来自私有测试集或保留答案的评测,外部研究者拿不到题目和答案,自然无法重跑验证。
开源与闭源的差距具体是多少?
据官方公告,差距从 3 分扩大到 12 分,已发布权重的开源模型落后榜首 26 分。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。