AutoScaffold:用AI导师动态搭建脚手架,强化学习训练更高效

AutoScaffold 用冻结教师模型自动诊断学生训练瓶颈并设计动态脚手架,四个领域均超越 RL 基线。
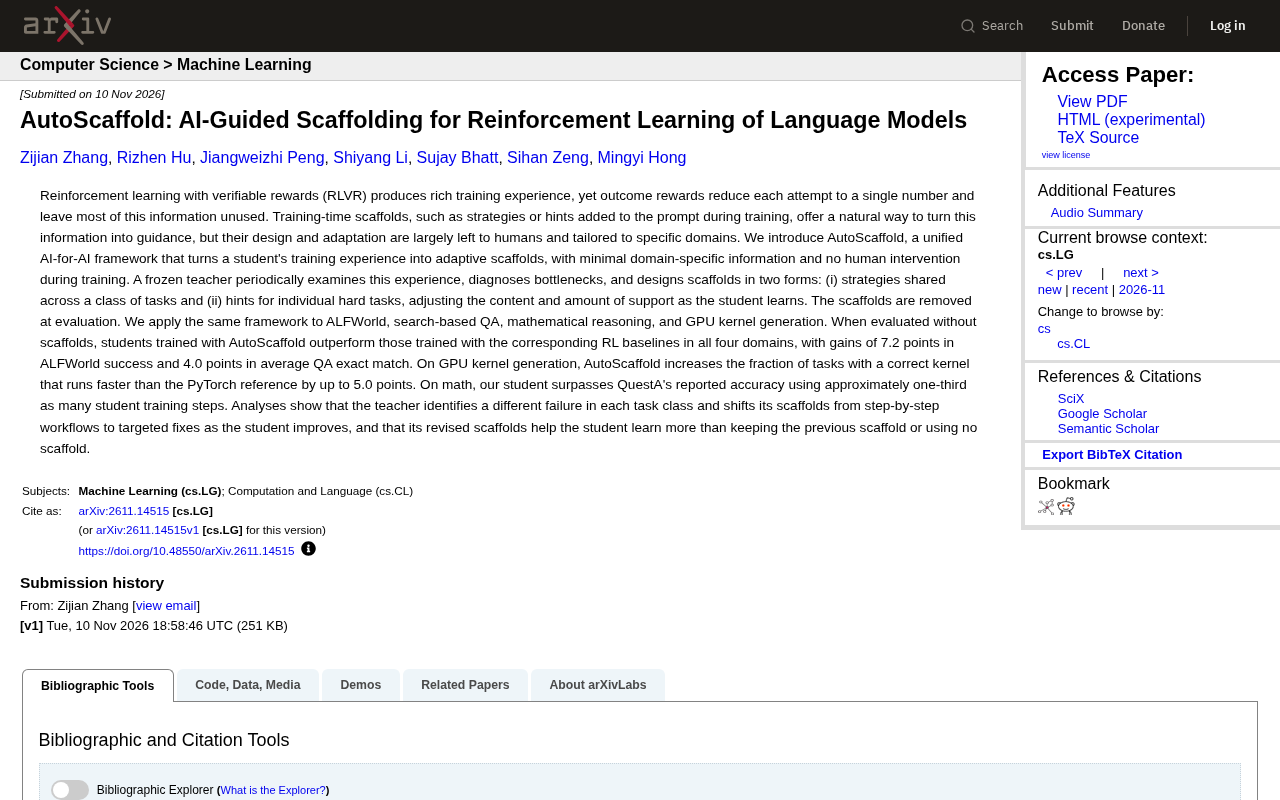
文章介绍了一项名为 AutoScaffold 的研究,针对基于可验证奖励的强化学习(RLVR)中结果奖励信息稀疏、训练经验被浪费的问题,提出统一的 AI-for-AI 框架。该框架由冻结的教师模型周期性审视学生训练经验,识别反复失败的任务类别,自动设计两类脚手架:跨任务共享的策略和针对困难任务的提示,并随学生进步动态调整形态。在 ALFWorld、搜索问答、数学推理和 GPU 内核生成四个领域,移除脚手架后的评估显示学生模型均优于对应 RL 基线,成功率、精确匹配等指标提升 4 至 7 个点,数学推理仅用约三分之一训练步数即超过 QuestA 报告准确率。分析表明教师会针对不同任务识别不同失败模式,消融实验证实动态修订的脚手架比保留旧脚手架更有效。文章也指出该方法依赖强教师模型,脚手架仅作训练加速器而非推理外挂。
强化学习(RL)在语言模型训练中展现出强大潜力,尤其是基于可验证奖励的强化学习(RLVR)。但一个根本性矛盾长期存在:每次尝试只能得到一个标量结果奖励,大量隐含在训练过程中的丰富信息被浪费。近日,一篇关于 AutoScaffold 的研究提出了一个统一的“AI-for-AI”框架,让冻结的教师模型周期性地审视学生的训练经验,自动诊断瓶颈并设计脚手架,从而在多个领域显著提升训练效率。
为什么需要训练时脚手架?
RLVR 的优势在于奖励信号可验证、无需人工标注偏好,但结果奖励把每次尝试压缩成一个数字,训练过程中产生的具体失败模式、成功路径等信息几乎都被丢弃。训练时脚手架——例如在提示中加入策略或提示词——理论上可以把这些信息转化为引导信号。然而,现有做法通常依赖人工设计,且针对特定领域定制,难以跨任务泛化,也无法随学生能力变化而动态调整。
AutoScaffold 的核心洞察是:训练经验本身就是一种可被 AI 利用的资源。与其让人类专家手动设计提示,不如让一个更强的模型自动完成诊断与设计。
RLVR(基于可验证奖励的强化学习) 是近年来语言模型后训练的重要范式,其核心是用程序化、可自动判定的奖励信号(如数学题的最终答案是否匹配、代码能否通过单元测试、问答的精确匹配率等)替代人类偏好标注。与 RLHF 依赖奖励模型打分不同,RLVR 的奖励来自确定性验证器,因此信号更客观、更不易被奖励黑客攻击,且成本更低。代表性工作包括用强化学习提升数学推理能力的 DeepSeek广告-R1 系列方法、QuestA 等。但 RLVR 的固有局限在于奖励是结果级、稀疏且标量化的:一次完整生成只换来一个数字,模型无法直接从失败轨迹中获知“错在哪一步、为什么错”,这正是训练效率瓶颈的根源之一。
训练时脚手架(training-time scaffolding) 指在训练阶段为学生模型额外注入的辅助性上下文,例如提示词中的解题策略、步骤模板、格式约束或针对特定题目的修正建议。它与推理时提示工程的关键区别在于:脚手架只在训练期间存在,用于塑造模型的策略分布,评估和部署时会被完全移除,因此模型最终能力必须内化到参数中。这与课程学习、教师蒸馏中的“辅助信息逐步撤除”思想一脉相承,但 AutoScaffold 的创新在于让教师模型自动生成和迭代这些脚手架,而非人工预设。
AutoScaffold 如何工作:教师诊断、学生进化
该框架包含两个角色:冻结的教师模型和正在训练的学生模型。教师模型不会直接参与训练,而是周期性地检查学生的训练经验数据,识别学生在哪些任务类别上反复失败,并据此设计两类脚手架:
- 策略(strategies):面向一类任务的通用指导,在同类任务间共享;
- 提示(hints):针对个别困难任务的具体修正建议。
关键设计在于,脚手架的内容和数量会随着学生学习进度动态调整。早期学生能力较弱时,教师可能提供更详细的步骤式工作流;当学生水平提升后,脚手架会转向更精准的针对性修复。评估时,所有脚手架都被移除,以确保最终模型不依赖外部支持。
冻结教师模型指参数在训练全程不更新的强模型,仅作为推理服务被调用。这种设计借鉴了知识蒸馏中“教师—学生”范式,但用途不同:蒸馏传递的是逐 token 的输出分布,而这里教师传递的是对训练经验的诊断结论与结构化建议。冻结带来两个好处:一是避免教师与学生协同更新导致的训练不稳定和模式坍缩;二是教师能力构成学生能力的事实上界,使脚手架质量可控。代价是教师的能力天花板会成为整个框架的上限,且周期性调用强模型会带来额外推理成本。
“策略(strategies)”与“提示(hints)”的二分对应了迁移学习中的共享表示与个体修正:策略面向任务类别,相当于可复用的先验或元知识,能在同类样本间摊销;提示面向单个困难样本,相当于针对性的误差纠正。这种分层结构使脚手架既能泛化又能精确,同时数量可控,避免上下文膨胀。脚手架随训练进度动态增删,本质上是一种由模型自身表现驱动的自动课程,与人工设定难度曲线的课程学习相比更具适应性。
多领域验证:四个任务上的性能提升
研究团队将同一框架应用于四个差异明显的领域:ALFWorld 家居环境任务、基于搜索的问答、数学推理以及 GPU 内核生成。据论文报告,在不使用脚手架评估的条件下,AutoScaffold 训练出的学生模型在所有四个领域都优于对应的 RL 基线:
- ALFWorld:成功率提升 7.2 个点;
- 搜索问答:平均精确匹配提升 4.0 个点;
- GPU 内核生成:正确且运行速度超过 PyTorch 参考实现的任务比例最高提升 5.0 个点;
- 数学推理:学生模型用约三分之一的学生训练步数,就超过了 QuestA 报告的准确率。
这些结果说明,脚手架带来的收益并非局限于单一任务类型,而是具有跨领域的可迁移性。
分析揭示:教师会针对不同任务识别不同失败模式
论文进一步分析了教师模型的行为。结果显示,教师在不同任务类别中识别出的失败原因各不相同,并且会随着学生进步调整脚手架形态:从早期的分步工作流逐渐过渡到后期的针对性修复。消融实验表明,教师修订后的脚手架比保留旧脚手架或完全不使用脚手架更能帮助学生提升。换句话说,脚手架的价值不仅在于“有”,更在于“动态适配”。
意义与局限
AutoScaffold 提供了一种思路:把训练过程本身变成可被 AI 理解和利用的信号,减少对人类领域知识和手动设计的依赖。它不要求大量领域特定信息,也不需要训练期间的人工干预,这使其在多任务场景下具备吸引力。
补充一点,该方法依赖一个能力足够强的冻结教师模型,教师诊断的质量会直接影响脚手架效果;同时,论文中的评估均是在移除脚手架后进行的,这虽然保证了公平性,但也意味着脚手架的作用是“训练加速器”而非推理时的外挂。未来如何将这一框架扩展到更开放、奖励更稀疏的任务,仍是值得探索的方向。
相关推荐
GPT-6.2 Astra与Sol发布:双模型架构与社区热议
OpenAI 发布 GPT-6.2,包含 Astra 与 Sol 两个模型。本文梳理官方公告与 Hacker News 社区讨论,分析双模型架构对开发者的潜在影响与选型建议。

Gmod TTT 埃及主题地图:太空资本主义与法老对决
探索Gmod TTT埃及主题地图的趣味玩法:玩家选择法老等角色,通过立方体传送到太空,展开资本主义与共产主义的幽默对决,并体验道具战斗的混乱乐趣。

GraphRAG:超越搜索,实现全局知识发现
GraphRAG 是微软研究院推出的知识图谱增强检索技术,超越传统 RAG 的局部搜索,实现全局性知识发现。本文介绍其核心理念、代际演进及医疗领域应用案例。