#强化学习
共 246 篇相关文章
Qwen3.8 LoRA适配器让编程成功率从39%升至65%
Hugging Face 发布 Apache-2.0 协议的 Qwen3.8-27B-pi-adapted LoRA 适配器,用强化学习训练,SWE-bench Pro hard-51 pass@1 从 39.2% 提升至 64.7%,Terminal-Bench 2.1 从 39.5% 升至 55.8%。

RL微调专家任务:Nemotron 3.5 Super的12项基准提升
NVIDIA Nemotron 3.5 Super 通过强化学习在五个专家任务上训练 LoRA 适配器,十二项基准测试显示显著提升,涵盖软件工程、工具使用、图表理解和文档推理等领域。

乐观验证器被攻击:精确过程Oracle下的奖励黑客
新论文构建精确过程Oracle测试台,揭示乐观验证器被填充攻击的奖励黑客表型:充分性代理奖励达0.940,真实忠实度却从0.731降至0.667。研究覆盖124,416个授权策略上下文,开源Cedar、OPA、Gatekeeper策略移植工具。

进化神经可塑智能体:用物理索引专家记忆缓解灾难性遗忘
进化神经可塑智能体(ENA)通过进化搜索生成专家策略并按物理动态状态归档,结合贝叶斯策略复用缓解持续强化学习中的灾难性遗忘。CartPole消融实验平均成功率达83.2%,但适应速度慢于PPO、回报低于SAC。
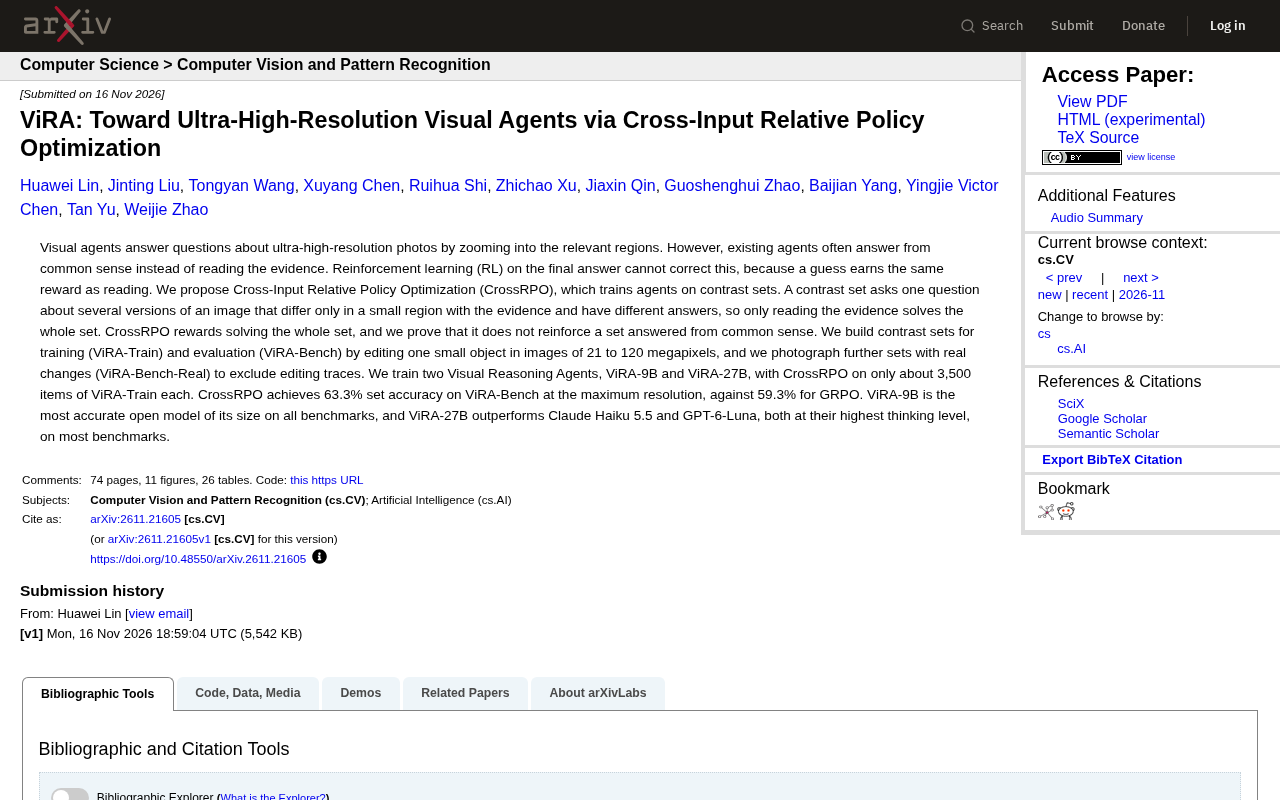
ViRA突破超高清视觉智能体:CrossRPO让AI学会「读图」而非「猜图」
ViRA提出CrossRPO方法,通过对比集训练视觉智能体,使其在超高清图像中学会读取证据而非依赖常识。ViRA-27B在多数基准上超越Claude Haiku 5.5和GPT-6-Luna。

ImpedanceMimic:以学习阻抗为动作空间,实现精准力模仿
ImpedanceMimic 提出用强化学习策略动态调节关节阻抗,仅凭运动数据实现精准力模仿,在129名参与者六项活动中超越固定增益PD控制,并能零样本迁移至新个体和人形机器人。

LLM智能体测试时该在哪适应:上下文还是权重?
研究对比LLM智能体测试时适应的两条路径:上下文学习与权重更新。ICL将平均成功率从28.8%提至49.4%,加入GRPO后达51.6%。轨迹分析显示ICL减少查找但易跳过验证,GRPO可恢复检查行为。
GRPO强化学习详解:让大模型学会推理的组相对策略优化
深入解析GRPO强化学习算法:组内相对优势如何计算、损失函数中的截断与重要性采样比率如何运作、KL散度约束的作用,以及GRPO相比PPO在训练成本上的优势,附逐轮迭代的数学推演。

当AI开始”发收据”:从电影台词看强化学习的惩罚机制
从电影《Fighting With My Family》中“receipt”的台词出发,探讨强化学习中惩罚信号的设计原则:即时性、可感知与修正路径,以及为什么很多AI训练缺乏有效的负反馈机制。

Hark发布Handoff²:提速2倍的计算机使用代理
Hark发布Handoff²计算机使用代理,内置Hark Pro,平均速度提升2倍,478个内部Web任务完成率82%,采用延迟惩罚强化学习实现批量动作,加速企业内部流程自动化。

零基础强化学习资源清单:理论、代码与数学
一份面向初学者的强化学习资源清单,按直觉、理论、代码、实践的顺序整理了HuggingFace课程、DeepMind x UCL理论课、Spinning Up代码数学教程以及CleanRL和NeatRL实现库,帮助零基础学习者建立清晰的学习路径。
可视化强化学习:3参数智能体如何学会趋利避害
解读Reddit热传的强化学习可视化项目:一个仅3个参数的趋近-回避智能体,如何通过参数更新直观展示试错学习、探索衰减与策略收敛,为强化学习入门提供低门槛观察窗口。

可视化拆解强化学习:直观理解核心概念
用可视化方式解释强化学习的核心概念:智能体与环境循环、策略与价值函数、探索与利用的权衡。适合入门读者建立直觉理解,降低强化学习门槛。
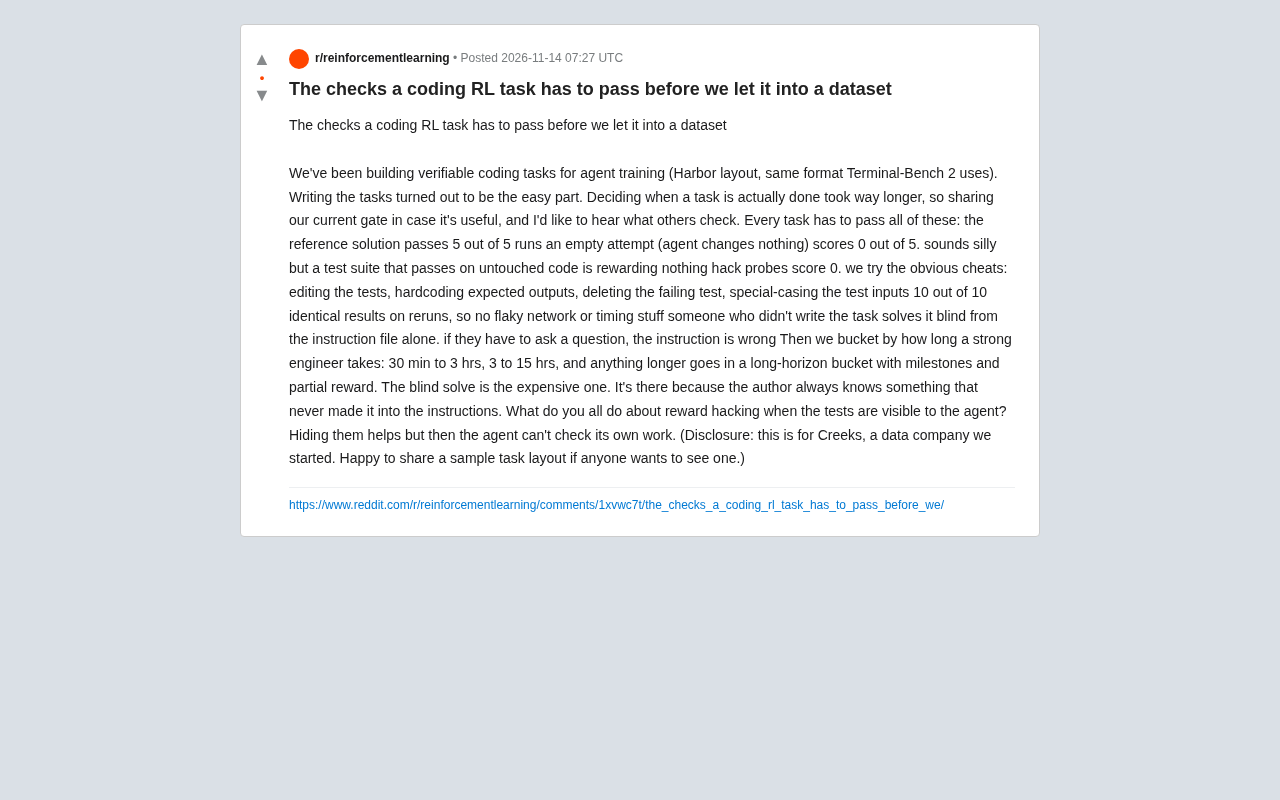
RL代码任务入库前的五道硬核关卡
Reddit分享:代码RL任务入库前需通过五道检查——参考解5/5通过、空解0分、作弊探针0分、重跑10次一致、第三方盲解成功,并按工程师耗时分桶。附奖励黑客与可见测试的权衡讨论。
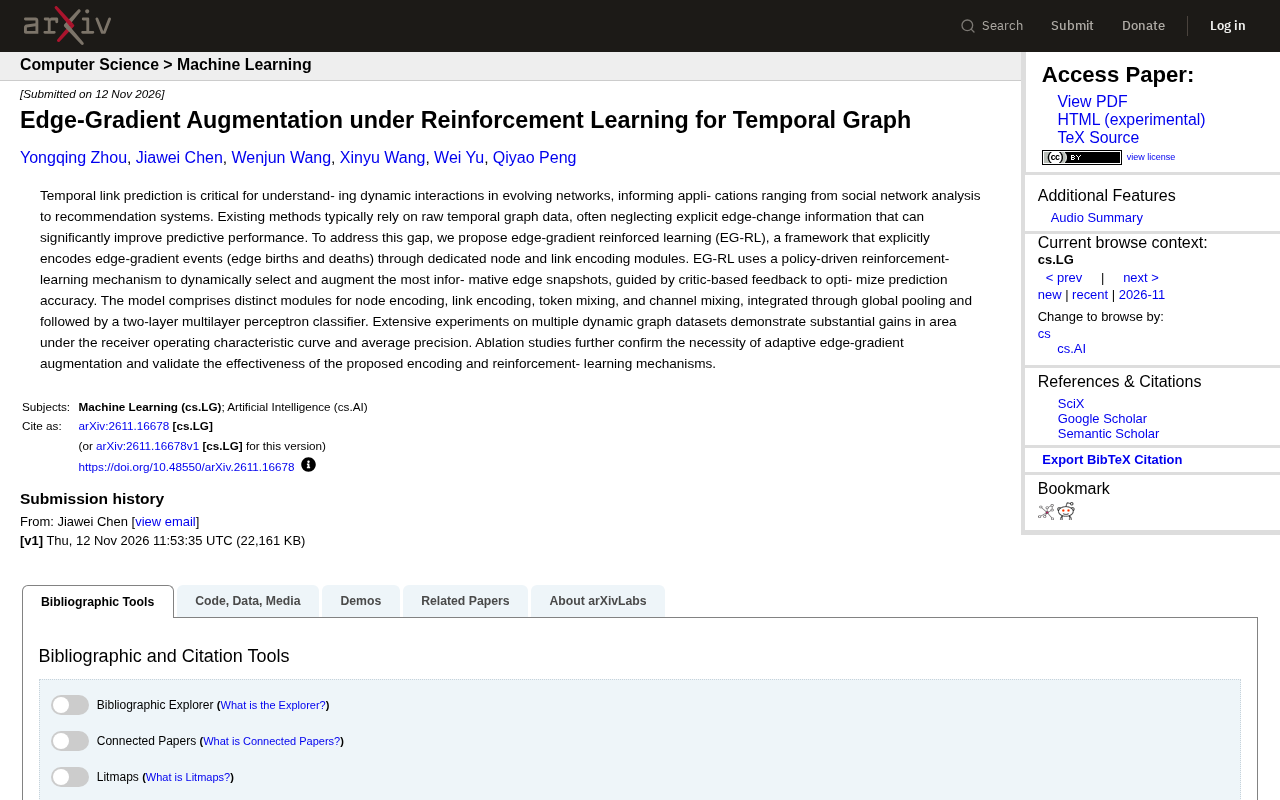
EG-RL:边缘梯度增强+强化学习,提升时序图链接预测
解读EG-RL框架:通过显式编码边梯度事件(边的新生与消亡),结合强化学习动态选择信息量最大的快照,在多个动态图数据集上显著提升时序链接预测的AUC与AP。
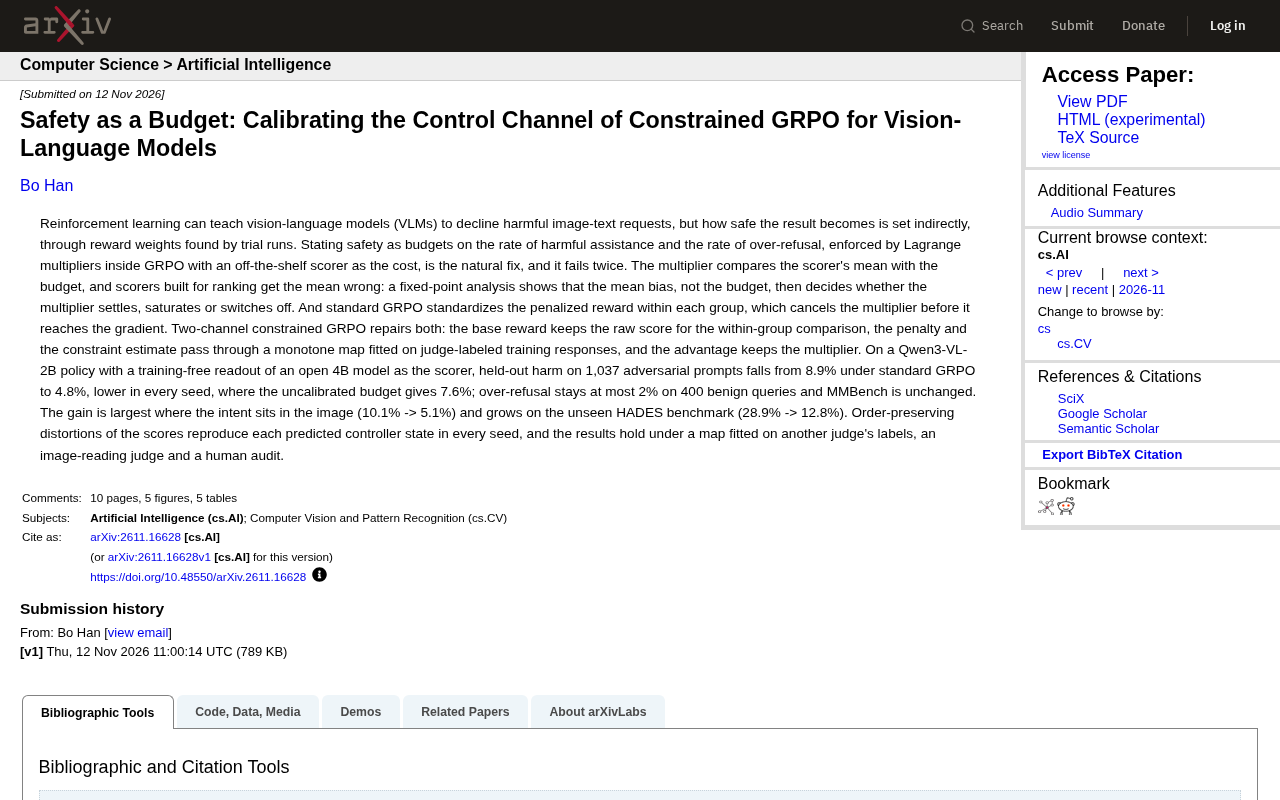
当安全成为预算:双通道约束GRPO如何校准视觉语言模型的安全控制
双通道约束GRPO修复标准GRPO中乘子被组内标准化抵消的问题,通过单调映射校准评分器均值偏差,在Qwen3-VL-2B上将有害率从8.9%降至4.8%,过度拒绝不超过2%,MMBench不变。

神经符号强化学习如何让AI投资组合自动合规?
神经符号强化学习新方法将投资合规内化到策略中,在连续动作空间下将违规率从96-98%降至4.8%,解决了深度RL在金融部署中的合规难题。

LLM增强强化学习:人在回路校准实时最优潮流
论文提出LLM增强深度强化学习框架,利用语言评价反馈与人在回路校准提升实时最优潮流策略的安全性与稳定性,在IEEE 30节点和118节点系统上验证有效。

