B2B季度营收预测模型为何总失灵?实战优化思路解析

B2B季度营收预测困难的根源在于数据稀少与业务波动,而非算法不够复杂。
本文针对Reddit上一个典型的B2B营收预测困境展开分析:用两年历史数据预测下季度营收,模型方差始终不佳。文章指出,问题核心不在算法,而在数据结构——两年数据按季度聚合仅得8个观测点,样本量极为有限,加之B2B营收高度依赖少数大客户,结构性冲击难以被历史外推模型捕捉。针对这一困境,文章提出三条优化方向:将营收拆解为驱动因素自下而上建模;在小样本下回归移动平均、线性回归等简单基线模型;以及改用区间预测配合滚动窗口回测来正确评估模型表现。最终结论是:B2B预测的关键在于把业务理解转化为特征和模型结构,领先指标(如销售管道、商机金额)比滞后的历史营收更有价值。
一个常见却棘手的难题
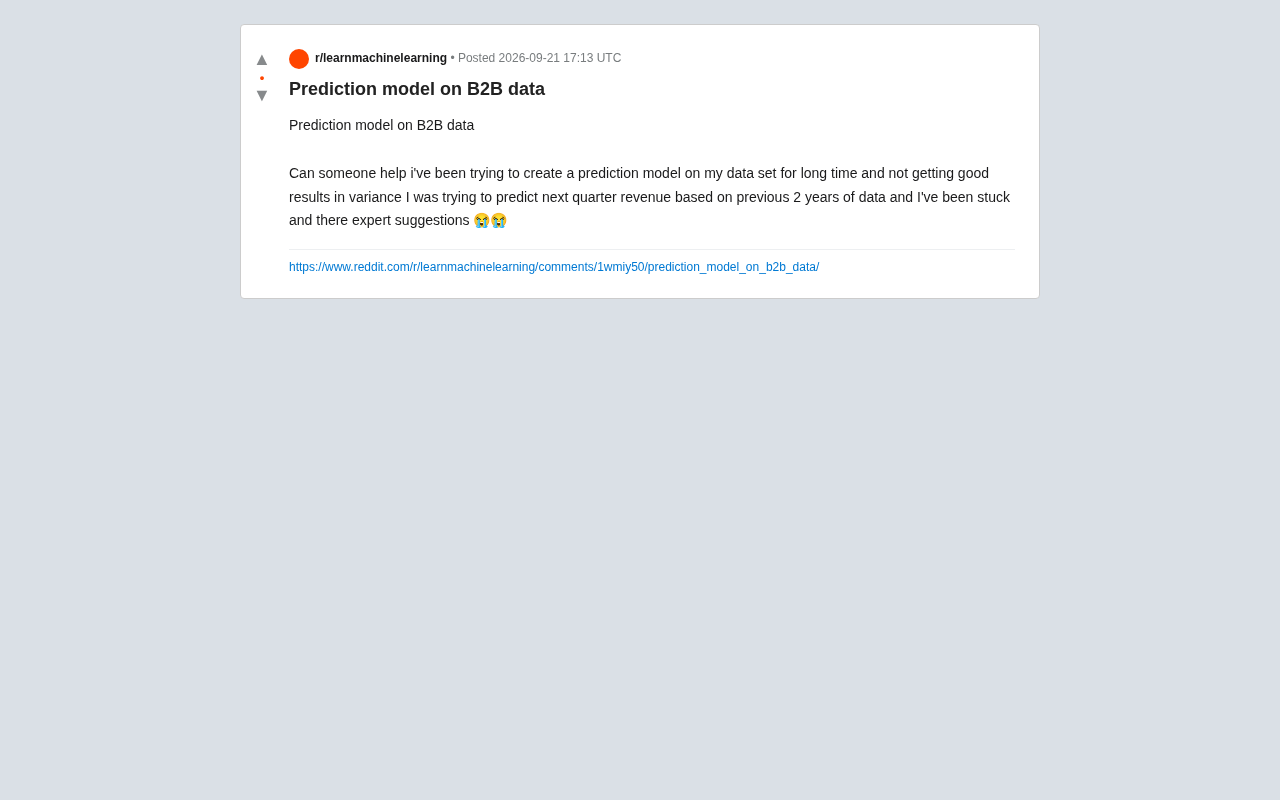
在Reddit的数据科学社区,一位用户发出了这样的求助:他试图用过去两年的数据预测下一季度的B2B营收,但折腾了很久,模型的方差始终不理想,怎么调都得不到好结果。
这个问题看似简单,实际上触及了时间序列预测和B2B业务建模中最核心的痛点。B2B数据往往样本量小、周期性强、且极易受少数大客户波动影响,用常规机器学习方法直接硬套,很难拿到稳定的表现。下面结合这个案例,梳理一套可落地的排查与优化思路。
为什么两年数据预测季度营收如此困难
这位用户的核心困境是「方差表现不佳」——换句话说,模型对营收波动的解释能力很弱,预测值和真实值之间偏差大且不稳定。造成这种情况的原因,通常不在算法本身,而在数据结构。
两年的历史数据,如果按季度聚合,实际上只有8个数据点;即便按月聚合也只有24个。用这么少的样本去训练一个能捕捉趋势和季节性的模型,几乎注定过拟合或欠拟合。这是B2B预测最典型的陷阱:业务上「两年数据」听起来不少,但转换成时间序列的观测点后,信息量极其有限。
此外,B2B营收高度依赖大客户。少数几笔大合同的签约或流失,就能让某个季度的数字剧烈跳动,这类结构性冲击很难被纯粹的历史外推模型捕捉。
排查与优化的几个方向
重新审视数据粒度与特征
与其在季度聚合层面硬预测,不如下沉到更细的粒度。可以把营收拆解为「客户数 × 客单价」或「新签 + 续约 + 流失」等驱动因素,分别建模再汇总。这种自下而上的做法,比直接预测总额更稳健,也更符合B2B业务逻辑。
同时,引入外部特征——销售管道(pipeline)中的商机金额、加权成交概率、历史转化率、季节性标识等。B2B营收的领先指标往往藏在CRM里,而不在过去的营收数字中。
销售管道(Sales Pipeline) 是CRM系统中记录的所有进行中商机的集合,通常包含商机金额、预计成交日期和当前阶段(如初步接触、方案演示、合同谈判等)。对B2B营收预测而言,加权管道金额(商机金额 × 该阶段历史成交率)是一个极具价值的领先指标,因为它反映了未来几个季度的"营收储备",而非已经发生的历史结果。将管道数据作为输入特征,相当于把销售团队的业务判断引入模型,这是纯历史外推无法替代的信息来源。
从复杂模型回归简单基线
当样本量小的时候,深度模型或复杂集成方法往往适得其反。建议先用简单基线打底:
- 移动平均 / 指数平滑:适合有稳定趋势的营收
- 朴素季节性模型:直接用去年同期值作为参考
- 线性回归 + 少量强特征:可解释性强,不易过拟合
这些基线能帮你判断问题到底出在数据还是模型。如果连简单模型都做不好,说明数据信号不足,需要回到特征工程环节。
指数平滑(Exponential Smoothing) 是一类经典时间序列方法,核心思想是对越近的观测赋予越高的权重,权重以指数速度衰减。其中,Holt-Winters三重指数平滑同时考虑趋势和季节性,特别适合有规律波动的营收数据。相比ARIMA等方法,指数平滑参数少、易解释、对小样本更友好——在只有8个季度点的场景下,模型参数越少往往反而越稳定。
朴素季节性模型(Naive Seasonal Model) 则更为简单:直接用上一年同期的实际值作为预测值。这个方法的价值在于它提供了一条清晰的"能力下限"基准——如果你的复杂模型连这条基线都打不过,说明模型并没有真正学到有效规律,而是在噪声上过拟合。
正确评估「方差」问题
用户提到方差不好,这里要区分两种情况:一是模型本身预测抖动大(高方差、过拟合),二是数据里的真实波动就很大。前者需要正则化、减少特征、增加数据;后者则说明单点预测本身意义有限,应该改用区间预测,给出置信区间而非单一数字,管理层反而更能接受。
对于只有8个季度点的场景,用时间序列交叉验证(如滚动窗口回测)来评估,比随机切分训练测试集更靠谱。
时间序列交叉验证(滚动窗口回测) 的具体做法是:固定一个训练窗口大小,依次向前滚动预测下一个时间点,逐步积累多个测试误差再取平均。例如,用第1-4季度训练、预测第5季度,再用第1-5季度训练、预测第6季度,以此类推。这种方法保留了时间的先后顺序,避免了"用未来数据预测过去"的数据泄露问题,评估结果也更贴近真实部署场景。
区间预测(Prediction Interval) 则是给出预测值的不确定性范围,例如"下季度营收在800万至1200万之间,置信度80%"。对于高波动的B2B业务,区间预测往往比点预测更诚实也更实用,它迫使业务方承认不确定性的存在,进而推动情景规划(scenario planning)和风险缓冲,而非依赖一个虚假精确的单一数字。
给类似困境者的建议
遇到B2B营收预测卡壳,不必急着换更炫的算法。真正决定成败的是:
- 数据够不够:样本太少时,任何模型都无力回天,考虑补充历史数据或用月度、周度粒度扩充观测
- 特征对不对:领先指标(pipeline、商机、转化率)远比滞后的历史营收有价值
- 目标合不合理:单点精确预测在高波动业务中不现实,区间预测和情景分析更务实
B2B预测的本质,是把业务理解转化为特征和模型结构,而不是单纯的调参竞赛。当结果长期不理想时,退一步检查数据基础和业务逻辑,往往比继续深挖算法更有效。
这个来自Reddit的求助很有代表性——它提醒我们,数据科学的难点常常不在模型,而在如何用有限的数据讲清一个业务故事。
相关推荐
CSS锚点定位:告别JavaScript的UI定位新方案
深入解析CSS锚点定位:从anchor-name、position-anchor到anchor()函数、position-area简写、position-try-fallbacks回退机制,以及anchor-size和即将到来的anchor queries。了解这一替代JavaScript定位方案的核心能力与当前限制。

AI图表交互新玩法:在对话中连续追问与可视化
探索AI对话中连续生成图表的新交互方式,通过/visualize命令在同一聊天窗口追问并可视化答案,提升数据分析效率。

Cursor并入X订阅:付费计划共享额度,Grok模型编程用量翻倍
Cursor正式并入The X Subscription,付费计划共享统一用量池,Grok模型编程用量翻倍,第三方模型转为API定价。现有Cursor用户可保留原计划或迁移,Premium、Super、Ultra额外包含Grok Bot。