把 SQLite 变成向量数据库:两大扩展实战与对比
用sqlite-vec与sqlite-vector两款扩展将SQLite变成向量数据库,实现低成本RAG能力的对比实战。
本文介绍了如何通过sqlite-vec和sqlite-vector两款扩展为SQLite添加向量存储与相似度搜索能力,从而在无需引入独立向量数据库的前提下实现RAG应用。sqlite-vec主打轻量简洁,使用虚拟表存储向量,区分辅助列与可过滤元数据列,适合原型和边缘场景;sqlite-vector定位生产级,以普通表存BLOB、需显式初始化并支持量化与多种距离度量,在查询速度和搜索内存效率上更占优势。基准测试显示,在15万向量规模下sqlite-vector查询约快10ms,搜索内存仅需sqlite-vec的约1/7,但其量化策略是以增大磁盘换取内存与速度优势,而sqlite-vec可通过只存量化向量将数据库压缩至极小体积。两款工具代表了轻量便携与性能可调两种不同的工程取舍。
SQLite 是全球部署最广泛的数据库之一:轻量、便携、简单,甚至可以完全运行在内存中。在大模型时代,我们越来越需要把 embedding(向量)存进数据库来做相似度搜索和 RAG(检索增强生成)。除了使用专门的向量存储(如 FAISS),另一条路径是给现有数据库加装向量扩展——Postgres 有著名的 pgVector,而本文要探讨的,是如何用两款扩展把 SQLite 变成向量数据库。
两款扩展的定位差异
本文涉及两个扩展:sqlite-vec 和 sqlite-vector。二者都能给 SQLite 添加向量能力,但定位截然不同。
- sqlite-vec:主打轻量、便携、简单,够快够用,走的是「快速上手、简单直接」路线。
- sqlite-vector:更偏向生产级、企业级方案,性能榨取更彻底,提供更多调优选项(如量化、距离度量配置等)。
用一句话概括:如果你只需要一个「够用就好」的轻量方案,选 sqlite-vec;如果追求生产环境的性能与可调性,选 sqlite-vector。
本文的目标有两个:演示两款扩展的最小可运行示例,并从速度、简洁性、内存效率三个维度进行对比测试。
向量数据库与向量扩展的背景
RAG(检索增强生成)的核心流程是:将文档切片后通过 embedding 模型转换为高维向量,存入数据库;查询时将问题同样向量化,再用相似度搜索找出最相关的文档片段,最后连同原始问题一起交给大语言模型生成回答。专门的向量数据库(如 Pinecone、Weaviate、Qdrant)为此做了深度优化,但引入了额外的基础设施成本。FAISS 是 Meta 开源的纯内存向量检索库,性能极强但不提供持久化存储、元数据管理等数据库功能。给现有关系型数据库加向量扩展,是一种「在熟悉的环境里追加向量能力」的折中方案,代价是牺牲部分极限性能,换取运维简单、与业务数据同库管理的便利。
sqlite-vec:轻量方案实战
项目使用 uv 作为包管理器,通过 uv init --no-package 初始化,再 uv add sqlite-vec openai python-dotenv。embedding 既可以用真实模型(如 OpenAI 的 text-embedding-3-small)生成,也可以用 NumPy 随机数组代替——本质上向量就是一串数字。
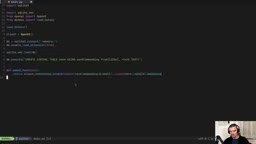
加载扩展的核心步骤如下:连接内存数据库、启用扩展加载、载入 sqlite-vec:
db = sqlite3.connect(":memory:")
db.enable_load_extension(True)
sqlite_vec.load(db)
虚拟表与列类型
sqlite-vec 使用虚拟表(virtual table)来存储向量。它看起来、用起来都像普通表,但实际由扩展接管管理:
CREATE VIRTUAL TABLE data USING vec0(
  embedding float[1536],
  +text text,
  category text
)
这里有三种列的概念需要区分:
- embedding:向量列,必须指定维度,且维度要与所用模型输出一致(
text-embedding-3-small为 1536 维)。 - 辅助列(auxiliary):用
+前缀定义,如+text text,用来存储附加数据(如原始文本),但不能用于过滤或搜索。 - 元数据列(metadata):不加
+前缀,如category text,可用于 WHERE 过滤。
如果对辅助列施加 WHERE 约束,会直接报「illegal WHERE constraint on an auxiliary column」的操作错误。
SQLite 的虚拟表(Virtual Table)机制是其扩展性的核心设计之一,由 CREATE VIRTUAL TABLE ... USING <模块名> 语法触发。虚拟表在语法上与普通表完全一致,支持 SELECT、INSERT 等标准 SQL 操作,但实际的存储和检索逻辑完全由注册的 C 扩展模块接管,SQLite 核心只负责解析 SQL 并转发请求。这种机制让 FTS5 全文搜索、R*Tree 空间索引等高级功能都能以「假装是普通表」的方式嵌入 SQLite,而无需修改数据库内核。sqlite-vec 正是利用这一机制,把 ANN(近似最近邻)搜索逻辑封装进虚拟表模块,使得向量检索可以用熟悉的 SQL 语法触发。
插入与相似度搜索
插入时需要用 sqlite_vec.serialize_float32() 把向量序列化为正确的数据类型。搜索则用 MATCH 配合 k 参数控制返回条数:
SELECT text, distance FROM data
WHERE embedding MATCH ?
AND k = 2
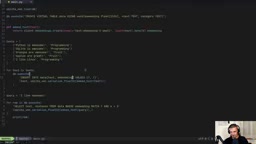
实测中,以「I like bananas」为查询,返回最相似的结果是「oranges are awesome」和「apples are great」——说明 embedding 正确捕捉到了「水果」这一语义。若把元数据过滤条件 AND category = 'programming' 加上,则会排除水果类结果,只返回编程相关的最相似项。
sqlite-vector:生产级方案实战
sqlite-vector 的用法有几处明显不同。首先,它不是通过 Python 包直接加载,而是访问包内的二进制文件:
extension = importlib.resources.files('sqlite_vector.binaries') / 'vector'
db.load_extension(str(extension))
注意一个易错点:pip/uv 安装时包名是 sqlite-ai-vector,而不是 sqlite-vector,但扩展本身仍叫 vector。装错包会报「no module named sqlite_vector」。
用普通表 + BLOB 存储
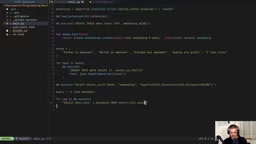
与 sqlite-vec 的虚拟表不同,sqlite-vector 用普通表,把向量作为 BLOB(二进制大对象)存储:
CREATE TABLE data (text text, embedding blob)
插入时用 vector('float32', ?) 做序列化,传入的是 json.dumps(embedding) 的字符串形式。
显式初始化与全量扫描搜索
sqlite-vector 需要一步 sqlite-vec 没有的显式初始化,指定表、列、数据类型、维度和距离度量:
SELECT vector_init('data', 'embedding',
  'type=float32,dimension=1536,distance=cosine')
距离度量支持余弦(cosine)、曼哈顿、欧几里得等,按任务需求选择。搜索则通过 vector_full_scan 函数配合 JOIN 完成,返回同样是水果类的最相似结果。
基准测试:速度、内存与磁盘
作者用相同命名的脚本对两款扩展做了四组对比:速度、内存效率、原始磁盘大小、量化磁盘大小。
速度:在 5 万向量规模下,sqlite-vec 约 84ms/查询,sqlite-vector 约 78ms/查询;扩展到 15 万向量时,分别为 241ms 与 231ms。作者坦言录制时差距不大(怀疑与 GPU 被占用有关),但总体上 sqlite-vector 的查询更快。
内存效率:sqlite-vec 以全量向量表示进行搜索,5 万向量约需 150MB;sqlite-vector 在搜索前使用量化(turbo4),同规模仅约 19.8MB。
原始磁盘大小:sqlite-vec 约 63.3MB,sqlite-vector 约 82MB。
量化磁盘大小:这里两者哲学不同。sqlite-vec 若只存量化向量,数据库可缩小到 2.2MB;而 sqlite-vector 会在保留原始向量的基础上再存量化数据,因此总库反而更大。换言之,sqlite-vector 的量化是为了加速搜索、提升内存效率,而非缩减磁盘占用。
量化(Quantization)技术说明
量化是一种用低精度数值表示原始高精度向量的压缩技术。原始 float32 向量每个维度占 4 字节,1536 维向量单条数据约为 6KB;而量化(如 4-bit 量化,即 turbo4)将每个维度压缩到 4 比特,内存占用可降低至原来的 1/8。搜索时,量化向量可在内存中完整装载,减少 I/O 并加速距离计算;但量化会引入精度损失,召回率略低于全精度搜索。sqlite-vector 的策略是同时保留原始向量和量化向量:原始向量用于精确存储和二次排序,量化向量用于快速初筛——这解释了为何其磁盘占用反而更大,但搜索内存效率大幅领先。
如何选择
综合来看,两款扩展代表两种取舍:
- sqlite-vec 更简单直接,磁盘占用更小,适合原型、边缘部署或对体积敏感的场景。
- sqlite-vector 提供量化、可配置距离度量等生产级特性,搜索时内存效率和速度更优,适合对性能有要求的正式环境。
对于想在不引入独立向量数据库的前提下、快速为应用加上 RAG 能力的开发者来说,SQLite 加向量扩展是一条足够务实的路径。
相关推荐
从 ownCloud 迁移:自建 5 副本 3 地备份的家庭 NAS 实践
一位 Reddit 用户分享了从 WD MyCloud 到自建 ownCloud 的完整历程,展示三地五副本的 ZFS+Proxmox 备份架构,并深入探讨 ownCloud 客户端停止支持经典版后向 OCIS、Nextcloud、OpenCloud 迁移的抉择。
Agent Skills 是什么?从理解到定制的开发入门指南
Agent Skills 是智能体开发中的重要一环。本文解析 Skill 的概念、在 Claude Code 等 Agent 生态中的位置,以及从理解、定制到应用的三步学习路径,帮助零基础开发者快速入门。
Omarion SEC CLI:自愈式自主智能体如何解决AutoGPT顽疾
Omarion SEC CLI 是一款开源自主命令行智能体,通过长期记忆、执行指纹自愈、目标评估门和意图路由,解决 AutoGPT 类工具的错误循环、终端杂乱与会话失忆问题。本文解析其架构设计与三阶段演进。