背包里的AI超算:DeepSeek离线推理220tok/s实测
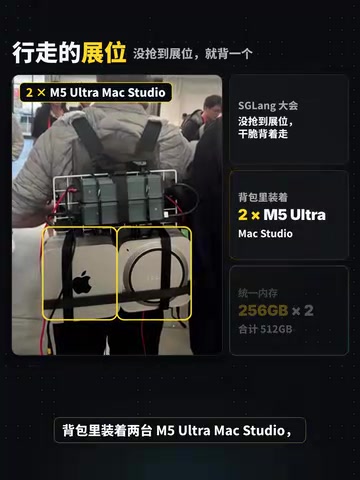
两台Mac Studio加电动车电池,背包里离线跑出220 Tokens每秒的本地大模型推理。
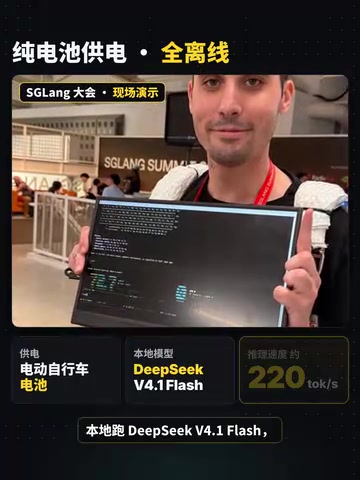
EXO Labs在SGLM大会现场因未抢到展位,用两台各配256GB统一内存的Mac Studio组成背包式本地集群,以电动自行车电池供电,离线运行DeepSeek V4.1 Flash,推理速度约220 Tokens每秒。512GB统一内存是完整装下模型的硬性前提,双机拼接是容量刚需而非性能冗余。速度则依赖Thunderbolt 5 RDMA将机器间延迟压到几微秒,使张量并行实际可用,加上MoE架构让每个Token只激活部分专家以降低计算量。背后的开源框架EXO自动完成设备发现、拓扑感知和模型分片,可把多台Apple Silicon设备聚合为本地集群。方案验证了本地分布式推理的工程可行性,价值在于隐私、离线与绕开云端按Token计费。
在SGLM大会现场,EXO Labs团队因为没抢到展位,干脆把两台Mac Studio塞进背包,做成了一个「行走的展位」。这套背包方案在本地离线运行DeepSeek V4.1 Flash,推理速度大约220 Tokens每秒。这个数字放在云端不算稀奇,但放在一个靠电动自行车电池供电、背在身上的设备上,意义完全不同。
硬件配置:两台Mac Studio的暴力堆料
这套方案的核心是两台M5 Ultra Max Studio,每台配备256GB统一内存,合计512GB。供电来自一块电动自行车电池,整套设备可以随身携带、脱离插座运行。
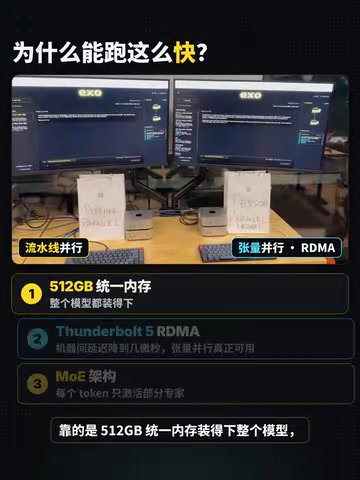
512GB统一内存是能跑起来的前提。DeepSeek广告 V4.1 Flash的模型体量需要足够大的内存池才能完整装下,单台256GB不够,两台拼接刚好跨过门槛。这也解释了为什么团队选择「双机」而不是单机——不是性能冗余,而是内存容量刚需。
220 Tokens每秒是怎么做到的
能达到约220 Tokens每秒,靠的不只是内存大。EXO Labs在演示中提到的关键因素包括三个层面。
Thunderbolt 5 RDMA:把机器间延迟压到几微秒
两台机器要协同推理,机器间通信延迟是最大瓶颈。这套方案使用Thunderbolt 5 RDMA,把机器间延迟降到几微秒级别。这个量级的延迟让张量并行(Tensor Parallelism)从「理论可行」变成「实际可用」——如果跨机通信慢一个数量级,张量并行的收益会被通信开销吃光。
RDMA(Remote Direct Memory Access,远程直接内存访问)是一种让一台机器直接读写另一台机器内存的技术,数据搬运绕过双方的操作系统和CPU协议栈,由网卡或接口控制器直接完成。传统网络通信要经历用户态到内核态的多层拷贝和中断处理,延迟通常在几十到几百微秒;RDMA把这一路径压缩掉,延迟可以降到个位数微秒。在多机张量并行推理中,每生成一个Token都要在机器之间同步中间激活值或梯度分片,通信次数极密,因此机器间延迟几乎直接决定整体吞吐。Thunderbolt 5提供高带宽和低延迟的点对点连接,配合RDMA语义后,两台Mac Studio之间的数据交换接近共享内存的体验,这是双机协同能跑到220 Tokens每秒的底层条件之一。
MoE架构:每个Token只激活部分专家
DeepSeek V4.1 Flash采用MoE(混合专家)架构,每个Token只激活部分专家,而不是调动全部参数。这大幅降低了单次推理的计算量,是速度表现的另一个支点。大内存负责「装得下」,MoE负责「算得省」,两者配合才有220 Tokens每秒的结果。
MoE(Mixture of Experts,混合专家)把模型的前馈层拆成许多并行的「专家」子网络,并配一个路由网络,对每个Token只选择其中少数几个专家参与计算。这样模型的总参数量可以做得很大以提升容量,但单次前向的实际计算量只与激活的专家数相关,而非全部参数。代价是显存占用仍按总参数量计算——所有专家都得装进内存,这正是512GB统一内存成为刚需的原因。也就是说,MoE把「算得省」和「装得大」拆成了两件事:计算侧靠稀疏激活降低FLOPs,存储侧仍需要完整容纳全部专家权重。理解这一点,才能明白为什么这套方案既需要大内存、又能获得高吞吐。
张量并行(Tensor Parallelism)是把单个Transformer层的权重矩阵按维度切分到多台设备上,每台设备只持有和计算一部分,再通过集合通信(如All-Reduce)把部分结果汇总。它是模型大到单卡装不下时的标准分布式策略,与按层切分的流水线并行不同,张量并行在每一层内部都会产生通信,因此对设备间带宽和延迟极为敏感。通信开销一旦超过并行带来的计算收益,加速比就会急剧下降。这正是前文强调几微秒级延迟的原因:只有当跨机通信足够快,张量并行才能从「理论可行」变为「实际可用」,双机拼接也才真正等价于一台更大的机器。
EXO:把多台Apple Silicon变成一台机器
这套演示背后的开源项目是EXO,一个分布式推理框架。它的价值在于自动化:设备发现、拓扑感知、模型分片全部由框架完成,用户不需要手动配置哪台机器跑哪一层。
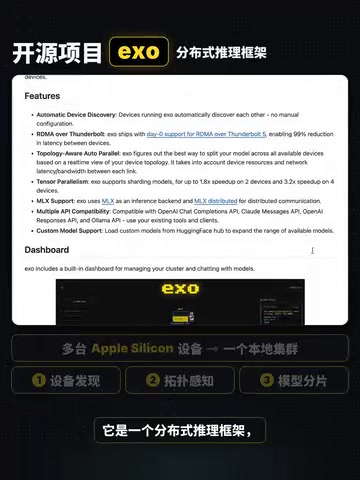
EXO能把多台Apple Silicon设备自动组成本地集群。这意味着这套思路不局限于「两台Mac Studio」这种极端配置——理论上,手边的多台Mac设备都可以被聚合成一个推理集群。对于需要本地跑大模型、又不想依赖云端的开发者和团队,这提供了一条可复制的路径。
这套方案意味着什么
把数据中心级别的推理能力压缩到背包里,最直接的意义是隐私与离线。模型和数据都不出本地,没有网络依赖,适合对数据敏感的场合。
另一个值得注意的点是成本结构。用消费级硬件加开源框架拼出可用的推理集群,绕开了云端按Token计费的模式。当然,这套配置本身的硬件投入不低,两台高配Mac Studio加电池的方案更像是技术演示而非大众方案。但它验证的方向很明确:本地分布式推理的工程可行性已经打通,剩下的问题是规模化和易用性。
对普通用户来说,短期内更现实的做法可能是用EXO把手里已有的几台Apple Silicon设备组起来,而不是照搬这个背包方案。框架本身是开源的,门槛主要在硬件和调优。
相关推荐
Anthropic招股书深度拆解:800亿亏损是骗局还是会计幻术?
Anthropic递交S-1招股书,800亿美元净亏损与160亿美元季度营收并存,引发“世纪骗局”质疑。本文拆解其会计调整、云市场总额法收入确认、9000亿美元计算承诺与双重股权治理,判断这究竟是财务幻术还是真实增长故事。
Anthropic IPO估值悬疑:万亿定价与S-1背后的真实生意
Anthropic已提交S-1申请在纳斯达克上市,估值从2万亿降至1.5万亿甚至1万亿。本文深度分析其收入增长、客户质量、8954亿美元算力承诺、1040亿美元净亏损及治理结构,给出IPO投资框架。

Vibe Coding入门到实战:AI意图编程范式与工具横评
Vibe Coding是什么?本文拆解AI意图编程范式,对比Claude Code、Trae、质谱、Cursor等主流工具的效率、成本与中文支持,并给出个人选择建议与趋势判断。