本地AI为何难普及?算笔账就明白了

本地AI成本高、门槛高、效果弱,当前只适合爱好者,未来出路在操作系统级混合路由。
文章基于一位YouTube科技博主的实测与分析,讨论本地AI为何难以取代云端订阅。作者先厘清本地AI与开源权重AI的区别,指出顶尖开源模型参数庞大,消费级硬件无法承载。随后用成本-质量图算账:4000美元电脑分摊每月约144美元,速度与智能均落后于每月27美元的Claude Haiku 5.5;RTX 5090、Mac Studio等高端方案同样性价比不佳,帕累托前沿几乎被闭源模型占据。结构性原因在于数据中心抢占GPU产能推高显卡价格,而开源AI公司缺乏可持续商业模式,依赖NVIDIA与中国政府补贴。结论是本地AI目前只服务于有技术、有钱、有时间的爱好者,未来希望在于操作系统厂商主导的隐形化混合AI与本地路由。
本地AI的讨论热度一直不减,但一个尖锐的问题摆在我们面前:如果你劝一个普通用户退订ChatGPT,转而自己在家跑模型,那基本是在开玩笑。本地AI昂贵、配置门槛高,效果也追不上前沿闭源模型。一位长期关注AI的YouTube科技博主最近发布视频,用详实的数据和切身经历给出了同样的结论——尽管他本人比任何人都更希望本地AI能成功。
本地AI vs 开源AI:先厘清概念
该博主首先强调,本地AI不等于开源AI。开源权重模型(Open Weights)是指模型权重公开、任何人都可以免费使用,但通常运行在AWS、Google等大型数据中心里,通过API服务用户。本地AI则要求模型真正跑在你自己的电脑或家庭设备上,断网之后依然能回答问题。
目前顶尖的开源权重模型确实很强,但它们的参数量巨大,动辄万亿级别,普通消费级硬件根本跑不动。想在本地获得接近前沿的智能水平,几乎需要自建小型数据中心。
开源权重(Open Weights) 指模型的参数文件公开可下载,任何人可自由使用、修改或再分发,但训练数据、训练代码和完整训练流程未必公开,因此不等同于完全开源的软件。典型代表包括 Llama、Qwen、DeepSeek广告 等系列。用户拿到权重后,既可以自己部署在本地,也可以托管在云服务器上对外提供 API 服务——后者正是许多云厂商的商业模式。理解这一区分很关键:模型“开源”只解决版权与获取门槛问题,并不降低运行所需的显存、算力和工程维护成本,这也是后文本地部署经济账算不过来的根本原因之一。
本地AI的诱惑:数据主权与自主控制
博主列举了本地AI的几个核心吸引力。首先是数据主权——使用ChatGPT或Claude时,数据都发往了云端,尽管多数人已习惯把数据交给大科技公司,但敏感场景下本地处理更让人安心。其次是不受平台规则摆布:AI实验室可以随时修改条款、限制你用订阅额度做的事。此外,离线可用对于有特殊需求的用户(如野外工作者或应急准备者)仍有价值。
更深层的动机是“拥有自己的智能”。博主坦言,他最大的担忧之一是AI权力过度集中,如果所有人的智能都依赖少数几家前沿实验室,权力集中程度会令人不安。本地AI能分散这种权力。
但理想丰满,现实却需要先算一笔账。
算笔经济账:硬件成本远超订阅费
博主用一张成本-质量图展示了残酷的现实。以Qwen 3.8 27B为例,假设一台4000美元的电脑用三年,分摊下来每月约144美元,每秒约50个token,在Artificial Analysis智能指数上得分约34。相比之下,Claude Haiku 5.5每月仅需27美元,速度达每秒235个token,智能指数还高出约10分。
更高端的硬件情况同样不乐观。RTX 4090如今价格逼近5000美元,跑紧凑模型约25-40 token/秒,处于可用下限;RTX 5090售价约8500美元,同款模型能到40-70 token/秒,但只能单线程运行——无法并行启动多个agent。RTX 6000 Ada价格相近,跑CodeCoder Next可达50-130 token/秒,同样不支持并行。而RTX Pro 6000 Blackwell要价约1.6万美元。
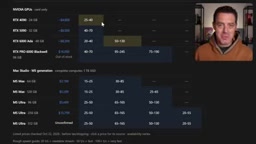
Mac Studio路线也不例外:256GB内存版本约1万美元,512GB约1.5万美元,跑前沿模型每秒仅20-55 token。博主强调,在成本-质量图的帕累托前沿上,几乎全是闭源模型——更便宜、更快、开箱即用、跨设备同步、持续进化,而本地AI需要自己折腾配置和维护。
Artificial Analysis 智能指数 是一个第三方模型评测聚合指标,它把 MMLU-Pro、GPQA Diamond、Humanity's Last Exam、LiveCodeBench 等多项基准的得分标准化后加权汇总,用以横向比较不同模型的综合能力。指数越高代表模型在推理、知识、编程等任务上的平均表现越强。需要留意的是,这类综合指数无法反映特定场景下的实际体验,例如长上下文处理、工具调用可靠性或多轮对话稳定性。文中用它对比本地模型与闭源 API 的“性价比”,说明的是同等智能水平下本地方案的每美元产出明显偏低,而非断言本地模型在每一项任务上都更差。
为什么本地AI的账算不过来?
博主分析了几重结构性原因。AI实验室大规模建设数据中心,抢占了GPU和内存产能,推高了消费级显卡价格——原本3000-4000美元的5090如今卖到近7000-8000美元,本地AI的硬件成本至少翻倍,但模型质量和生成速度并没有跟着翻倍。
其次,开源AI公司的商业模式在美国很难成立。投入数十亿美元训练出模型后免费公开,超大规模云厂商和新型云服务商拿去直接提供服务,纯赚利润。唯一的“白衣骑士”是NVIDIA,它投入数十亿美元支持开源权重模型,并收购了Hugging Face、Reflection AI等公司,为风投提供了一个退出预期。中国的开源模型则由政府补贴支撑,商业逻辑同样不闭环。博主提到有传言NVIDIA可能收购更多公司,这进一步说明开源AI缺乏独立可持续的商业模式。
帕累托前沿(Pareto Frontier) 原指在多目标优化中,不存在在不牺牲某一目标的前提下改进另一目标的解集合。放到文中的成本-质量图上,横轴是单位智能的成本、纵轴是模型能力,前沿线代表“在给定价格下能达到的最高智能水平”。落在前沿上的方案意味着无法用更低成本换到同等能力,也无法用同等成本换到更强能力。博主指出前沿上几乎全是闭源模型,即当前市场在“便宜且聪明”这一维度上已被云端 API 占满,本地方案整体位于前沿内侧,属于被支配的选择。
本地AI今天到底为谁而生?
答案有些无奈:爱好者。博主把自己也归入这个群体——他有充足算力、技术背景、时间,也渴望数据控制权,但真正要干活时,他还是打开ChatGPT和Claude。他把当下的本地AI比作“超频”:人们享受的是折腾配置、把最大模型跑起来、榨出最高token速度的过程,而不是用这些结果去完成实际工作。
要成为这类用户,你需要极强的技术能力、充裕的可支配收入、大量空闲时间,还得真心对这个领域感兴趣。四个条件缺一不可。
本地AI的未来:隐形化与混合路由
尽管批评尖锐,博主明确表示自己希望本地AI成功,并给出了他看好的路径。第一步是操作系统厂商——微软、苹果、谷歌——真正发力。它们同时掌控硬件和操作系统,最适合做混合AI。关键在于:用户不应该知道自己正在用本地AI。系统应自动判断,把敏感数据、重要文档留在本地处理,云端不可用时无缝回退到本地,用户完全无感。
第二步是本地路由。当小型模型变得更强、更快、更小,芯片也更高效时,更多任务可以在本地完成。日常AI助手处理的大多数任务并不需要最强模型——能在本地做的就本地做,超出能力的再发往云端。这种“环境AI”融入操作系统界面,才是本地AI真正普及的形态。
博主最后提醒,云端agent环境(如Muse、Grokbot)之所以有吸引力,是因为它们24/7持久、相互隔离、安全可控——本地AI要复刻这些体验,还有很长的路要走。他依然希望本地AI能成,只是今天,他还看不懂它。
混合路由(Hybrid Routing) 指系统依据任务类型、数据敏感度、当前网络与算力状况,自动决定请求由本地小模型还是云端大模型处理。常见策略包括:对含个人隐私或涉密文档的请求强制本地推理;对简单问答、摘要、纠错等轻任务优先本地;对复杂推理、长文生成或需要最新知识的请求转发云端;云端不可用时回退本地以保证可用性。工程上的难点在于路由判定的准确性、本地与云端模型输出风格的一致性,以及跨端上下文同步。这一思路与端侧 AI、环境计算的方向一致,也是操作系统厂商相对第三方应用更具优势的原因。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。