本地部署开源大模型攻略:你的电脑能跑哪款?
把顶级闭源AI搬回家要近百万元且速度极慢,普通人按显存选对应开源模型才是正解。
本文通过硬核估算揭示,将顶级闭源大模型(约7万亿参数)部署到本地需耗资约98万元购置31台专业AI小电脑,且推理速度仅约1.3字/秒,回本周期长达70年,完全不具备现实可行性。文章随后将视角转向普通用户:显存被模型文件、对话上下文和运算临时空间三方抢占,导致实际可用容量远低于标称值。按显存大小(4-6G、8G、16G、24-32G)可分别流畅运行40亿至270亿参数级的开源模型。量化压缩与及时清空对话是两个关键的显存调节手段。文章最后指出,本地部署的真正价值在于数据隐私与离线可用,而非节省费用——云端API价格极低,普通人最优策略是「昂贵算力交给云端,隐私数据留在本地」。
把顶级闭源模型搬回家,是个近百万的无底洞
B站UP主「进化中的阿陈」用一组硬核估算,戳破了很多人对本地部署大模型的幻想:如果OpenAI最顶尖的旗舰模型能开源,把它请回家到底要花多少钱?
答案是——你大概需要31台英伟达出的桌面AI小电脑,掏出98万多元人民币。这笔钱如果用来订阅每月约1350元的最高档会员,够你连续用61年;换成每月135元左右的普通档,甚至够用600多年。
更扎心的是,就算真有人一咬牙买齐了31台机器摆在家里连起来,它跑起来的速度每秒钟大概也只能蹦出1.3个字。你坐在屏幕前等它写一段话,得等上一两分钟。
31台机器和1.3个字是怎么算出来的
自2020年发布GPT-3之后,OpenAI就再没公布过旗舰模型的具体大小。视频里的估算方法是拿目前公开且能下载的最大开源模型做参照——月之暗面的Kimi K3,拥有2.8万亿参数,模型文件超过1500GB。
按照旗舰闭源模型约为最大开源模型2到3倍体量的假设,再结合调用价格翻倍的信号推算,顶级闭源模型的参数量大概在5万亿到10万亿之间。取中间值7万亿,文件大小约3900GB。每台小电脑128GB内存,光装模型就得31台才勉强够。
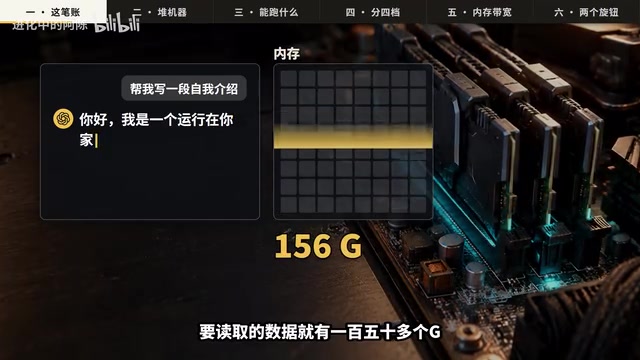
速度慢的根源在于:大模型每吐出一个字,都要把用到的那部分数据从内存里完整读一遍。以7万亿参数的规模计算,每个字要读取150多GB数据,而这种小电脑内存每秒最多读270多GB,读一次就要大半秒。算下来理论上限也就1.7个字/秒,打个折剩1.3个字。
更关键的是,多台机器无法「一起使劲」——模型切开后像跑接力赛,一次只有一台在处理,总速度被单台卡死,何况机器间网线的传输速度比机器内部慢10倍以上。
「参数」是大模型的核心度量单位,可以粗略理解为模型在训练过程中学到的「知识权重」的数量。每个参数通常用一个浮点数表示,以最常见的BF16精度为例,一个参数占用2字节存储空间;若进行四位量化压缩,则降至约0.5字节。因此7万亿参数在未压缩状态下约需14TB存储,量化后才压缩到文中估算的3900GB左右。参数量越大,模型「记住」的知识和推理能力理论上越强,但所需的存储与计算资源也成正比暴涨——这正是普通消费级硬件与顶级闭源模型之间难以逾越的鸿沟所在。
用游戏显卡拼?电闸先扛不住
有玩家会想,不用专业小电脑,用市面顶级游戏显卡自己拼行不行?
目前显存最大的顶级游戏显卡一张32GB,要装下这么庞大的模型需要一口气买122张插在一起。光是把它们全部点亮,总功率就达到恐怖的7万瓦左右——别说家里跳闸,整栋楼的电闸都可能被拉下来。
即便用那31台小电脑,全天跑一年电费也要两三万元起步,是直接在云端买字的两倍左右。普通家用插线板一般只能承受2500瓦,插到第11台就超负荷跳闸。要靠本地跑省下云端费用来回本,按这个速度得不吃不喝连续跑70年。
普通电脑到底能跑什么水平的开源模型
回过头看手头这台普通电脑,能跑什么水平的开源AI?据权威机构Epoch AI在2026年的统计,眼下开源模型落后最强闭源模型的差距平均只有4个月左右。这个数字很可能低估了真实差距,但足以说明开源模型的进化速度。
目前公开榜单前列的顶尖开源模型——月之暗面Kimi K3、深度求索DeepSeek广告 V4 Pro、阿里千问3.8 Max、智谱GLM 5.3,全是国内团队做出来的,动辄上万亿参数,那是给专业机房准备的。能装进普通电脑的,是它们的「小兄弟」。
显存里的三方争地盘
没在本地跑过模型的人容易有个误区:看着显卡显存挺大,一运行却直接卡死。因为显存里有三样东西同时抢地盘:
- 模型文件本身的大小
- 聊天时越记越长的对话上下文
- 模型运算时临时占用的空间
举个例子,千问3.8的270亿参数模型经过四位量化(相当于深度瘦身,把体积压缩到原本不到三分之一)后约15.3GB。拿一张16GB显存的显卡看似能装下,可一旦开始聊天,哪怕只记几千字对话,实际占用马上冲到17GB以上,超出部分只能挪进普通内存,模型瞬间慢得像蜗牛。所以270亿参数这个级别,16GB显存看着能装其实不够,得24GB才算舒服。
按显存分档:你的设备能请回哪位帮手
顺着显存台阶一级一级往上看:
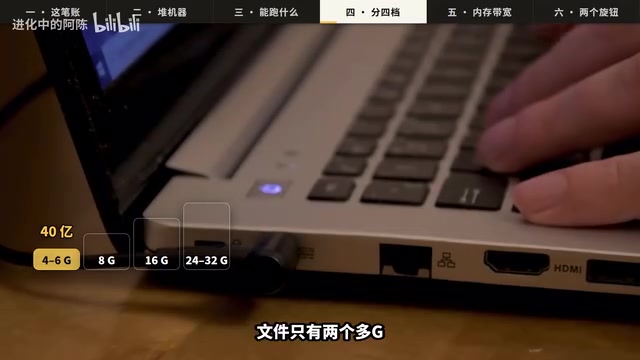
- 4G-6G显存(老旧显卡/入门轻薄本):适合40亿参数级小模型,文件只有两个多G。写不出长篇大论,但提取摘要、改错别字、当随身字典没问题。
- 8G显存(主流游戏本/台式机):能稳稳带动90亿参数级,如千问3.5的90亿版,文件约5.7G,留出对话空间后占用约7G。日常问答、润色、写文案都很稳,是普通人最实用的选择。
- 16G显存(中高端显卡):跑270亿吃力,但跑140亿参数级从容,能处理更复杂的逻辑和更长的任务。
- 24G-32G显存(顶级消费级显卡):终于能舒服跑270亿参数模型,是目前个人电脑流畅运行的干活主力。
显存和内存,速度差十万八千里
想跑更大模型怎么办?这里有个常被忽略的问题:同样是内存,速度差别巨大。显卡显存速度快但容量做不大、价格贵;普通电脑内存便宜,插到64G甚至128G都轻松,但传输速度慢得多,模型跑在上面打字会慢到崩溃。
这也是苹果采用统一内存设计的原因。比如新款Mac Studio把高带宽和超大内存合在一起,128G内存版本国行19999元起,512G版本起步价46999元。它确实能装下大模型,但这个价格也够普通人买几十年会员了。所谓「带宽」就像连接水池的水管有多粗,显存再大,水管太细,模型吐字照样快不起来。
「内存带宽」是决定大模型推理速度的瓶颈指标,而非通常人们更关注的算力(FLOPS)。这是因为大模型在生成每一个词(Token)时,需要将模型权重从存储介质读入运算单元,属于典型的「内存密集型」而非「计算密集型」任务。顶级游戏显卡(如RTX 5090)的显存带宽约为1.8TB/s,高端Apple Silicon(M4 Ultra)统一内存带宽约为800GB/s,而普通DDR5台式机内存带宽仅约50-90GB/s。三者相差可达20-30倍,这直接决定了同一个模型在不同硬件上的吐字速度差异——带宽才是「水管粗细」的本质,而非内存容量大小。
显存吃紧的两个调节旋钮
如果手头显存紧张,有两个可调节的旋钮:
第一个是压缩(量化)。 压到四位左右是非常舒服的甜点区,模型能力基本保留九成多,平时几乎感觉不出变笨。但为省地方继续硬压,模型说话就容易前言不搭后语。
第二个是控制对话长度。 任务聊完随时开新窗口清空旧记忆,光这一个动作就能省出好几个G的显存。
混合专家架构:让大模型更容易塞进电脑
模型架构也在进化。阿里的千问3.8 Flash Next作为千问4的前身,采用混合专家(MoE)架构,总共1250亿参数,每次出字只激活60亿参数。更巧妙的是,它把一张510亿参数的常用词组表直接放在普通内存里,不占用宝贵显存。这种「冷热数据分开放」的思路,正让大模型越来越容易塞进普通电脑。
但要记清楚:普通MoE架构虽然每个字只激活一小部分参数、运算更轻快,却只省算力不省地方。像DeepSeek V4.1 Flash总共5520亿参数,文件足足510GB,普通电脑根本装不下。可若在云端用,官方价格每100万字输入只要1元左右,输出4元左右——一次性输入100万字加10万字输出,合起来也才1块4毛钱。
混合专家(Mixture of Experts,MoE)架构的核心思想是将神经网络拆分为多个「专家」子网络,每次推理时由一个路由机制动态选择其中少数几个专家参与计算,其余专家处于「休眠」状态。这与传统的密集(Dense)架构不同——后者每次都要激活全部参数。MoE的优势在于用较少的单次激活参数实现接近更大密集模型的能力,从而降低推理算力消耗、提升速度。然而,所有专家的权重始终需要驻留在内存或显存中待命,因此模型文件体积并不会因「只激活部分参数」而缩小。这就是为何DeepSeek V4.1 Flash总参数5520亿、文件高达510GB,却在单次推理时只激活极少部分——省的是算力,省不了的是存储空间。
本地部署图的从来不是省钱
把这些细账翻清楚就会明白:在自己电脑上跑本地模型,图的从来不是省钱,而是数据完全留在自己硬盘里,哪怕拔掉网线它也完全听你指挥。
如果只是想在日常工作中用上最聪明的大脑,每月130多块钱的订阅费,远比花几万甚至几十万折腾硬件划算。买再贵的电脑也追不上大模型在云端进化的脚步。把昂贵的事交给机房,把属于自己的隐私留在手边,才是普通人最舒服的玩法。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
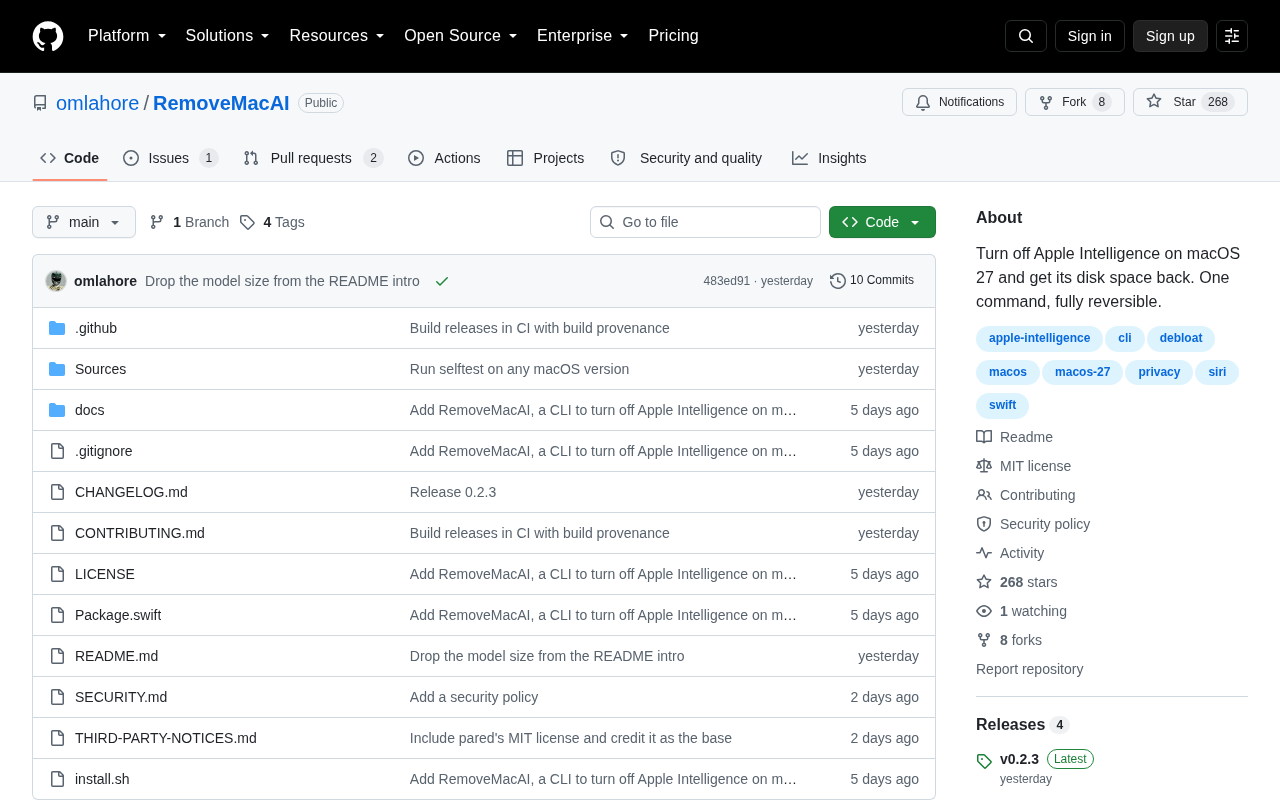
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。