本地部署Qwen3 27B实测:单张5090能跑出什么效果?
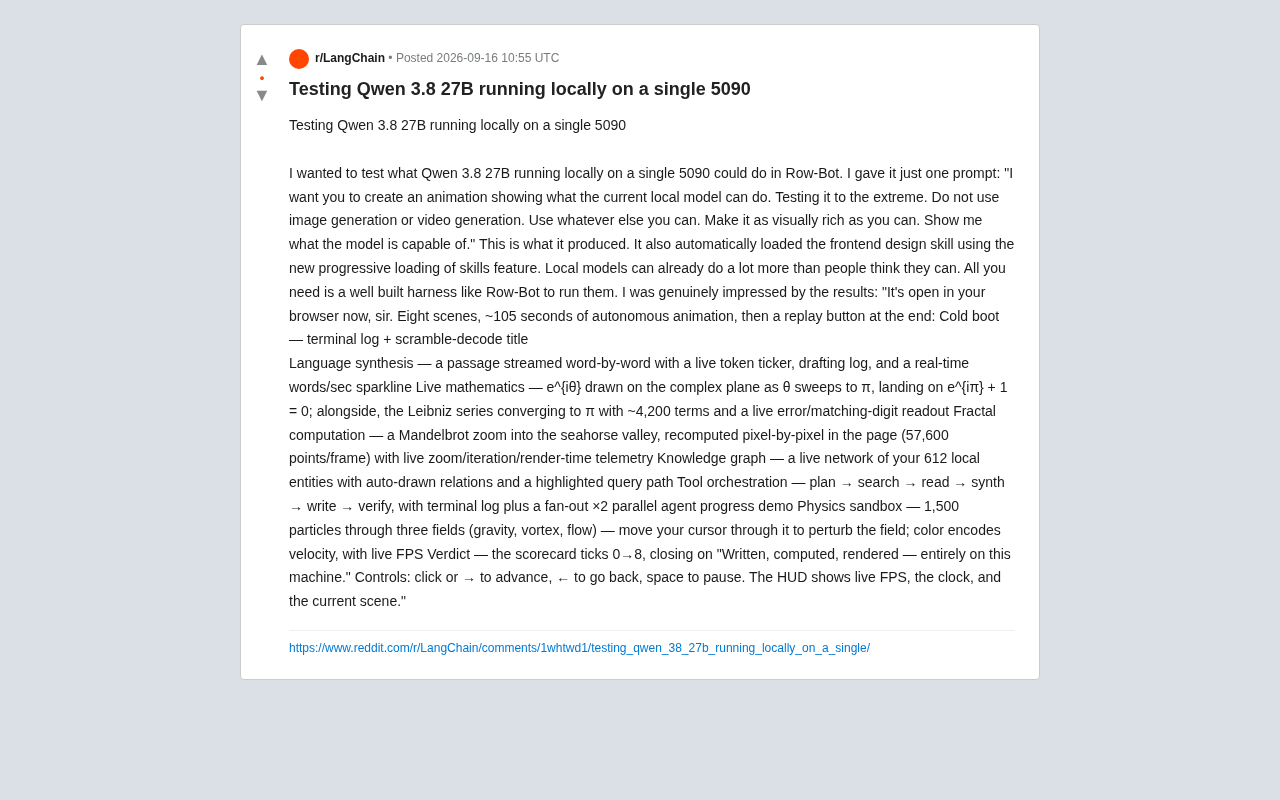
单张RTX 5090本地跑Qwen3 27B,一条提示词生成8场景实时交互动画,展示本地中型模型被低估的实力。
一位开发者通过自研Agent框架Row-Bot,用单张RTX 5090本地运行Qwen3 27B模型,仅下达一条开放式提示词,模型便自主生成了包含8个场景、约105秒的交互式动画。内容涵盖实时数学可视化(欧拉恒等式推导)、曼德博分形逐像素实时渲染、1500粒子物理沙盒、知识图谱等,全部为浏览器端即时计算,并附有完整性能遥测数据。测试的核心启示有两点:其一,27B级本地模型的实用上限被普遍低估;其二,Agent框架的质量——尤其是渐进式技能加载等工程机制——对模型实际表现的影响往往超过参数量本身。文章同时提示,该测试为单一来源个人记录,模型命名与配置细节存在歧义,可复现性有待验证。
一次极限测试:让本地模型自证实力
一位开发者在Reddit上分享了他用单张RTX 5090显卡本地运行Qwen3 27B模型的实测结果,结论颇具冲击力——本地模型的能力,可能远比大多数人想象的要强。
他的测试方法很直接:通过自研的Agent框架Row-Bot运行模型,只下达了一条提示词——「我要你创建一个动画,展示当前本地模型能做什么。极限测试它。不要用图像生成或视频生成,用其他任何你能用的手段,把画面做得尽可能丰富。让我看看这个模型的真本事。」
值得关注的一点是,模型在执行过程中自动加载了「前端设计技能」,用到了框架新增的「渐进式技能加载(progressive loading of skills)」特性。这意味着模型不是被动等待指令,而是根据任务需求主动调用相应能力模块。
模型交出的答卷:8个场景的自主动画
模型最终生成了一个可在浏览器中直接打开的交互式动画,包含8个场景、约105秒的自主播放内容,结尾还带有重播按钮。每个场景都在展示不同维度的计算与渲染能力:
从冷启动到语言合成
- 冷启动(Cold boot):终端日志配合乱码解码式的标题动画,营造出系统启动的氛围。
- 语言合成(Language synthesis):一段文字逐词流式输出,配有实时token计数器、草稿日志,以及实时的「每秒词数」波形图。
这部分本质上是在可视化模型自身的生成过程,把通常隐藏在后台的推理动态直接呈现出来。
数学、分形与知识图谱
- 实时数学(Live mathematics):在复平面上绘制 e^{iθ},随θ扫向π,最终落在欧拉恒等式 e^{iπ} + 1 = 0 上;同时用莱布尼茨级数逼近π,约4200项,并实时显示误差与匹配位数。
- 分形计算(Fractal computation):对曼德博集合的「海马谷」进行缩放,逐像素在页面内重算,每帧57600个点,并显示实时缩放、迭代次数与渲染耗时的遥测数据。
- 知识图谱(Knowledge graph):把本地的612个实体绘制成实时网络,自动生成关系连线,并高亮一条查询路径。
这些场景的共同点在于——它们不是预渲染的素材,而是浏览器端实时计算的结果,配有完整的性能遥测。
工具编排与物理沙盒
- 工具编排(Tool orchestration):完整演示了「计划 → 搜索 → 阅读 → 合成 → 写入 → 验证」的流程,还包含一个×2并行智能体进度的扇出演示。
- 物理沙盒(Physics sandbox):1500个粒子穿越重力、涡流、流场三种力场,用户可用光标扰动场,颜色编码速度,实时显示FPS。
- 结论页(Verdict):评分卡从0跳到8,最后定格在「Written, computed, rendered — entirely on this machine.(全部在本机完成撰写、计算与渲染)」。
交互控制也做得完整:点击或右方向键前进,左方向键后退,空格暂停,HUD显示实时FPS、时钟和当前场景。
曼德博集合(Mandelbrot Set)是复平面上最著名的分形图形之一,其每个像素点的颜色由该点对应的复数经过迭代计算后是否"逃逸"来决定,计算量随分辨率和迭代次数线性增长。「海马谷」是曼德博集合边界处一个特征性的螺旋形区域,因其形似海马尾部而得名,是分形爱好者常用的缩放目标。在浏览器端逐像素实时重算意味着没有预缓存,每一帧都是CPU/GPU即时运算的结果,每帧57600个点意味着画布分辨率约为320×180,这对JavaScript来说已属计算密集型任务,能实时渲染并同步显示遥测数据,本身就是对浏览器端计算能力的一次实际压测。
为什么这次测试值得关注
这次实测的意义不在于动画本身有多炫,而在于它反映的两个趋势。
第一,本地中型模型的实用性被低估。27B级别的模型在单张消费级旗舰显卡上就能跑,还能自主完成如此复杂、多环节的编排任务。分享者的原话是:「本地模型的能力已经远超人们的想象,你需要的只是一个构建良好的框架来运行它们。」
第二,Agent框架的作用被放大。同样的模型,放在不同的执行框架里,产出天差地别。渐进式技能加载这类机制,让模型能按需调用能力而非一次性塞满上下文,这是把中型模型能力「压榨」出来的关键工程手段。
需要提醒的是,这是单一来源的个人测试,模型型号标注为「Qwen 3.8 27B」的写法本身存在一定歧义(Qwen3系列的命名通常为Qwen3-XXB),实际配置、量化方式、生成耗时等细节均未披露,结果的可复现性有待验证。但作为一个直观的能力展示,它确实提供了一个有价值的观察窗口:本地部署的天花板,或许比很多人设想的要高。
渐进式技能加载(Progressive Skill Loading)是Agent框架中一种按需动态扩展模型上下文能力的机制,与「一次性将所有工具描述塞入系统提示词」的传统做法相对。后者在工具数量增多时会显著膨胀上下文长度,既消耗显存,又可能干扰模型对当前任务的注意力分配。渐进式加载则在模型判断当前子任务需要某项技能时,才将对应的工具定义或技能描述注入上下文,从而在保持响应质量的同时降低显存压力。这对本地运行的中型模型尤为关键——27B参数的模型在单张显卡上的可用上下文窗口本就有限,精细的上下文管理是将其能力完整释放的前提。
对本地AI玩家的启示
对于关注本地部署的开发者和爱好者,这个案例传递了几点实际信息:硬件门槛上,单张5090已能承载27B级模型的复杂任务;软件层面上,Agent框架的质量往往比模型参数量更能决定实际体验;能力边界上,纯代码生成加实时计算的组合,能让模型在不依赖图像/视频生成模型的前提下产出视觉丰富的成果。
本地模型与云端大模型的差距正在被工程手段持续缩小。当框架足够成熟,一台配备旗舰显卡的个人电脑,已经可以是一个相当能干的AI工作站。
相关推荐
iPhone 18 Pro相机升级:细节处的价值
iPhone 18 Pro相机更新聚焦细微处的体验提升,本文分析苹果从惊艳设计到渐进优化的策略取向,以及计算摄影与软件巧思在成熟硬件平台上的增量价值。
从企业实战到通用模板:AI Agent 构建经验分享
一位开发者分享了从企业内部数据集项目中抽象出的 AI Agent 通用模板,涵盖业务问答、深度数据分析、自动生成 PPT 和邮件分发的完整工作流,并已开源到 GitHub 供参考。
任天堂开放式设计再进化:《火焰纹章》新作Fortune's Weave解析
任天堂将《旷野之息》式的开放设计理念引入《火焰纹章》系列,在Switch 2平台推出规模宏大的新作Fortune's Weave。本文解析这一转变的设计意义与平台战略。