本地跑大模型是幻觉?开放权重的真实价值与硬件门槛

开放权重(Open Weight)与开源的真正含义
开源大模型(Open Weight)近年来发展迅猛,GLM 5.2、DeepSeek广告 系列等模型的能力已逼近顶级闭源前沿模型。但在一片赞誉声中,知名技术博主 Theo(t3.chat 创始人)却发出了一次「情绪爆发」式的吐槽:开放权重的模型很棒,但迷信「本地运行」的人正在伤害整个开源运动。
值得注意的是,「开放权重」(Open Weight)与真正意义上的「开源」(Open Source)存在重要区别。开放权重仅指模型的参数权重文件可供下载和使用,但训练数据、完整训练代码、RLHF标注数据等核心资产往往并不公开。真正的开源AI应符合OSI(开源促进会)的定义,包括可复现的训练流程和完全透明的数据集。Meta的LLaMA系列、GLM系列均属于开放权重而非严格意义上的开源,这一区分在法律使用权、商业化路径和学术可复现性上均有实质影响。理解这一区别,有助于更客观地评估「开源运动」的真实进展。
本文基于他的观点,梳理为什么「在自己的电脑上跑出媲美前沿模型的效果」在当下是一个不切实际的幻想,以及开放权重真正的价值究竟在哪里。
「能下载」不等于「能运行」
Theo 首先厘清了一个关键概念:模型是否开放权重,与你能否在家运行它,完全是两回事。
以他极力称赞的 GLM 5.2 为例,这是一款能力惊人、几乎逼近 Opus 4.x 的开放权重模型。但它的体量究竟有多大?
- 常规版本保守估计约 400GB
- 全精度 BF16 版本高达 1.5TB
- 即便是量化和剪枝后的版本,也仍在 200GB 左右
这里涉及一项关键技术——量化(Quantization):将模型权重从高精度浮点数(如BF16、FP32)压缩为低位整数(如INT8、INT4甚至INT2),核心目标是大幅缩减显存占用和存储体积。以一个700亿参数模型为例,BF16精度下每个参数占2字节,总计约140GB;量化至4-bit后降至约35GB,降幅达75%。然而量化并非无损:位数越低,模型在复杂推理、数学运算和多语言任务上的性能衰减越明显。量化让大模型「能跑」,但距离原版「够好」之间的差距,正是Theo所批评的核心鸿沟所在。
这意味着,没有任何一台普通家用设备能够完整运行这些模型。它们本质上是为数据中心级别的硬件设计的。
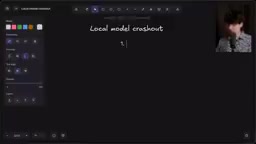
Theo 强调,人们口中的「本地模型」,实际上指的是那些勉强能跑的量化版 Gemma 之类的小模型——它们与真正强大的开放权重模型之间存在巨大鸿沟。这就是他所说的 「能跑」与「够好」之间的鸿沟(gap between runnable and good)。
硬件成本:普通用户难以承受的门槛
很多人误以为堆内存就能解决问题。Theo 对此进行了详细拆解:真正决定推理性能的是 VRAM(显存),而非系统内存。
VRAM(Video RAM,显存)是GPU板载的高速内存,专用于存储模型权重、KV缓存和中间激活值。与系统内存不同,VRAM与GPU计算单元之间的带宽极高(如RTX 5090的显存带宽超过1.7 TB/s),而CPU与系统内存之间的DDR5带宽仅约百GB/s量级,两者相差一个数量级以上。当模型权重超出VRAM容量时,推理引擎不得不将部分数据卸载到系统内存甚至硬盘(即「offloading」),推理速度会从数十TPS断崖式跌至个位数,严重影响实用性。苹果M系列芯片的**统一内存架构(Unified Memory Architecture)**是一个例外:GPU和CPU共享同一物理内存池,128GB统一内存可被GPU完整利用,这也是大内存MacBook在本地推理领域相对有竞争力的根本原因。
他举了一个扎心的例子:即便你的游戏 PC 装了 128GB 内存,搭配 RTX 5080(16GB 显存)或 5090(32GB 显存),依然塞不下这些大模型。因为一旦显存饱和,再多的系统内存也无济于事。
那么消费级方案还剩什么?他列出了三条现实路径,每一条都伴随着令人望而却步的代价:
三个「不太行」的本地部署选项
- 大内存 MacBook:依靠统一内存架构,128GB 版本可用,但近期涨价 30%-50%,加满内存要多花约 3000 美元。
- DGX Spark:能跑,但速度极慢(约 12 TPS),Theo 直言自己的那台「就是摆在那里吃灰」。
- Strix Halo(如 Framework Desktop):非 Mac 阵营中相对最优的选择,但因为不是高端 NVIDIA 显卡,性能有限。
关于速度指标——**TPS(Tokens Per Second,每秒生成token数)**是衡量大模型推理速度的核心指标。人类阅读速度约为每秒4-6个token,低于此速度的模型在交互体验上会明显让用户感到「卡顿」。DGX Spark的约12 TPS虽勉强可读,但对于需要快速迭代的开发工作流而言远远不够。

如果想真正跑大模型,成本更加离谱:一块拥有 96GB 显存的 RTX 6000 Pro Blackwell 售价约 13,000 美元;而由四块该卡组成的 tiny box 高达 75,000 美元,还只能勉强跑一个实例。
Theo 犀利总结:这类 GPU「作为二手倒卖商品,可能比真拿来用更划算」。
并行、电费与 Token 效率的三重现实
即便退一步,假设本地模型真的追平了前沿模型的能力,Theo 认为还有更根本的问题无法回避。
并行能力:一次只能跑一个
真实的开发工作流并非只跑一个 Agent。Theo 表示自己工作时会在 1 到 40 个 Agent 之间随机波动——同时运行多个线程、拆分子任务、Claude 和 Codex 并用。即便你搭建了能跑一次 GLM 5.2 的系统,你能同时跑十次吗?答案是:绝对不行。
这背后有深层的技术原因。**KV缓存(Key-Value Cache)**是Transformer架构中用于加速自回归生成的关键机制:模型在生成每个新token时,将之前计算的Key和Value矩阵缓存复用,无需重新计算所有历史token的注意力。然而KV缓存的大小与上下文长度、层数和模型维度成正比——对于拥有数百层的超大模型,单个长对话的KV缓存本身就可能占据数GB显存。当需要同时运行多个Agent时,每个并发请求都需要独立的KV缓存空间,显存需求呈线性叠加。vLLM通过PagedAttention技术将KV缓存碎片化管理,显著提升GPU利用率,但这依然无法解决单台消费级设备显存总量有限的根本约束。
硬件闲置时是纯粹的金钱浪费,需求超出预算时又会被卡住。他直言那些谈论 vLLM 缓存、批处理的「安慰话术」根本没有真正解决这个问题。
电费成本:拥有硬件不等于免费使用
Theo 现场让 GLM 5.2 计算:在旧金山 7×24 小时运行一块 RTX 5090,电费约为 每天 5 美元,一年近 2000 美元——而这还只是一块 GPU。「拥有硬件不代表免费使用。」
Token 效率:便宜未必划算
这是最容易被忽视的一点。开放权重模型往往「烧 token」严重。以 DeepSWE 基准测试为例:
- Opus 4.8 单次运行约 8 美元
- GLM 5.2 Max 单次约 4 美元
看似 GLM 每百万 token 价格便宜近 10 倍(3 美元 vs 25 美元),但由于它生成的 token 数量远多于前沿模型,实际成本差距只有 2 倍左右。更糟的是,生成 3 倍的 token 意味着即便速度快 20%,整体也依然更慢。
此外,GLM 5.2 甚至不具备视觉能力——无法看截图、无法完成 UI 反馈闭环,这在前沿模型早已标配的今天,是一个明显短板。
开放权重的真正价值:推动竞争,而非本地化
吐槽之余,Theo 也给出了他心中开放权重的正确打开方式。他引用了一条评论,认为一语中的:
「开源模型的最大价值不在于本地运行,而在于让提供商和硬件层面产生竞争。」

没有任何提供商能因为授权限制而低价提供 Opus,但任何人都可以在电费更便宜的地方托管 GLM 5.2。在 OpenRouter 这样的平台上,GLM 5.2 拥有大量托管选项——这一平台是统一的AI模型API聚合服务,允许开发者通过单一接口访问来自不同提供商的数百个模型,提供价格透明的横向比较,并可根据负载自动路由至最优提供商。同一个GLM 5.2模型可能由十几家不同的推理服务商托管,有的每秒 115 token 极速版,有的更便宜但稍慢的版本,用户可以在速度、成本、可靠性之间自由权衡。这正是开放权重打破单一厂商授权垄断、推动推理服务市场化竞争的具体体现。
Theo 指出,本地部署大模型的所有痛点,几乎都能通过云端托管解决:
- 能跑与够好的鸿沟 → 云端有足够硬件承载
- 硬件成本高 → 变成按需租用
- 并行受限 → 云端可弹性扩展
- 电费高 → 已折算进 token 价格,且数据中心可选电价低廉地区
唯一失去的,是「无人能窥探你在做什么」的隐私优势。而这一点,他寄希望于未来的**安全计算(Secure Compute)**技术来弥补——包括可信执行环境(TEE,如Intel SGX、AMD SEV)、同态加密和多方安全计算等方向。目前这些技术在AI推理场景中仍处于早期阶段,但随着NVIDIA Hopper架构引入机密计算支持,Theo的乐观预判并非遥不可及。在此之前,本地运行依然是对隐私敏感场景(如医疗、法律、企业内部数据)的唯一可靠选择。
手机跑大模型?入门芯片几乎原地踏步
对于「设备越来越强,早晚能本地跑一切」的乐观论调,Theo 用数据反驳:过去三年,高端 iPhone 和小米旗舰确有进步,但 200 美元档的廉价 Android 芯片性能几乎零增长,甚至略有倒退。叠加内存涨价与供应链压力,短期内不会好转。
他承认像 Gemma 3n 在手机端做消息摘要、天气总结这类本地轻量任务确实有价值——既保护隐私又免于上传数据。但用手机跑大模型只会烧干电池、导致过热,「远不如直接调 API」。
结语:别用幻想伤害开源运动
Theo 反复强调,自己是开放权重的坚定拥护者——t3.chat 正是因为他对 DeepSeek 系列的热爱而诞生。DeepSeek R1 曾以一己之力推动整个行业前进,这正是开放权重不可替代的意义。
他真正反对的,是那种「你可以在自己的 GPU 上跑出媲美前沿实验室效果、从而摆脱 Anthropic 和 OpenAI」的幻想式宣传。
「如果你只是喜欢搭建 GPU 集群、把玩这些模型,那太酷了,尽管去做。但如果你假装这是每个人都必须走的路,那就是在欺骗别人。」
这场「情绪爆发」的核心诉求其实很清晰:我们应该能够坦诚地讨论开放权重模型有多好,而不必用「你能在家运行它」这样的谎言去误导大众。
核心要点
相关推荐
MCP协议详解:AI Agent如何连接外部工具
MCP(模型上下文协议)是什么?本文从API、Function Calling讲到MCP三层架构,解析AI Agent如何连接日历、邮件等外部工具,并揭示提示注入、工具投毒两大安全风险及四条防护原则。

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。