本地大模型改配置翻车?聊聊vLLM运维的真实门槛

Reddit梗图折射本地LLM运维真实痛点:让模型自动改vLLM配置风险几何?
一条Reddit帖子调侃"让本地LLM自动修改vLLM配置,最好别出错",引发本地部署社区广泛共鸣。文章以此为切入点,剖析了将大模型用作推理服务运维助手时的核心风险:模型无法真正感知硬件环境,可能自信地生成不存在或已废弃的配置参数,而CUDA环境变量的"静默失败"特性使错误极难被发现。作者建议在借助LLM辅助配置时,必须交叉核对官方文档、做好版本控制,并优先采用`nvidia-smi`功率上限设置等可验证手段来替代来源不明的环境变量。结论是:LLM可作高效的"运维副驾",但关键改动的最终判断权不能拱手相让。
一条Reddit梗图背后的真实痛点
一位Reddit用户发了条颇有共鸣的帖子:"每当我让本地LLM去改动我的vLLM服务时……最好别出错。"配图是典型的社区调侃风格,但玩笑之下藏着不少本地部署玩家的真实焦虑。
这位用户表示自己一直在跑 Qwen 系列模型,把它当作 Hermes 和 Pi 等工作流的"驱动引擎",并尝试让模型自动帮自己添加环境变量 CUDA_DISABLE_PERF_BOOST=1,目的是降低服务器空闲时的功耗。这个场景放在今天的本地推理生态里非常典型:越来越多人把大模型当成运维助手,让它去修改自己的推理服务配置。
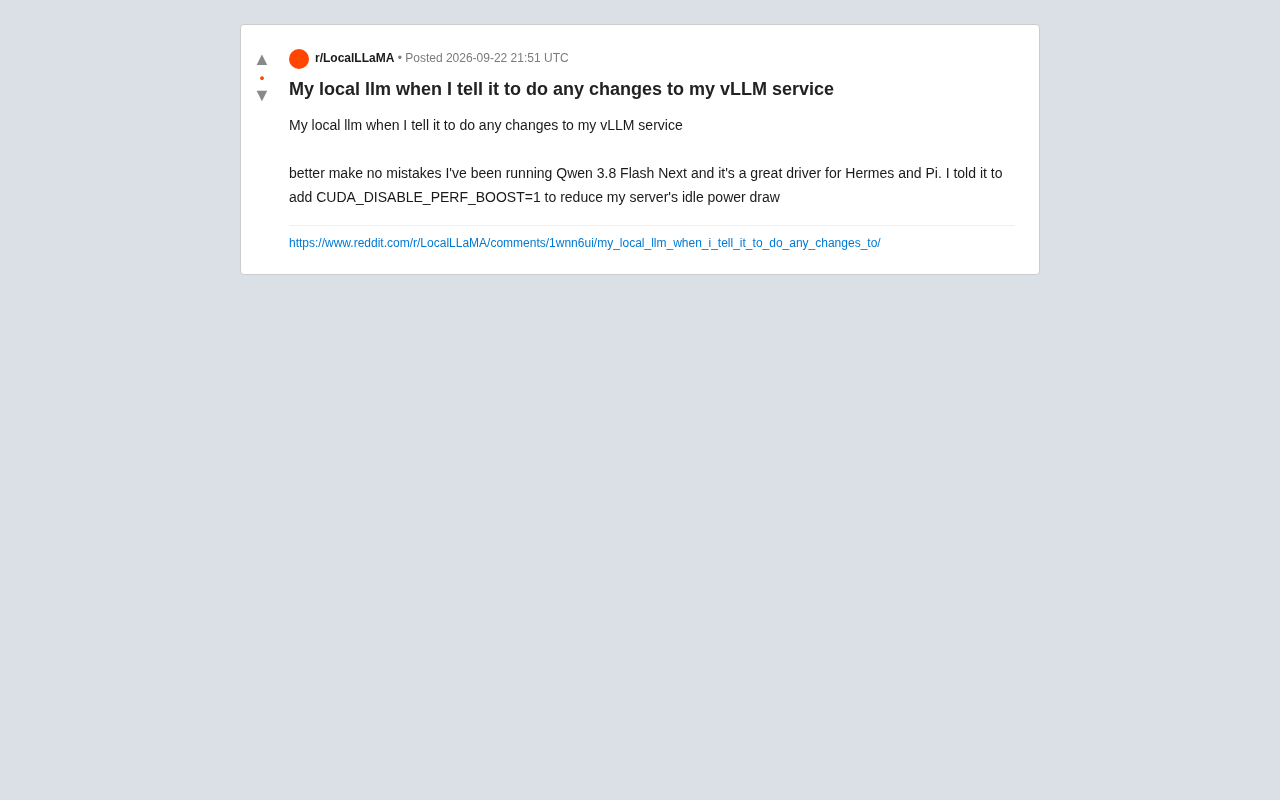
需要说明的是,原帖中提到的模型名称(如"Qwen 3.8 Flash Next")和环境变量写法带有明显的社区玩笑和夸张成分,未必对应真实存在的版本或参数。这也恰恰反映了一个现象:本地LLM圈子里,配置参数常常被半真半假地传播。
为什么"让模型改vLLM配置"是高风险操作
vLLM 作为当前最主流的高吞吐推理框架之一,其配置涉及 GPU 显存分配、并行策略、KV cache 管理、CUDA 环境变量等多个层面。任何一个参数改错,轻则服务启动失败,重则出现难以排查的性能退化或显存溢出。
把这类改动交给大模型自动完成,问题在于:模型并不真正理解你的硬件环境和运行时状态。它可能会"自信地"生成一个看起来合理、实则并不存在或已废弃的环境变量。原帖调侃的"最好别出错",正是对这种不确定性的自嘲——你不知道它给你加的那行配置到底是救命还是埋雷。
环境变量这类改动的隐蔽性
像调节功耗、性能的 CUDA 环境变量,往往不会在启动时报错,而是悄悄影响运行表现。如果模型建议了一个拼写错误或名称过时的变量,系统通常会直接忽略它,你以为省了电,实际什么都没发生。这种"静默失败"比直接崩溃更难发现。
vLLM(Virtual Large Language Model serving framework)由UC Berkeley开发,专为大语言模型推理设计,核心创新是PagedAttention——借鉴操作系统虚拟内存分页机制来管理KV cache,显著提升GPU显存利用率和并发吞吐。其配置文件涉及--tensor-parallel-size(张量并行度)、--gpu-memory-utilization(显存占用比例上限)、--max-num-batched-tokens(最大批处理token数)等数十个参数,这些参数之间存在复杂的依赖关系。例如,并行度设置必须与实际GPU数量匹配,显存利用率设置过高会导致OOM(Out of Memory)崩溃,设置过低则浪费硬件资源。正因为参数之间耦合性强,一处改动可能触发连锁反应,这也是将配置修改任务交给LLM时风险被放大的根本原因。
CUDA环境变量是NVIDIA提供的一套运行时调控机制,通过在进程启动前设置特定的环境变量,可以影响GPU的调度策略、功耗模式、性能状态(P-state)等底层行为。常见的合法示例包括CUDA_VISIBLE_DEVICES(控制可见GPU编号)和CUDA_LAUNCH_BLOCKING(同步化CUDA调用,常用于调试)。问题在于,NVIDIA的环境变量文档分散于驱动说明、CUDA Toolkit文档和各类白皮书中,且不同驱动版本支持的变量名称可能有所不同。LLM在训练数据中可能接触过大量非官方博客、Stack Overflow讨论甚至错误的转载内容,因此极易"编造"出格式正确但实际不存在或已被废弃的变量名——而Linux系统对未知环境变量不会报错,只会静默忽略,这使得验证难度大幅上升。
本地推理运维的正确姿势
如果你确实想借助LLM来辅助管理vLLM服务,有几个务实的做法值得参考。
先验证,再应用。 让模型解释每一个参数的作用和来源,而不是直接把它的输出粘贴进启动脚本。对于环境变量,去官方文档或NVIDIA的CUDA说明里交叉核对名称是否真实存在。
版本控制不能省。 无论是 systemd 服务文件、docker-compose 还是启动脚本,改动前先做好备份或纳入 Git 管理。这样即便模型改坏了,也能一键回滚。
关注功耗优化的真实手段。 如果目标是降低空闲功耗,更可靠的路径是通过 nvidia-smi 设置功率上限、使用 MIG 分区、或在无请求时卸载模型,而不是依赖某个来路不明的环境变量。
nvidia-smi是NVIDIA提供的命令行管理工具,支持实时查询GPU状态并对硬件进行运行时配置。其中nvidia-smi -pl <瓦数>命令可直接设置GPU的功率上限(Power Limit),在服务空闲时将功耗压低到TDP以下,效果立竿见影且可通过nvidia-smi -q -d POWER实时验证。MIG(Multi-Instance GPU)则是Ampere及更新架构上的硬件级分区技术,可将一张GPU切分为多个独立实例,每个实例拥有专属的显存和计算资源切片,既能隔离不同工作负载,也能在只需部分算力时避免整卡常驻高功耗状态。相比依赖来源不明的环境变量,这两种方式都有明确的官方文档和可验证的反馈机制,是本地推理场景下功耗管理的优先选项。
社区文化与技术现实的碰撞
这条帖子之所以引发共鸣,是因为它精准戳中了本地LLM爱好者的集体体验:我们既依赖模型的能力,又对它的可靠性心存戒备。把模型用作"运维副驾"是趋势,但"副驾"不等于"自动驾驶"——关键决策仍需人来把关。
随着 vLLM、SGLang 等推理框架不断迭代,配置的复杂度只增不减。让大模型帮忙梳理文档、解释参数、生成初稿是高效的;但真正动手改动生产或半生产服务时,那句"最好别出错"应该时刻挂在心上。玩笑归玩笑,动手之前多问一句"这个参数真的存在吗",能省下不少排查时间。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
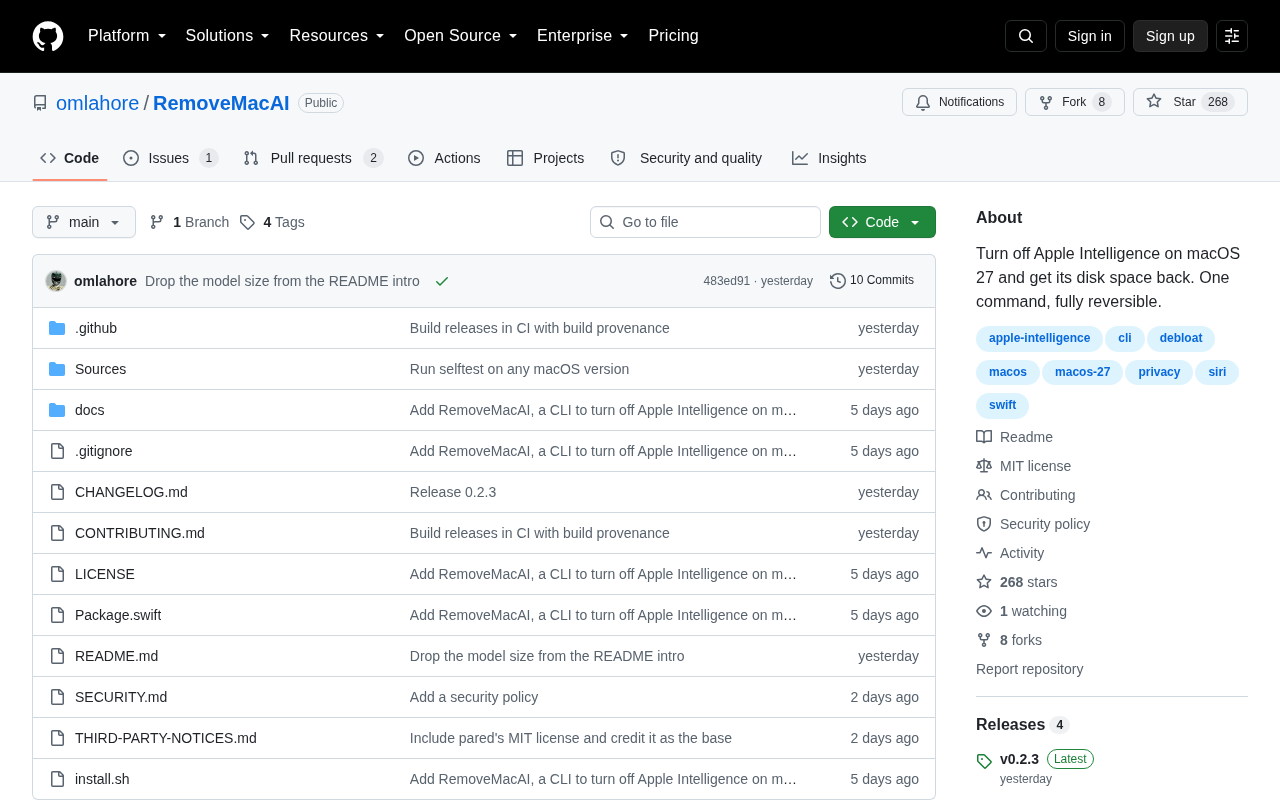
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。