#Qwen
共 27 篇相关文章

Qwen 4首测曝光:性能对标Opus 5.5,DeepSeek V4系列浮出水面
Qwen 4早期测试输出泄露,前端生成能力被指可对标Opus 5.5;DeepSeek V4 Mini、Flash、Pro命名同时出现在代码仓库;蚂蚁Ling-3.1-flash同步现身。本文梳理模型分层与端侧轻量化的最新线索。

Qwen4与Kimi3.1现身Arena:社区期待Qwen4 Flash
Reddit社区发现Qwen4和Kimi3.1现身LMSYS Arena,引发开源模型社区热议。用户最关注Qwen4 Flash的模型尺寸是否会延续3.8 Flash Next的规模,同时担忧监管政策对开源模型的影响。

Qwen 3.8 Flash Next实测:Reddit用户为何从质疑到真香?
Reddit用户分享Qwen 3.8 Flash Next使用体验:从观望到真香,在Strata框架下以IQ4 xs量化运行,表现接近去年专业级模型,适合本地部署。

AI Runtime 实战:Qwen 训练时间缩短 6 倍的优化解析
AI Runtime 将 Qwen 训练时间缩短 6 倍,本文解析大模型训练提速背后的通信优化、算子融合与显存调度逻辑,以及这一优化对开发者迭代效率的实际意义。

Qwen驱动链上Agent:REGLO如何用大模型决策太阳能调度
REGLO Agent在Monad黑客松中利用Qwen大模型完成链上太阳能调度决策,通过可解释推理与确定性验证分离的架构,实现安全真实的自动支付。

Qwen3小模型微调全流程实战:从原理到工程落地
一套系统讲解 Qwen3-0.8B 小模型微调的实战教程梳理,涵盖大模型原理、损失函数、Transformer架构、微调方法、数据准备与工程落地全流程,适合入门者与传统开发转型者。
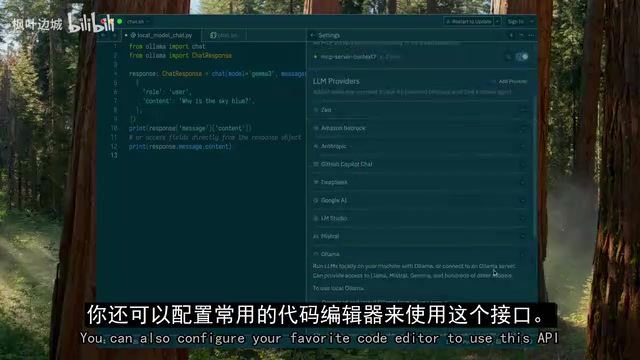
本地开源大模型跑代码实测:Qwen 3.5 够用吗?
海外资深开发者实测本地开源大模型 Qwen 3.5 跑代码:9B 小模型复杂任务翻车、小任务表现不错,397B 云端版本则轻松过关。附 Ollama 与 LM Studio 本地部署要点与显存门槛分析。
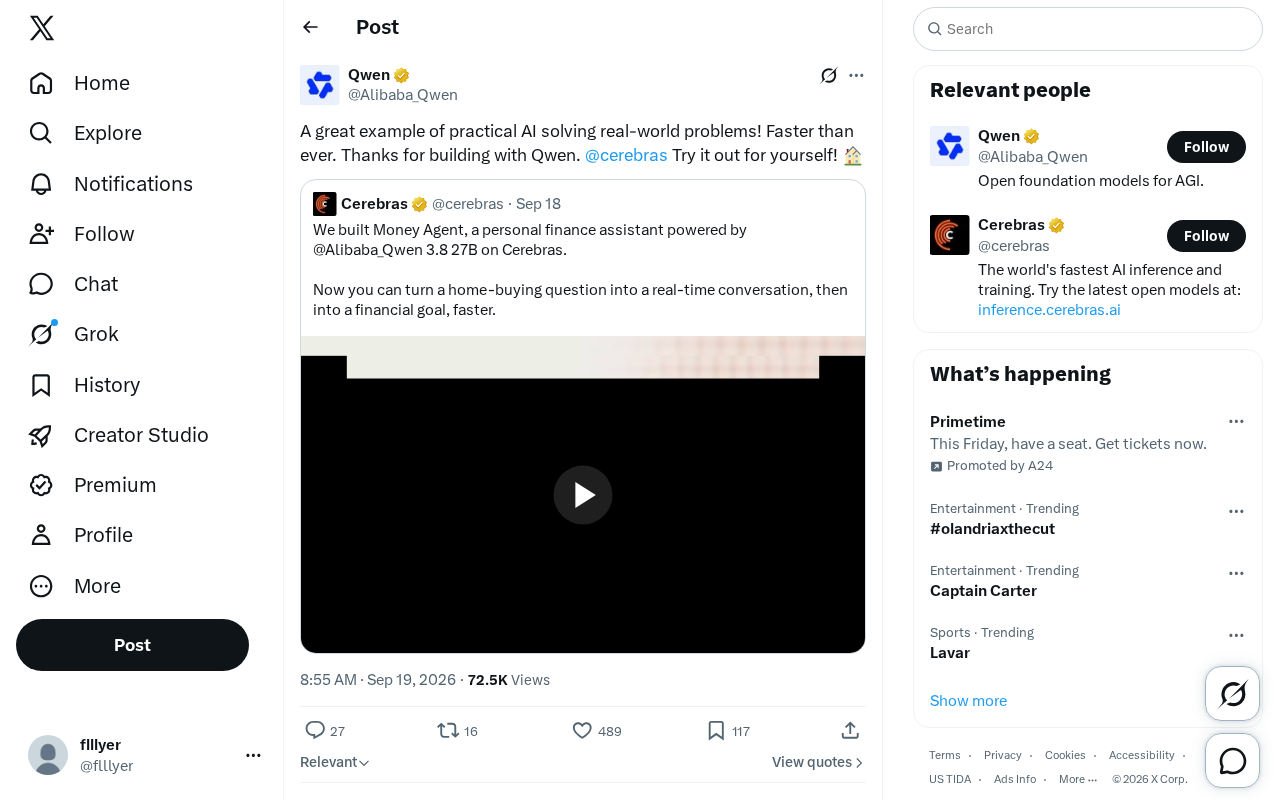
Qwen携手Cerebras:实用AI如何加速解决现实问题
一条社区推文展示了基于开源模型 Qwen 与 Cerebras 硬件加速构建的实用 AI 应用,速度前所未有地快。本文解析开源模型与专用推理硬件结合如何推动 AI 真正落地解决现实问题。
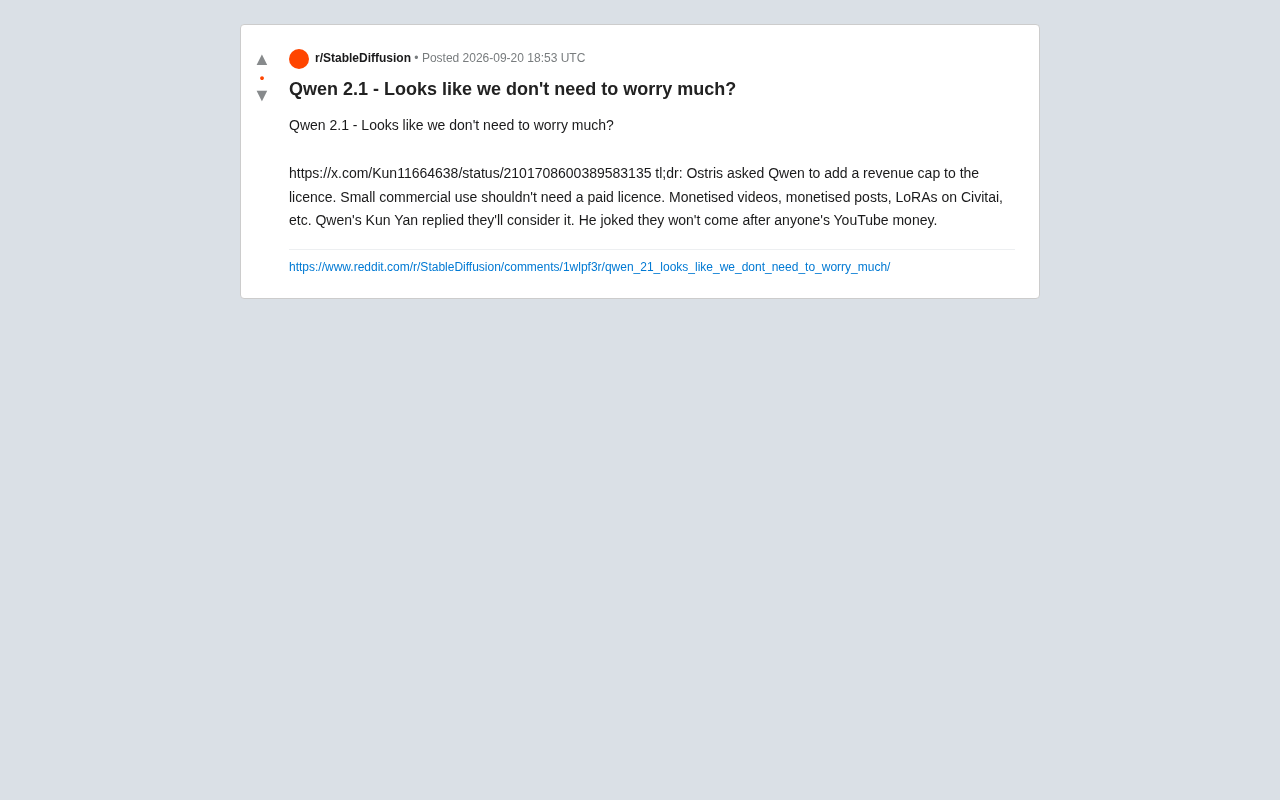
Qwen 2.1 许可证争议:小型商用或将免付费授权
开发者建议 Qwen 在许可证中加入营收上限条款,让小型商用免付费授权。Qwen 团队成员 Kun Yan 回应称会考虑,并调侃不会追究创作者的 YouTube 收入。本文解析这场许可证讨论对 AIGC 创作者的意义。
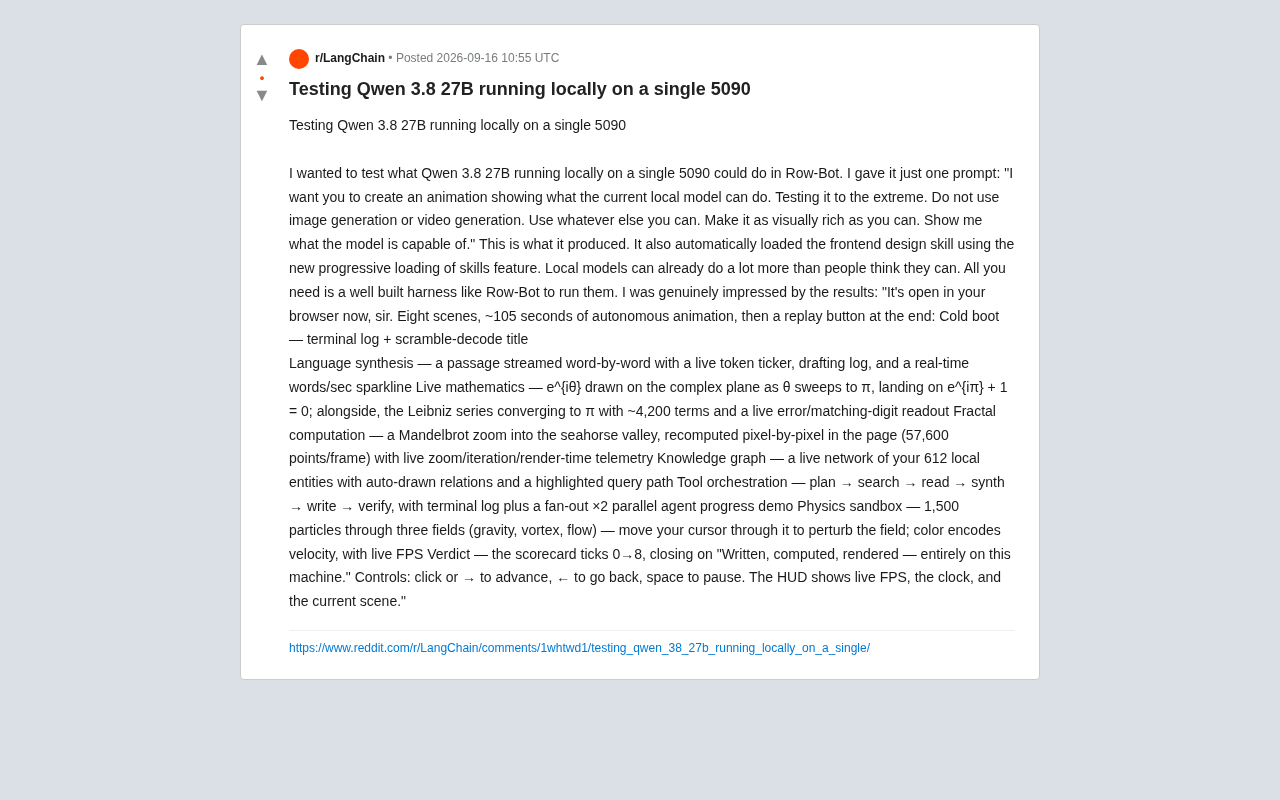
本地部署Qwen3 27B实测:单张5090能跑出什么效果?
开发者用单张RTX 5090本地运行Qwen3 27B模型,通过Row-Bot框架仅凭一条提示词生成了包含8个场景、105秒的交互式动画,涵盖实时数学、分形计算、物理沙盒等。实测揭示本地中型模型的真实能力与Agent框架的关键作用。
离谱的开源模型命名:从Qwen魔改版看社区乱象
一个离谱的开源模型名字Qwen3.8-27B-TURBO-Fable-Cold-Fusion在Reddit走红,本文拆解这串缝合怪命名,剖析开源微调模型命名失控的现象与背后的社区生态问题。

Qwen3-27B微调实录:让大模型说出真正的"人话"
开发者基于 Qwen3.8-27B 微调出 Humanlike-Chat 模型,用 12.5 万条真人对话数据训练 rank-256 LoRA,让大模型摆脱"AI助手腔"、说出更自然的人话。本文解析其训练细节、实际效果与能力权衡。
 产品体验
Qwen Code 2.0更新解析:规划模式与视觉智能实战体验
深度解析Qwen Code 2.0系列更新,涵盖规划模式的审批机制、视觉智能自动切换、Zed编辑器双重认证集成及Windows平台修复,帮助开发者了解这款CLI编码助手的核心改进与实际价值。
 教程攻略
oMLX+MTP+Qwen3.6:本地AI编程速度突破新极限
使用oMLX推理引擎结合MTP多令牌预测技术和Qwen3.6 35B模型,在Apple Silicon Mac上实现86.7 tokens/s的本地编程速度,5分钟内完成全栈应用开发的完整实战解析。
 产品体验
Qwen 3.6 vs Gemma 4:本地AI编程模型实战开发深度对比
通过Tauri框架开发Markdown编辑器,实测对比Qwen 3.6与Gemma 4两款本地大模型在规划能力、代码生成、开发效率等方面的表现差异,帮助开发者选择最适合的本地AI编程模型。
 教程攻略
Qwen+VS Code实战:用AI翻新站长交友平台全过程
博主利用VS Code和阿里云千问Qwen 3.6,将六年前闲置的站长商机人脉功能彻底翻新为交友合作平台。本文详解技术选型、提示词工程及AI翻新旧功能的实战经验与启示。
 产品体验
QwenCoder本地部署实测:能否替代付费AI编程助手?
实测QwenCoder 80B本地部署效果,对比Gemini、Claude等付费AI编程工具。详解硬件配置、LM Studio部署方案及实际编程能力测试结果,帮你判断本地模型能否省下AI订阅费。
 产品体验
DeepSeek V4 vs Qwen3.6实测:8大类150场景深度对比评测
使用BenchLocal工具对DeepSeek V4 Pro、V4 Flash与Qwen3.6 27B进行8大类85场景实测对比,涵盖工具调用、代码调试、推理数学等维度,V4 Pro总分领先6%但数学推理意外翻车,Qwen3.6 Q6在智能体场景媲美V4 Pro。
 产品体验
Qwen3.6-27B开源模型评测:27B参数实现旗舰级代码与多模态能力
阿里Qwen3.6-27B开源模型深度解析:270亿参数稠密架构,单卡即可部署,代码生成能力超越前代旗舰。本文详解其技术优势、基准测试成绩、硬件配置方案及实际部署建议,助你低成本获得旗舰级AI编程与多模态理解能力。
 产品体验
开源AI桌宠小猫:Qwen 3.5 Omni+ESP32打造全模态智能伙伴
基于Qwen 3.5 Omni全模态模型和ESP32-S3的开源AI桌宠小猫项目,支持情感语音交互、视觉感知、手势互动和一日记录复盘功能。附完整复刻教程,含硬件清单、3D打印模型和代码烧录指南。