本地大模型跑分类任务有多快?五款模型实测对比
同一邮件分类任务实测:本地模型热启动后最快,但冷启动与准确性仍是代价。
作者在搭载 GB10(DGX Spark 的 Dell 实现)的 Dell Pro Max 上,用同一邮件分类脚本对比了本地模型与云端 API 的端到端延迟。结果显示,Ollama 本地脚本首次运行需 5.5 秒,二次仅 1.2 秒,成为全场最快;Nimble 也从 6.1 秒降至 1.8 秒;云端方面 Gemini 约 3.4 秒、GPT 约 6.5 秒、Jeff 约 2 秒。冷启动的模型加载与显存初始化是首轮耗时的主要来源,而云端则受网络往返与 API 排队影响。作者强调本地模型最快但不一定最好,准确率应参考公开 benchmark,选型应按场景而非秒数,并注意测试硬件差异。
同一封邮件分类任务,跑在不同的决策模型上,速度能差出数倍。一位开发者在自己的 Dell Pro Max(搭载 GB10,即 DGX Spark 的 Dell 实现)上做了一组实测:用完全相同的邮件分类脚本,分别调用本地模型与云端 API,把重点放在延迟而不是准确率上。
测试设计:同一个任务,五种跑法
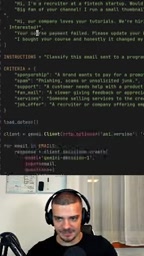
任务本身很朴素——一批邮件,加上一段分类指令,需要归入 sponsorship、spam、support、fan mail、services 或 job offer 这几类。作者坦言这是从自己的实际使用场景里提炼出来的。
参与对比的模型分两类。本地阵营是 Tef1 和 Nimble,跑在 Dell Pro Max 的 GB10 硬件上;云端阵营包括通过 TypeSafe API 调用的 GPT(即 OpenAI 的 decisions API)、Gemini,以及走 Ollama 的本地脚本。所有脚本做的事完全一样,只是调用的后端不同,因此差异基本可以归因于模型与调用链本身。
作者明确说,这次不比分数——分类准确率更适合看公开 benchmark,他要测的是端到端的耗时。
关于 DGX Spark 与 GB10
文中的 GB10 是 NVIDIA 推出的超级芯片,集成了 Grace CPU 与 Blackwell 架构 GPU,通过 NVLink-C2C 互连共享统一内存,整机功耗控制在桌面级水平。DGX Spark 是 NVIDIA 基于 GB10 打造的小型 AI 开发机,定位是让开发者在本地运行大语言模型和原型验证,而不必依赖数据中心 GPU。Dell Pro Max 则是 Dell 对同一平台的商用实现,硬件规格基本一致。GB10 的统一内存架构让模型权重可以直接驻留在 CPU/GPU 共享的显存池中,这是本地模型预热后延迟极低的关键;但其内存带宽和算力仍显著低于服务器级 GPU,因此首次加载大模型时的冷启动开销会比较明显。
实测数据:冷启动与热启动差距明显
计时方式很直接:用 time uv run 包住整个脚本,记录总耗时。
| 模型/后端 | 耗时 |
|---|---|
| Gemini | 约 3.4 秒 |
| GPT(decisions API) | 约 6.5 秒 |
| Jeff | 约 2 秒 |
| Ollama 脚本(首次) | 约 5.5 秒 |
| Ollama 脚本(二次) | 约 1.2 秒 |
| Nimble(首次) | 约 6.1 秒 |
| Nimble(二次) | 约 1.8 秒 |
这组数字最有意思的地方在本地模型的两次运行差异。Ollama 脚本第一次跑要 5.5 秒,第二次降到 1.2 秒,直接成为全场最快;Nimble 同样从 6.1 秒降到 1.8 秒。冷启动的开销(模型加载、显存初始化)把首轮成绩拉得很高,一旦预热完成,本地推理的优势就显现出来了。
云端这边,GPT 走 decisions API 用了 6.5 秒,Gemini 约 3.4 秒,Jeff 则只要 2 秒。网络往返和 API 排队都会计入总时长,这也是云端方案难以稳定压到本地热启动水平的原因。
冷启动与热启动
冷启动指模型进程尚未运行、权重未加载到显存时的首次调用,耗时包括从磁盘读取模型文件、初始化推理框架、分配显存以及编译或预热计算图等步骤。热启动则指模型已常驻内存,后续调用只需执行前向推理。两者差距在多 GB 级别的本地模型上尤为突出,因为权重加载往往占据首轮耗时的大头。文中 Ollama 脚本从 5.5 秒降到 1.2 秒、Nimble 从 6.1 秒降到 1.8 秒,正是这一机制的体现。工程上常通过常驻服务、预热请求或模型缓存来规避冷启动,这也是本地推理方案在实际部署时需要考虑的重要环节。
速度之外:本地模型的代价
作者在结尾给了一句很关键的判断:本地模型最快,但不一定是最好的。
这句话点出了延迟对比的局限。分类任务的真正成本是"快而错"——如果模型把一封客户支持邮件误判成垃圾邮件,省下的几秒钟毫无意义。云端模型在推理质量上通常更稳,尤其是在类别边界模糊、指令需要细致理解的情况下。本地小模型在预热后延迟极低,适合高频、低风险、类别清晰的批量处理场景。
另一个容易被忽略的变量是硬件。这次测试用的 GB10 属于桌面级的 AI 算力方案,普通笔记本或没有独立加速卡的机器上,本地模型的冷启动和热启动表现都会明显不同。换句话说,上面的秒数不能直接套用到自己的设备上,但"冷启动慢、热启动快"的规律大概率成立。
关于 Ollama 与 API 调用链
Ollama 是一个本地大模型运行与托管工具,封装了模型下载、量化格式加载、推理引擎(基于 llama.cpp)和本地 HTTP 服务,开发者可以用一条命令拉起模型并通过 API 调用。文中"走 Ollama 的本地脚本"指的是脚本通过 Ollama 的本地服务接口调用模型,因此其延迟包含进程间通信和本地 HTTP 往返,但省去了公网传输。相比之下,云端 API 的端到端耗时由网络往返、服务端排队、模型推理和响应流式返回共同构成,其中网络与服务端排队是不可控变量,这解释了为什么云端方案难以稳定压到本地热启动的水平。
怎么选:按场景而不是按秒数
如果你的分类任务是离线的、批量的、类别定义清晰,本地模型热启动后的低延迟很有吸引力,而且不用为每次调用付费、数据也不出本机。如果任务需要更强的语义判断,或者调用频率不高、对首字延迟不敏感,云端 API 的稳定性和质量更值得考虑。
还有一条折中路线:把本地模型常驻预热,避免反复冷启动。测试里 Ollama 第二次运行的 1.2 秒说明,只要模型已经在显存里,本地推理完全可以快过任何云端调用。反过来,如果脚本是偶尔跑一次的批处理,那第一次的 5.5 秒才是你实际会遇到的数字。
这类对比的价值不在于给出一个"最快模型"的结论,而在于提醒:评估推理速度时,冷启动、预热状态、网络链路这些工程细节,对最终体验的影响可能比模型本身的参数规模更大。
相关推荐
哈佛AI安全课程CS 2881R引热议
哈佛大学CS 2881R AI Safety课程在Hacker News被提及,本文介绍课程背景、AI安全的核心议题及对学习者的启示,帮助理解顶尖高校如何培养AI安全人才。

拓展社交圈:值得尝试的几款交友应用
交友应用怎么选?本文梳理朋友发现平台BFF与活动导向应用Timeleft等不同定位的友谊类应用,分析两类思路的适用人群,并给出线下见面安全与预期管理的实用建议。
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。