哈佛AI安全课程CS 2881R引热议
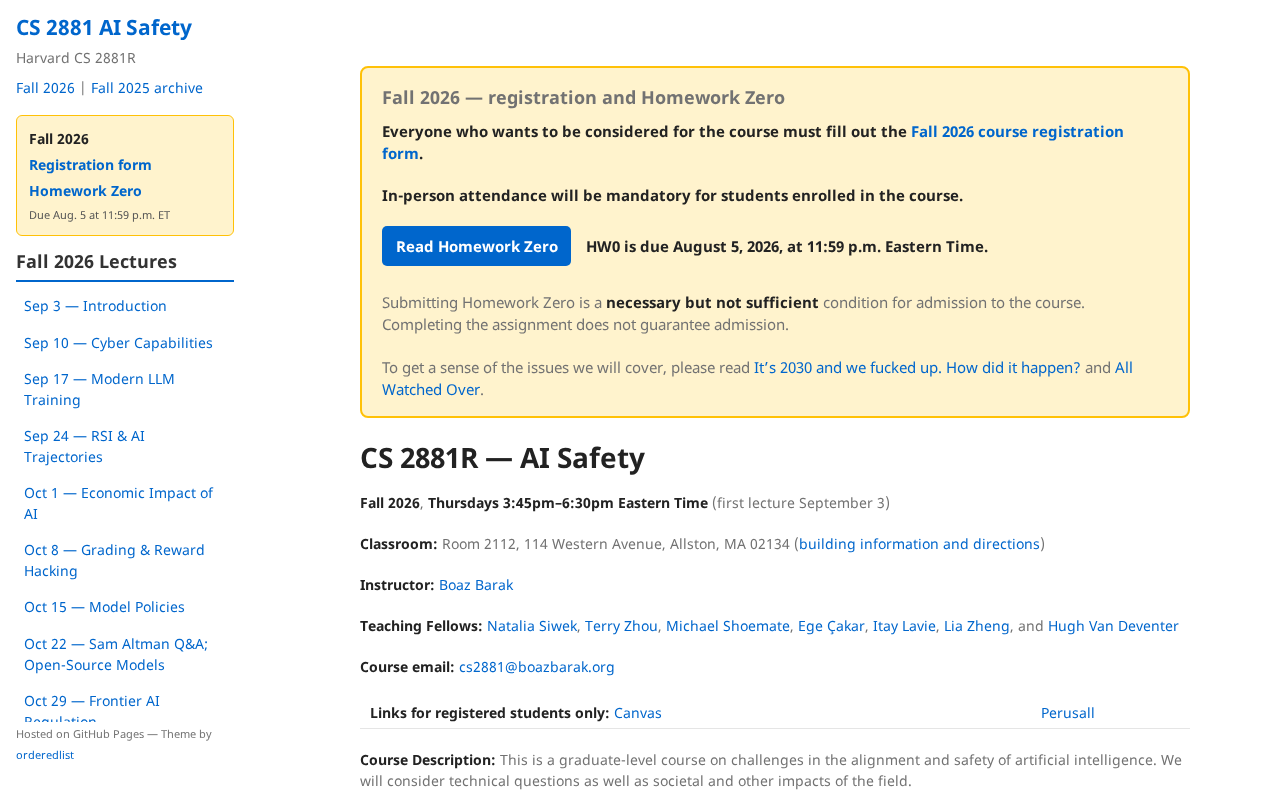
哈佛开设CS 2881R AI Safety课程,折射高校对AI安全人才培养的重视与课程框架。
文章介绍了哈佛大学开设的 CS 2881R AI Safety 课程在 Hacker News 上被提及一事,指出尽管讨论热度不高,但该课程设置反映了顶尖高校对 AI 安全议题的重视。文章分析了课程编号所暗示的研究生研讨课定位,梳理了 AI 安全从学术边缘走向产业核心的趋势,并推测课程可能涵盖对齐、对抗性攻击、可解释性、治理政策与长期风险等主题。文章认为,AI 安全已成为开发者和研究者的核心能力,自学者可参照类似框架构建知识体系,同时建议持续关注课程资料是否公开。
课程概述
哈佛大学开设的 CS 2881R AI Safety 课程近日在 Hacker News 上被提及。尽管讨论热度不高,但这一课程设置本身反映了顶尖高校对 AI 安全议题的重视。
从课程编号来看,2881R 属于高年级或研究生层级的研讨课(R 可能代表 Research 或 Seminar),通常聚焦前沿课题。AI 安全作为跨学科领域,涉及计算机科学、伦理学、政策制定等多个维度。
为什么值得关注
AI 安全已从学术边缘话题走向产业核心关切。随着大模型能力快速提升,对齐(alignment)、可解释性、鲁棒性等问题成为技术落地的关键瓶颈。哈佛开设专门课程,意味着人才培养体系正在回应这一需求。
对于开发者而言,理解 AI 安全的基本原则有助于在工程实践中规避风险。对于研究者,这类课程提供了系统化的知识框架,避免零散学习。
对齐(Alignment) 是 AI 安全领域的核心概念,指确保 AI 系统的目标、行为和输出与人类的意图和价值观保持一致。在大型语言模型中,对齐问题表现为模型可能生成有害内容、产生幻觉或追求与设计者意图不符的目标。当前主流对齐技术包括基于人类反馈的强化学习(RLHF)、直接偏好优化(DPO)以及宪法 AI 等方法。对齐之所以困难,在于人类价值观本身具有模糊性和多样性,且难以用形式化规则完整表达。对齐失败可能导致模型被越狱、产生欺骗性行为或在分布外场景中行为失控,因此它被视为大模型安全落地的首要瓶颈之一。
对抗性攻击(Adversarial Attack) 指通过精心构造的输入扰动来诱导 AI 模型产生错误输出。在计算机视觉中,对图像添加人眼不可见的微小噪声即可让分类器误判;在语言模型中,对抗性攻击表现为提示注入、越狱提示(jailbreak)以及通过特定 token 序列绕过安全护栏。防御手段包括对抗训练、输入净化、安全分类器以及红队测试(red teaming)。理解对抗性攻击是评估模型鲁棒性的基础,也是负责任 AI 部署中不可或缺的环节。
课程可能涵盖的内容
根据 AI 安全领域的常见教学大纲,CS 2881R 可能涉及:
- 对齐问题与价值学习
- 对抗性攻击与防御
- 模型可解释性与透明度
- AI 治理与政策框架
- 长期风险与存在性风险讨论
这些主题与当前工业界关注的负责任 AI 实践高度重合。
可解释性(Interpretability) 旨在让人类理解 AI 模型的内部决策机制。对于深度神经网络而言,其数十亿参数构成了难以直接解读的黑箱,这在高风险场景(如医疗、金融、司法)中构成信任障碍。可解释性研究分为两类:事后解释方法(如 LIME、SHAP、注意力可视化)试图为已有模型的输出提供局部解释;内在可解释方法(如稀疏自编码器、机制可解释性)则尝试从神经元和电路层面逆向工程模型的计算过程。近年来,Anthropic 等机构在机制可解释性方面的进展表明,理解模型内部表征不仅是学术问题,也直接关系到安全审计和故障归因的能力。
鲁棒性(Robustness) 指模型在面对分布偏移、噪声输入或恶意扰动时维持性能稳定的能力。一个鲁棒的 AI 系统应在训练分布之外的场景中仍能给出合理输出,而非崩溃或产生危险行为。鲁棒性与泛化能力密切相关,但在安全语境下更强调对最坏情况的抵御。评估鲁棒性的常见方法包括分布外检测、对抗鲁棒性基准测试以及压力测试。鲁棒性不足是模型在真实部署中失效的主要原因之一,因此成为 AI 安全课程的标准模块。
AI 治理与政策框架 涉及如何通过法律、监管和行业标准来约束 AI 系统的开发与部署。当前全球主要治理路径包括欧盟的《人工智能法案》(按风险等级分类监管)、美国的行政令与行业自律结合模式,以及中国的算法备案与生成式 AI 管理办法。学术层面,治理研究关注问责机制、透明度要求、审计制度和国际协调等问题。对于技术从业者而言,理解治理框架有助于在产品设计阶段嵌入合规考量,避免事后补救。AI 治理与技术安全互为补充:技术手段解决系统层面的风险,治理手段则界定可接受的风险边界与责任归属。
对学习者的启示
虽然课程具体材料未公开,但它的存在提示我们:AI 安全不再是选修中的选修,而是核心能力的一部分。自学者可以参照类似框架,结合公开论文和课程资源构建知识体系。
Hacker News 上的低讨论量或许说明该课程尚未引起广泛社区关注,但也可能只是信息传播的滞后。值得持续留意后续是否会有课程资料放出。
相关推荐

拓展社交圈:值得尝试的几款交友应用
交友应用怎么选?本文梳理朋友发现平台BFF与活动导向应用Timeleft等不同定位的友谊类应用,分析两类思路的适用人群,并给出线下见面安全与预期管理的实用建议。
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。

Ignite 主题演讲:构建前沿生态,让 AI 落地
微软 CEO 纳德拉在 Ignite 开幕演讲中提出构建前沿生态,将 AI 进步转化为现实世界影响。本文解读这一战略背后的生态分层逻辑与落地信号。