本地大模型跑分骗局:你需要的四个真实指标

本地LLM跑分几乎都与你无关,唯有四个指标加两个时钟自测才可信。
一位博主搭建了自己的LLM测试框架并指向真实设备集群,得出结论:流行的tokens-per-second单一指标极具误导性,应拆分为首token时间、生成速度、提示读取速率和上下文填充四个数字。文章详细拆解了实测中遭遇的五个陷阱:网关路由到意外主机、后台负载污染测量、冷加载必须预热丢弃、客户端与服务端时间相差高达600秒、以及中途模型重载导致数据断层。核心守则是:每行记录服务主机和两个时钟,按主机单独设超时,修改提示词首行以破掉Ollama前缀缓存,并将测量结果直接驱动路由决策——慢机跑夜间批处理,快机留给实时交互。
为什么你看到的本地LLM跑分几乎都没用
一位国外博主自建了一套LLM测试框架,把它指向自己的真实设备集群后,得出了一个尖锐的结论:你见过的几乎所有本地大模型跑分都是"真的",但几乎都与你无关。
道理并不复杂。一张旗舰显卡在调优服务器上跑出的tokens-per-second图表,对你衣柜里那台显卡毫无参考价值——尤其当你用的是Ollama默认配置、跑着自己的量化版本时。真正值得信任的数字,只有你自己用同一种方式、每次都一致地测出来的那些。
博主干脆照着指南把测试框架搭了出来,指向自己的机器集群实测,结果指南里警告过的几乎每个陷阱都原封不动地撞上了。这篇文章正是把这些坑逐一拆解。
规则一:单看tokens-per-second会掩盖问题
只盯着一个"每秒多少token"的数字,等于把问题藏了起来。博主主张:每个模型、每台主机、每次运行,都要记录四个数字。
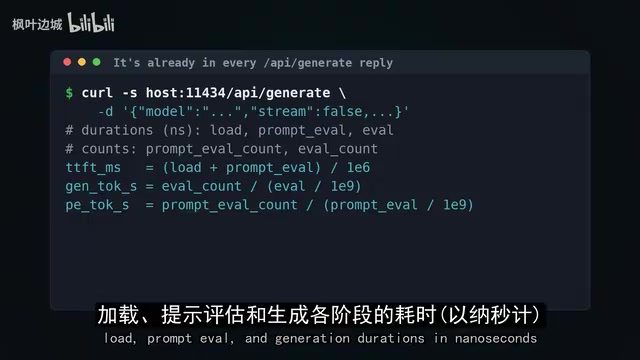
- 首token时间(Time-to-first-token):从发出请求到出现第一个字之前要等多久。这主要是模型"读"你提示词的时间,如果模型没预加载,还要加上加载时间。
- 生成速度(Generation speed):模型开始写之后的稳定吐字速率。
- 提示读取速率(Prompt-eval rate):模型读取输入的速度——这和它写输出的速度是完全不同的两个数字。
- 上下文填充(Context fill):在一系列不同长度提示词下测量的首token时间,因为有的配置是平缓劣化,有的则会"跌落悬崖"。
为什么这几个数必须分开看
读提示词可以批量并行处理,但写输出只能一个token一个token地来。所以一台机器完全可能快速读完一份长文档,却写得极慢,反之亦然。
更关键的是,单一上下文长度不足以说明问题。一个模型在2000 token时表现良好,到8000 token时可能彻底无法使用——一旦KV缓存溢出显卡容量,性能会急转直下。
好消息是,Ollama其实已经把这些都测好了。每一次非流式的generate调用都会以纳秒为单位返回load、prompt-eval、generation三段耗时以及token数量。首token时间 = load + prompt-eval duration,每个速率就是token数除以对应耗时。测试框架要做的,只是每次跑同样的扫描并一致地做算术。
KV缓存(Key-Value Cache)是理解"上下文悬崖"现象的关键。Transformer架构在生成每个新token时,需要访问此前所有token的注意力键值对。为避免重复计算,这些键值对会被缓存在显存中——这就是KV缓存。它的大小随上下文长度线性增长:以一个70亿参数模型为例,8000 token的KV缓存可能占用数GB显存。当缓存超出GPU显存容量时,系统会被迫将其换出到内存甚至磁盘,带宽从数百GB/s骤降至数十GB/s,生成速度随之崩塌。这也解释了为何性能不是平缓下降而是"跌落悬崖":显存是硬边界,一旦越过,惩罚是阶跃式的。不同量化版本(如Q4_K_M vs Q8_0)的KV缓存大小差异显著,这正是"锁定精确量化标签"如此重要的原因之一。
单机一条curl就够,集群需要真正的框架
测一台机器,一条curl命令足矣;但面对整个集群,就需要一套设计严谨的框架。博主给出的设计原则值得每个自建AI的人抄作业:
- 主机并行跑,因为每台机器只是在等自己的GPU;
- 同一主机内的模型和上下文长度串行跑,因为一张卡上同时跑两个模型会把两边的测量都污染掉;
- 先发一个预热调用并丢弃其结果;
- 每行记录错误,这样一台宕机的主机不会拖垮整轮测试;
- 锁定并记录精确的量化标签;
- 所有数据写入固定schema的同一个CSV,这样本月的结果能和上月对齐。
构造提示词的隐藏陷阱
提示词本身也要小心。要用真实文本,并记录模型报告的真实token数,而不是你以为的那个——博主目标8000 token,实际是8575。
更隐蔽的是:每次运行要修改第一行。Ollama会复用缓存的提示词前缀,如果第二次运行的开头和第一次完全一样,它会跳过大部分读取,跑出快得离谱的假数据。把运行编号放在开头而不是结尾,就能破掉这个缓存。
Ollama的提示词前缀缓存机制本质上是一种KV缓存复用优化:如果新请求的提示词开头与上一次请求完全相同,Ollama会跳过对这段前缀的重新计算,直接复用已有的KV缓存条目。这在实际使用中是有益的性能优化(例如多轮对话中系统提示词保持不变),但在基准测试场景下会严重干扰数据。将运行编号放在提示词开头而非结尾,能确保每次请求的前缀都不同,强制模型从头完整处理输入。这个细节容易被忽视:许多自制测试脚本会在末尾追加变量,前缀缓存因此得以命中,prompt-eval耗时接近于零,跑出的"读取速率"可能虚高数倍。
实测集群:五个把人打醒的发现
博主的架构是一个Ollama网关挡在几台机器前面,根据模型名称决定由哪台主机服务。他扫描了一个30亿和一个70亿参数的模型,提示词长度约为600、2000和8500 token,各跑两次、丢弃预热,分别在两个Ollama版本上运行,并在每次预热后询问网关究竟是哪台机器加载了模型。
第一个意外:网关把两个模型都丢到了一台2015年的四核笔记本CPU上,显存占用为零。没有任何东西坏掉,这只是路由决定的落点。如果你的框架不记录运行发生在哪里,你根本不知道自己测的是什么。
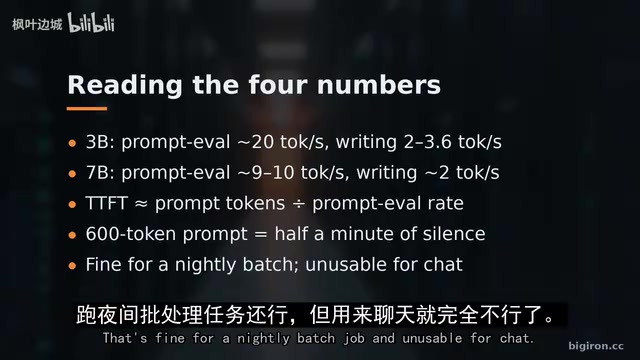
跑出来的数字一看就是CPU的样子:30亿模型在600 token提示下约29秒才出第一个字,2000 token时要95秒;70亿模型在600 token下首token就超过一分钟。四个数字立刻解释了原因——30亿模型读取约20 token/秒、写入2到3.5,70亿模型读取仅9到10、写入约2。在这种读取速率下,600 token意味着第一个字出现前要沉默半分钟。这对夜间批处理完全OK,对聊天则完全不可用——而单一的tokens-per-second数字永远告诉不了你是哪种情况。
第二个意外:同样的600 token提示连续跑两次,生成速度从3.6跌到2.0 token/秒。原因是这台笔记本同时还在给笔记系统的embedding模型服务——机器上任何别的负载都会悄悄污染测量。
第三个:第一次调用(仅仅是"say hi")首token耗时10.2秒,其中7.5秒是加载模型。这正是预热调用存在、且必须丢弃的理由。
第四个,也是没有两个时钟就绝对抓不到的:在一次8000 token运行中,Ollama报告耗时125秒,而客户端等了725秒——整整10分钟花在网关排队上,对所有服务端数字完全不可见。
第五个,至今无法完全解释:8000 token跑到一半,模型重载了一次,花了31秒;此后prompt-eval速率从约22跳到约155 token/秒,而写入仍停在2.5左右。由于博主只在预热后记录了一次服务主机、没有逐行记录,所以无法证明到底变了什么。修复很便宜:每一行都记录服务主机和显存大小。
量化(Quantization)是理解本文测试设计的基础背景。大语言模型的原始权重通常以float16或bfloat16格式存储,70亿参数模型约需14GB显存。量化通过降低权重精度来压缩模型体积:Q4格式将每个参数压缩至约4位,同等模型仅需约4GB显存,代价是精度损失和潜在的质量下降。Ollama使用llama.cpp的量化实现,常见标签如Q4_K_M、Q5_K_S、Q8_0中,数字代表位宽,K表示使用了k-quants分组量化方案,M/S/L表示组内精度等级。不同量化格式不仅影响显存占用,还会影响CPU/GPU的计算效率和KV缓存大小,因此相同模型的不同量化版本在性能上可能差异显著,跑分时必须精确记录量化标签才有复现价值。
如何读懂一次运行,以及要防什么
先想清楚你在问哪个问题。直接对每台主机测,得到的是硬件本身的数字;透过网关测,得到的是用户真实体验,包含排队和路由。两者都有效,但是不同的测量。把它们混进同一张表,一个慢路由器会看起来像一块慢GPU。
常见的诊断模式:
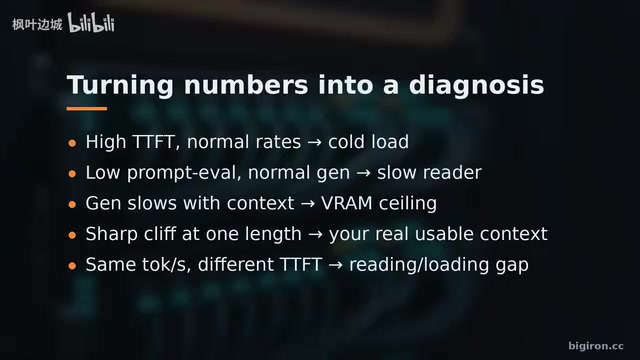
- 首token时间高、速率正常 → 冷加载漏过了预热,查一下
ollama ps; - prompt-eval低、写入正常 → 计算瓶颈型读取,典型见于CPU和核显主机,没有配置能修;
- 写入随上下文增长变慢 → 你在蹭显存天花板;某个长度出现陡降就是硬上限,记下来,那才是你真正可用的上下文;
- tokens-per-second相近但首token差很多 → 差距在读取或加载上,这对聊天最要命。
有一条守则值得单独强调:博主的70亿模型在CPU主机上每次要跑近两分钟,一个为GPU调好的全局超时会把慢主机误判成死主机。按主机单独设置超时。
此外还要留意:长扫描最后几行的热降频;这套测试一次只测一个请求,并发负载是另一回事;信任某一行之前检查GPU上有没有别的进程;以及在每次调用上都比较客户端时间与服务端时间。
保留历史,让数字真正干活
每次驱动更新、Ollama升级或加入新主机后,重跑同一套扫描,并保留每一个CSV。更新后的性能回退,如果没有"更新前"的数字作对照就是隐形的。
博主还呼吁:发布你的数字时,附上精确的硬件、Ollama版本和量化标签。一个来自某人衣柜里GPU的诚实数据行,对下一个买家的价值,远胜任何厂商的宣传幻灯片。
最后把数字用起来。那台CPU笔记本用来聊天毫无价值,但用来跑没人等着看的夜间摘要完全够用。于是按测量结果路由:把批处理任务发给又慢又便宜的机器,交互流量留给快的;并把每台主机的"上下文悬崖"写进路由器配置,而不是迷信模型标称的最大值。
归根结底就是:四个数字、一个丢弃的预热、每一行都记录服务主机和两个时钟,然后只信任你自己测出来的东西。 完整指南与Python测试框架放在 bigiron.cc。
热降频(Thermal Throttling)是长时间压测中容易被忽视的干扰因素。GPU和CPU都有设计温度上限,当芯片持续满载导致温度逼近阈值时,硬件会自动降低工作频率以控制发热,这一机制称为热降频。在本文的测试场景中,一次8000 token的扫描可能持续数分钟,最初几次测量在芯片温度较低时完成,后续测量则在降频状态下运行,导致同一轮扫描内数据前后不一致。博主建议重点检查"长扫描最后几行"正是出于这个原因。对于散热条件较差的小型主机(如NUC、迷你PC)或衣柜部署的消费级显卡,这一问题尤为突出。记录每次调用的时间戳有助于事后排查:如果速率在扫描后半段系统性下滑,热降频是首要嫌疑。
相关推荐

AI开发应用的7个关键步骤:避免推倒重建的实战方法
用AI构建应用速度惊人,但也容易挖坑。本文梳理从核心原型、结构化提示词、身份验证到数据结构规划、安全扫描、真实数据测试和规模化设计的7个关键步骤,帮你避免推倒重建,构建可靠的AI应用。

用 Claude AI 构建银行 KYC 文档管理模块实战
一位开发者使用 Claude AI 将银行贷款应用的 KYC 文档管理模块从模拟数据改造为真实数据库后端,涵盖两段式 Prompt 策略、文件落地与完整文档审核闭环实测,为 AI 辅助企业级开发提供参考。
为什么越来越多开发者开始反感 AI 编程?
AI 编程助手虽提升效率,但也引发开发者担忧。本文梳理反感 AI 编程的核心理由:隐性调试成本、技能侵蚀、代码质量疑问与创作乐趣流失,并探讨如何理性使用这类工具。