本地大模型写一周代码实测:能否替代云端Claude
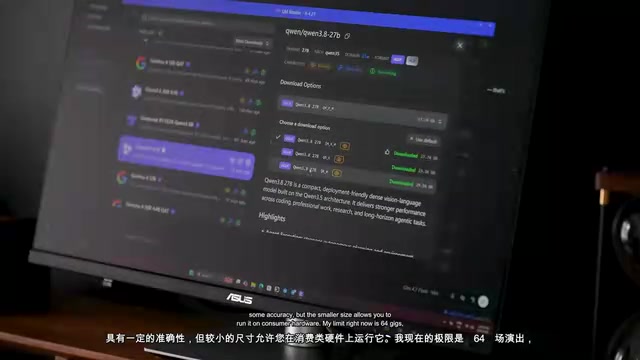
64GB迷你主机实测:本地模型适合当代理手脚,撑不起主力开发。
作者用一台64GB内存的华硕NUC迷你主机,通过Ollama和LM Studio加载Qwen 3.8(27B)、Muse Glimmer和GLM 4.7 Flash,进行了一周本地模型实测。速度上GLM 4.7 Flash约22 tokens/秒最快,Qwen约12,Muse Glimmer仅约6且思考冗余;64GB内存还允许并行跑两个GLM实例。接入VS Code可行,但8000 token默认上下文成为最大硬伤,迫使其严格切分会话。接入Claude Code等CLI框架时,一句hello world需三分钟,说明重型框架的提示词体量超出小模型承载能力。结论是本地模型适合常驻代理的子任务执行与记忆维护,不适合数千行级代码库开发;云端统筹加本地执行的混合架构是当下最务实的方案。
当开源本地模型的跑分越来越接近顶级云端模型,一个现实问题浮出水面:它能替我们干活了吗?一位开发者用一台消费级迷你主机做了一周实测,把本地模型塞进IDE、CLI和AI代理,记录下它们真正能用的边界。
测试平台:64GB内存的消费级迷你主机
实验用机是华硕NUC 16 Pro迷你主机,搭载Intel Ultra Core X7处理器(16个逻辑核心)与64GB内存。软件层面使用Ollama和LM Studio来加载本地模型。
选型时参考了arena.ai的编程与通用能力榜单,但真正落地的约束是内存:榜单上更强的模型动辄需要数百GB内存,远超64GB的消费级上限。最终入选的是Qwen 3.8的270亿参数版本、Meta的Muse Glimmer,以及在硬件上能稳定容纳的GLM 4.7 Flash。OpenAI的1200亿参数开源模型则因内存不足被直接排除——作者事后感慨,也许该直接上96GB。
模型下载环节需要通宵完成,量化等级(Q8/Q6/Q4)决定了精度损失与体积的取舍,而是否支持GPU卸载直接决定推理速度是否可接受。
Ollama 与 LM Studio 是当前最主流的两个本地大模型运行工具,定位略有不同。Ollama 以命令行和 API 为中心,内置模型仓库、一条命令即可拉取并运行模型,适合脚本化调用和接入各类开发工具;LM Studio 提供图形界面,更强调模型浏览、参数调节和本地 API 服务的可视化配置,并附带与 OpenAI 兼容的接口,方便被 VS Code 插件或第三方客户端指向。两者底层都依赖 GGUF 等量化格式与 llama.cpp 推理后端,也都支持把部分或全部模型层卸载到 GPU 以加速。文中 VS Code 原生"管理语言模型"功能正是通过自定义端点指向 LM Studio 的本地服务来实现的。
量化等级(Q8/Q6/Q4) 指的是模型权重在存储和计算时所用的数值精度。Q8 表示权重以约 8 比特表示,Q4 则压缩到约 4 比特。位数越低,模型体积和内存占用越小、推理通常也越快,但精度损失越大,表现为回答质量、推理严谨性或长程一致性下降。对消费级硬件而言,量化是让大参数模型塞进有限内存的关键手段:同一个 270 亿参数模型在 Q8 下可能需要三十 GB 以上内存,Q4 则可能压缩到十几 GB。这也解释了文中为何要先通宵下载、再在精度与体积之间做取舍。
速度实测:6到22 tokens/秒的差距
第二天测试三个模型的推理速度,差异相当悬殊:
- Qwen 3.8(27B):约12 tokens/秒
- Muse Glimmer:约6 tokens/秒,且思考过程大量消耗在"确保遵守准则、不越界"上,回一句hello world也要绕很久
- GLM 4.7 Flash:约22 tokens/秒,可完整装入GPU,是三者中最快的
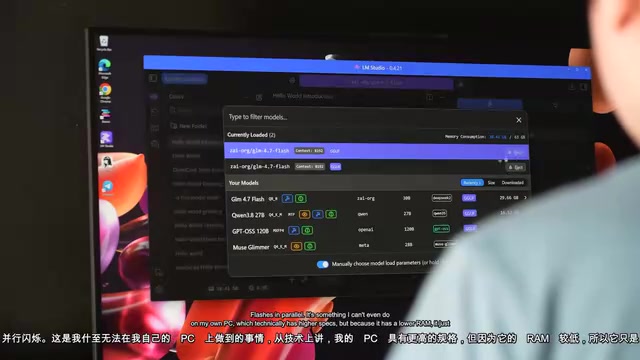
64GB内存还带来一个意外优势:可以并行跑两个GLM 4.7 Flash实例,而作者自己规格更高但内存更小的PC反而做不到。
在VS Code里跑通,但上下文是硬伤
把本地模型接入VS Code有两条路:Continue、LM Studio的Copilot扩展等第三方插件,或VS Code原生的"管理语言模型"功能——通过自定义端点指向LM Studio,无需登录任何云端账号即可在聊天窗口看到本地模型。
初次对话失败的原因很典型:VS Code发出的工具调用占满了上下文窗口,留给对话本身的空间所剩无几。解决办法是取消勾选全部工具调用,并扩大模型的上下文长度。
真正的瓶颈在第三天浮现。云端模型动辄宣称百万级token上下文,而本地模型默认只有8000,这个差距直接改变使用方式:必须严格切分会话,稍跑久一点就会耗尽上下文;强行调大上下文又会拖慢生成速度,得不偿失。作者的原话是,8000 token的限制"显著影响了你使用它们的方式"。
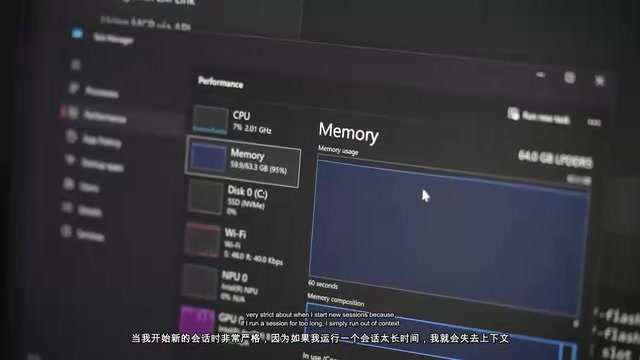
上下文窗口(context window) 是模型单次推理能"看到"的 token 总量上限,包含系统提示、工具定义、历史对话、粘贴的代码和模型自己的输出。它是一块固定容量的工作记忆,超出部分要么被截断,要么需要开发者手动裁剪和摘要。云端模型宣称的百万级 token 上下文,意味着可以把整个中型代码库一次性交给模型;而 8000 token 大约只相当于几千个汉字或一两百行代码,加上系统提示和工具 schema 后所剩无几。这就是文中"工具调用占满上下文"和"必须严格切分会话"的直接原因。强行调大上下文还会带来两个代价:注意力计算随长度增长而变慢,以及长上下文中模型对中段信息的召回质量下降。
CLI与AI代理:小模型扛不住重型框架
把本地模型接进Claude Code这类主流CLI,只需指定模型并指向LM Studio的地址。但一句hello world跑了三分钟才返回——框架塞给模型的提示词体量,远超小模型的承载能力。作者由此判断:现阶段的CLI/harness对本地模型效率极低。
AI代理场景则出现了分化。OpenCore接上Qwen 3.8后,回一句hello world同样要两三分钟,作为主代理不可用;但把它降级为执行定时任务(cron job)的子代理就合理得多——这类任务只查日志、看邮件,对延迟不敏感,token消耗也低。作者最终用Kimi K3作为主代理统筹,本地模型跑后台子任务。
Hermes的价值在另一个方向:它可以用本地模型重写自身记忆、完成自我升级。
经过调优,轻量模型(如LMF 2.5)在这台机器上能跑到100 tokens/秒以上,实时输出相当流畅。作者还让云端模型(ChatGPT 6 Astra、Claude)远程控制这台PC做2D转3D建模和项目开发,形成"AI专用工作站+个人主机"的双机分工——出门喝咖啡时用手机查看进度、追加任务。
CLI 与 agent harness(代理框架) 指的是 Claude Code、OpenCode 这类把大模型包装成可自主执行任务的命令行工具。它们并非简单地把用户输入转发给模型,而是在每一轮都注入大量内容:系统行为准则、可用工具及其参数说明、文件系统与环境状态、历史操作记录、规划与反思提示等。这套 harness 的设计前提是模型拥有足够大的上下文和足够强的指令遵循能力,因此单次请求的提示词动辄数千甚至上万 token。把它接到 8000 token 上下文、每秒十几 token 的小模型上,就会出现提示词本身几乎占满窗口、生成速度又慢的局面,一句 hello world 耗时数分钟正是这种结构性错配的体现。
主代理与子代理(main agent / sub-agent) 是一种分层代理架构:主代理负责理解用户意图、拆解任务并分派,子代理则执行边界清晰的窄任务,如查日志、读邮件、定时巡检。子代理的输入输出都很短、对延迟不敏感、失败可重试,因此特别适合用小而慢的本地模型承担;主代理需要长上下文与强推理,交给云端模型更划算。文中的 cron job 即定时任务,由系统按计划周期性触发,天然契合本地模型常驻低负载的运行方式。
结论:本地模型的位置已经清晰
一周实测给出的答案并非简单的"能"或"不能":
现在就能用的场景:7×24小时常驻的小型代理(如OpenCore)、代理的子任务执行、记忆维护与自我改进。小体积主机长期低负载运行,恰好是本地模型的舒适区。
暂时别指望的场景:动辄数千上万行的代码库开发。上下文窗口、推理速度与框架开销三重限制叠加,本地模型还撑不起主力开发工作。
作者对趋势的判断是乐观的:模型规模在涨,量化质量在提升,未来手机、笔记本和家用电脑都可能分到大块内存给本地AI。但就当下而言,混合架构——云端模型做大脑、本地模型做手脚——才是务实的落地方式。
相关推荐

Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。