本地大模型运行器怎么选?五大工具横评指南
五款本地大模型运行工具的定位与选型指南,核心是搞清谁是引擎、谁是外壳、谁压根不是为你造的。
本文梳理了本地运行大模型最常见的五个工具:llama.cpp、Ollama、LM Studio、vLLM 和 Lemonade Server。其中 llama.cpp 是底层 C++ 引擎,Ollama 和 LM Studio 都是对它的封装——前者以命令行极简见长并暴露本地 API 接口,后者提供完整图形界面并能标注模型与硬件的适配情况。vLLM 源自伯克利,依赖 Linux 和数据中心显卡,凭借 PagedAttention 技术专为多用户并发设计,个人用户无需考虑。Lemonade Server 是 AMD 推出的方案,能自动在 CPU、集显和锐龙 AI NPU 之间选择最优芯片,填补了轻薄本用户的空缺。选型建议:先用 LM Studio 探清硬件上限,需要接入开发流程则换 Ollama,锐龙 AI 笔记本用 Lemonade 更能榨干性能。
在自己的电脑上跑大模型,绕不开五个反复出现的名字:llama.cpp、Ollama、LM Studio、vLLM 和 Lemonade Server。表面看它们都是「本地运行器」,但实际关系很微妙——其中四个共用同一个引擎,还有一个根本不是为个人用户设计的。搞清楚它们的分工,才能少走弯路。
先理解三个基础概念
在挑工具之前,有三个词必须先搞明白,否则后面所有选择都是盲选。
模型就是一个文件。它通常以 GGUF 格式存在,大小在 4GB 到 30GB 之间。你从各处下载的那些体积巨大的文件,本质上就是模型本身。
量化是压缩手段。它能把一个原本需要 40GB 显存才能装下的模型,压到 12GB 左右就能跑,而质量只损失一点点。这是让消费级硬件跑得动大模型的关键技术。
显存是硬性上限。如果模型文件能完整装进显卡显存,回答就快;一旦装不下,溢出的部分会退回系统内存处理,速度会断崖式下跌,慢到让人无法忍受。理解这一点,就能明白为什么「模型能不能跑」和「跑得快不快」是两码事。
GGUF 是 llama.cpp 项目在 2023 年推出的模型存储格式,全称 GPT-Generated Unified Format,用于取代此前的 GGML 格式。它把模型权重、分词器词表、超参数等所有必要信息打包进单个二进制文件,让模型做到「下载即用」,无需额外配置。量化的本质是降低每个参数的数值精度:原始训练模型通常用 32 位或 16 位浮点数存储权重,Q4 量化将其压缩到约 4 位,体积缩减约 75%。常见的量化级别从 Q2 到 Q8 不等,数字越大精度越高、文件越大。社区普遍认为 Q4_K_M 是质量与体积的最佳平衡点——对大多数应用来说,和原始模型的输出差异几乎察觉不到。
llama.cpp:藏在底层的真正引擎
llama.cpp 是一个 C++ 程序,它才是真正干活的引擎——读取模型文件并完成计算,可以跑在处理器、显卡,或者两者协同之上。它跨平台支持 Windows、Mac 和 Linux。
关键在于,市面上几乎所有好用的本地运行应用,底层调用的都是它。你一直在下载的那些 GGUF 文件,正是 llama.cpp 定义的格式。换句话说,后面要讲的 Ollama、LM Studio 本质都是它的「外壳」。直接用 llama.cpp 灵活性最高,但门槛也最高,适合愿意折腾命令行和参数的用户。
Ollama:一条命令搞定的极简派
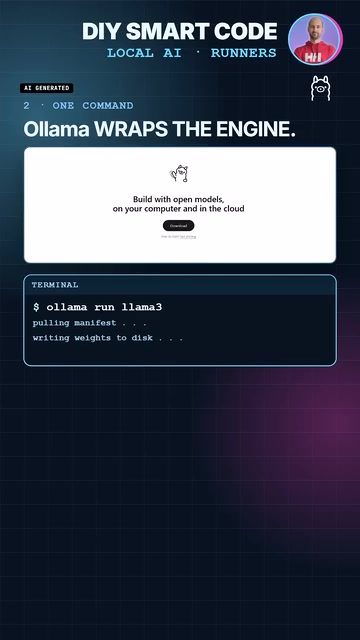
Ollama 就是把 llama.cpp 这个引擎封装成一条命令。你只需输入 ollama run 加上模型名,它会自动下载文件、加载模型,然后直接进入聊天界面。
更实用的是,它会在本地 11434 端口留下一个服务器接口,你的代码编辑器、自动化脚本都能直接调用。代价是控制权——除非你愿意深入挖掘配置,否则基本只能用默认设置。对于想快速接入脚本和开发流程的人来说,Ollama 是最省心的选择。
LM Studio:给新手的可视化桌面应用
LM Studio 用的还是同一个引擎,只是外面套了一个完整的桌面图形应用。你可以在应用内直接浏览模型库,而且它会贴心地标注哪些模型适合你当前的机器配置——不至于下载完 12GB 才发现根本跑不动。
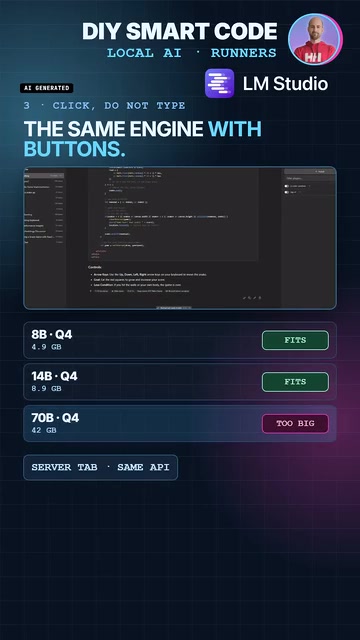
它的服务器选项卡使用与 Ollama 完全相同的 API,控制台还会实时显示每秒生成的 Token 数量,方便你评估性能。LM Studio 在家庭和办公场景下都能免费使用,但它是闭源的,这一点和其他几个开源工具不同。
vLLM 与 Lemonade:面向特定场景的专用工具
vLLM 源自伯克利,根本不是给个人电脑设计的。它需要 Linux 系统和数据中心级显卡,核心能力是同时服务多个用户。它的招牌技术是分页注意力(PagedAttention),能把大量并发对话高效塞进同一块显存里,而不是给每个对话单独分配空间。如果你只是单台笔记本一个人用,它完全派不上用场——这也是文中所说「有一个根本不是为你设计的」。
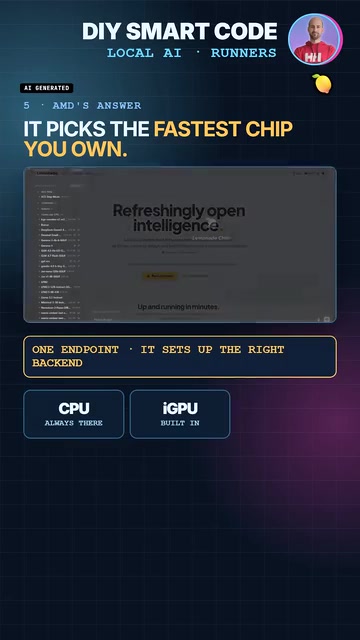
Lemonade Server 是 AMD 的解决方案,外形和 Ollama 类似,但它会自动把任务分配到最高效的芯片上——在处理器、内置显卡或锐龙 AI 的 NPU 之间挑性能最强的那块运行。这恰恰照顾到了那些被大多数工具忽略的轻薄本用户。它开源、支持相同的 API,还能在 NVIDIA 和英特尔的芯片上运行。
PagedAttention(分页注意力)是 vLLM 的核心创新,借鉴了操作系统虚拟内存的分页管理思路。传统推理框架在处理每个请求时,会为其整个上下文窗口预先分配一段连续显存,但实际用到的往往远少于预留空间,造成大量内存碎片和浪费。PagedAttention 将 KV Cache(键值缓存,即模型记住对话历史的数据结构)切成固定大小的「块」,按需动态分配,不同请求的块可以交错存放于显存中,从而使同一张显卡能同时高效服务数十甚至数百个并发会话。这一机制在单用户场景下没有优势,但在需要承载大量并发请求的生产环境中,吞吐量可以比传统方案高出数倍。
几个绕不开的坑
无论选哪个工具,都有一些共性问题要留意。模型太大超出显存时确实还能跑,但会慢到让人头疼。有意思的是,小模型有时反而更占资源——每个人、每个模型都得单独拉取数 GB 的数据,重复下载很占空间。
还有安全问题:这些工具默认都不带密码,所以务必检查端口绑定情况,别把服务无意暴露到公网。
结论:按需选择的决策路径
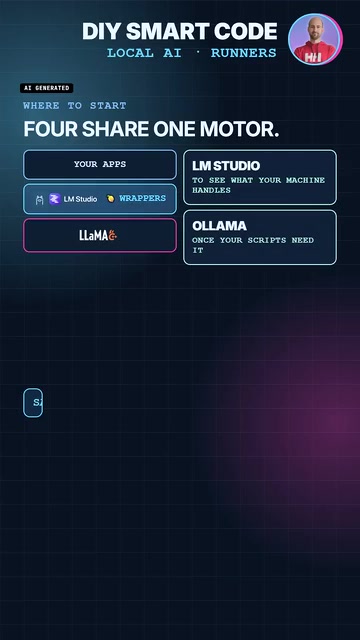
综合来看,一条清晰的选择路径是:
- 先用 LM Studio,直观地看看你的机器到底能扛多少参数量的模型;
- 需要接入脚本和开发流程时,再转到 Ollama;
- 如果你用的是锐龙 AI 笔记本,Lemonade 反而更能榨干硬件性能;
- vLLM 先放一边,等真的有多人并发需求时再考虑。
说到底,选运行器的前提是先看清你的模型有多大、你的机器有多强。硬件条件决定了上限,工具只是决定了体验的舒适程度。
相关推荐
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。
OpenAI Codex 上手指南:用AI代理构建并部署应用
OpenAI Codex 速成课中文整理:从安装、价格套餐、插件与自动化,到 Plan/Go 命令、技能系统,并实战演示用声控 Flappy Bird 游戏走通构建与部署全流程,帮你真正上手这款自主 AI 编码代理。
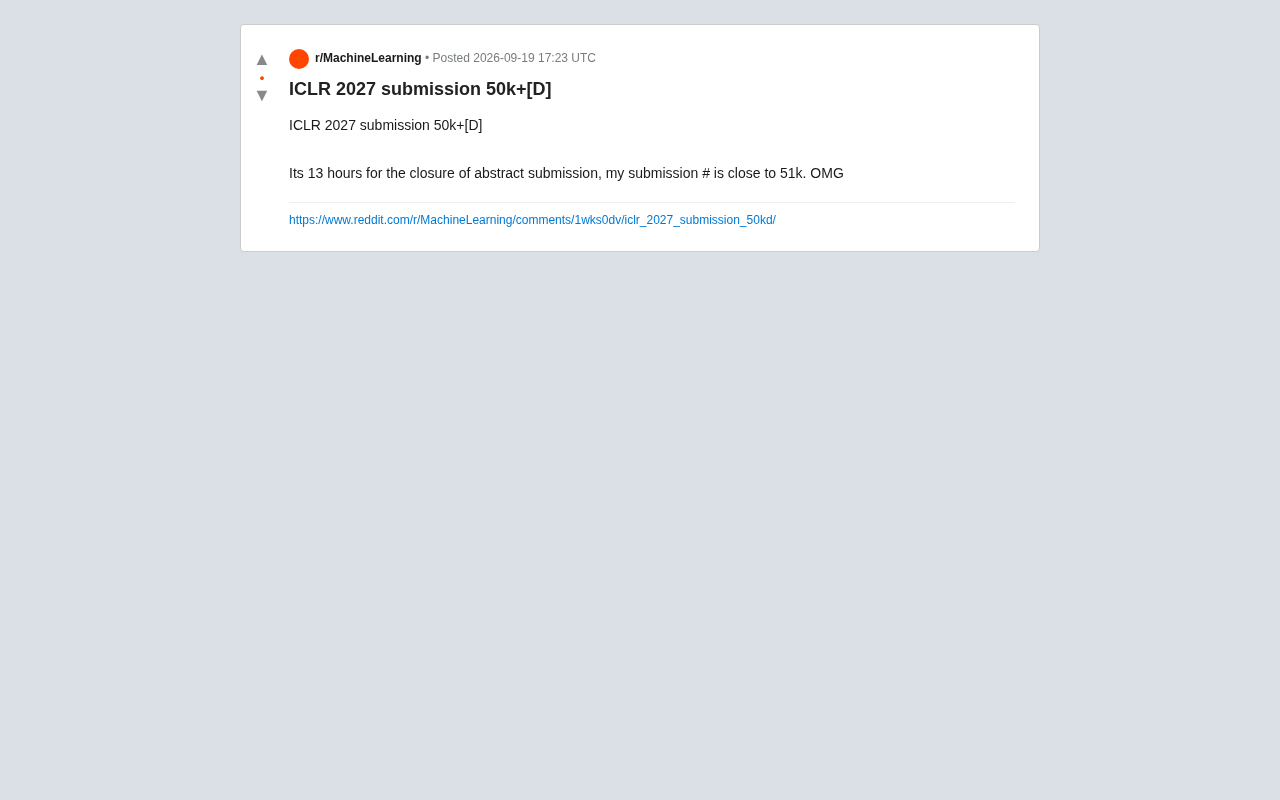
ICLR投稿量突破5万:AI顶会为何持续爆炸式增长
ICLR 投稿编号逼近 5.1 万引发 Reddit 热议。本文分析 AI 顶会投稿量爆炸式增长的原因、对评审系统的压力,以及数字背后的行业信号与反思。