本地恋爱聊天Copilot:322M判断+Gemma起草,数据不出电脑

本地运行的双模型情侣聊天副驾驶,通过微调与推理优化实现隐私与速度。
Laya-Heart 是一个完全运行在本机的「情侣聊天副驾驶」:用户粘贴对方消息后,322M 参数的 Laya 判断潜台词与风险等级,微调后的 Gemma 4 E2B 起草候选回复,默认不外发任何字节。文章详述三项推理优化(--swa-full、为缓存重排提示词、流式输出)如何把首条回复压到约 3.6 秒;微调让 Laya 的 macro-F1 从 0.33 升至 0.57,但安全召回仅 62%,未达 90% 门槛;微调后的 Gemma 在盲评中以 133 胜 67 负胜出,编造从 16 次降至 1 次。作者还记录了用真实 Sentry SDK 逐字节验证追踪无泄漏的调试过程。
当对方只回两个字:没事
你打了又删、删了又打,三个版本的回复躺在输入框里。到底是真没事,还是想要一句道歉、一个解释,或者只是需要一点空间?更现实的问题是:无论你接下来发什么,你真的愿意让一家云端服务先把整段对话读一遍吗?
这正是 Laya-Heart 想解决的问题。它是一个跑在本机的「情侣聊天副驾驶」:把对方的消息复制、切到页面、Ctrl+V,半秒内一张小卡片挂在这条消息下面,用概率给出1到3个追问(「没事」是真没事吗?对方现在需要什么?),或者给出1到10的危险等级。同时 Gemma 4 E2B 立刻开始写两条候选回复,笔记本 CPU 上第一条约 3.6 秒完成。你选一条、改一改、回车复制,自己粘贴回聊天软件。
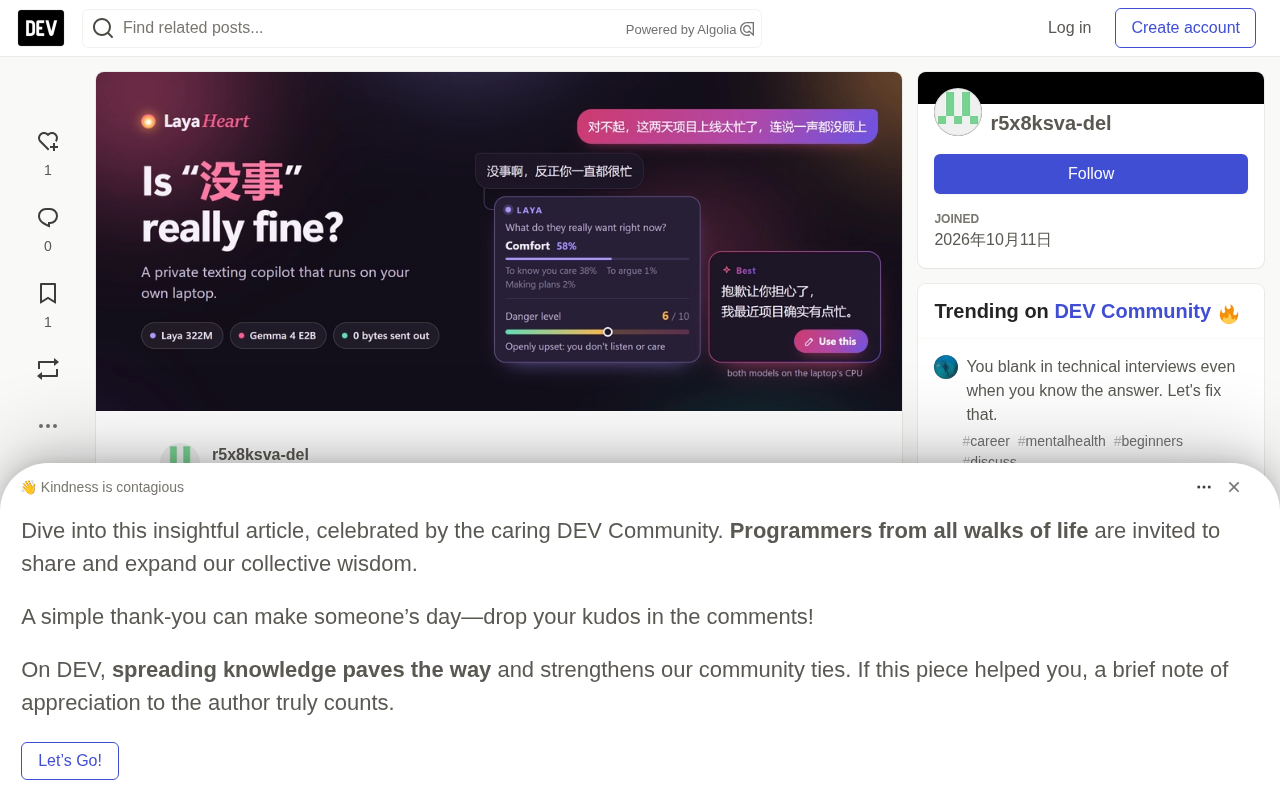
它不连接任何聊天软件,也从不替你发送消息。默认设置下,你粘贴的内容不会离开你的机器。
两个模型的分工:先读潜台词,再写回复
整个系统由两个开源模型撑起来,分工很清楚。
Laya:322M 参数的「读空气」判断器
Laya-multilingual 出自 Convai Innovations,322M 参数,基于 mmBERT 构建,Apache-2.0 许可。它的工作不是生成文字,而是判断:针对每张卡片的问题给出概率,最后再回答一个隐藏的安全问题。作者在 Hugging Face 上放出了零样本版和微调 v3 版的 ONNX 权重。
Gemma 4 E2B:负责起草与记忆筛选
Gemma 4 E2B 负责写两条候选回复,同时挑出聊天里值得记住的事实。作者做了 LoRA 微调,导出 Q4_K_M GGUF(3.4 GB),交给 llama.cpp 的 llama-server 在 CPU 上跑。
说个细节「记忆」的用法:你和每个人的聊天存在本机,你还可以为对方写一本小「书」(昵称、雷区、认识的那天)。当新消息触碰到书里的内容,匹配到的句子会作为上下文交给 Gemma。App 也会自动保存聊天中的事实,用的是聊天原话,可撤销,并且会解析相对日期——「下周六(10-24)是我生日」会被钉成具体日期。
LoRA(Low-Rank Adaptation) 是一种参数高效微调方法:冻结预训练模型的全部原始权重,只在部分层旁插入少量可训练的低秩矩阵(rank 16 即表示低秩分解的维度),因此可训练参数通常只占原模型的极小比例。它的好处是训练快、显存占用低,在 Kaggle 免费 T4 上几十分钟即可完成一轮,且产出的适配器文件很小;推理时可以合并回原权重,也可以单独加载。
GGUF 与 Q4_K_M 是 llama.cpp 生态使用的模型文件格式与量化方案。GGUF 把权重、分词器和元数据打包成单文件,便于分发;Q4_K_M 表示权重以约 4 比特精度存储,其中 K 代表采用分块的混合量化策略,M 为中等档位——关键层保留更高精度、其余层压缩更狠。相比 fp16,模型体积缩小到约四分之一,这也是 3.4 GB 的 Gemma 4 E2B 能在笔记本 CPU 上以可接受速度运行的前提。
让 2B 模型在笔记本 CPU 上「感觉很快」
这是全文最有工程价值的部分。在笔记本 CPU 上,Gemma 4 E2B 读提示词约 55 tokens/s,写约 12 tokens/s,所以等待时间主要花在读上。
最初作者通过 Ollama 的 chat API 调用 Gemma,而它只在提示词完全一致时才复用滑动窗口缓存。于是每条新消息都要重读整个 400–475 token 的提示词,耗时 6.4–9.4 秒。三个改动砍掉了大部分等待:
- 自己启动 llama-server 并加上
--swa-full,让它保留已经读过的全部内容; - 为缓存重排提示词结构:固定规则在前,聊天记录只从尾部增长,最后是短尾巴,把 Laya 的答案转成指令。新消息现在只需读 62–105 个新 token,而不是 400 多个;
- 卡片一完成就开始起草、流式输出、写满两条即停。
实测(Intel i5-13420H、16 GB 内存、无独显):卡片中位 0.44 秒,第一条完整回复 3.6 秒,两条 5.8 秒。这是在后台占用约 3 GB 内存的忙碌机器上测的;空闲机器上用原版模型时分别为 0.39 秒、3.5 秒、5.0 秒,两个模型合计约 2.3 GB 内存。
首次启动只需下载 ZIP 双击 start.bat,点一个按钮下载约 4.8 GB 模型文件,支持断点续传,每个文件用固定的 SHA-256 校验。
滑动窗口注意力缓存(SWA cache) 是这里性能问题的根源。采用滑动窗口注意力的模型只让每个 token 关注前面固定长度范围内的上下文,因此推理框架默认只需保留最近一个窗口的 KV 缓存,更早的内容会被丢弃。好处是长上下文时内存占用恒定,代价是当新请求的提示词与上一次只有尾部不同时,框架无法复用整段前缀,必须重新读入。--swa-full 让 llama-server 保留完整缓存而非仅窗口部分,从而支持前缀复用。
KV 缓存与提示词前缀复用 指的是:自回归模型处理提示词时,会为每个 token 计算并缓存注意力所需的键值对。若新请求与旧请求共享一段完全相同的前缀,框架可直接复用这些缓存,只计算新增 token。这也是为什么提示词结构要把固定规则放在最前、聊天记录从尾部增长——任何位于中部的改动都会让后续缓存全部失效。
微调判断器:F1 从 0.33 到 0.57,安全召回从 0% 到 62%
开箱即用的 Laya 是通用判断器,没针对情侣聊天调过。作者搭了一套训练工具链并跑通了全流程。
训练数据靠两个「老师」:Teacher A(DeepSeek广告-V4.1-Flash)写 3000 段练习对话来拟合选定答案,然后对每段对话每个问题读五遍,与预期答案不符的直接丢弃;Teacher B(Qwen3,不同模型家族)写并标注另一份 300 段对话的练习考卷,保证模型不会由教它的老师来评分。训练在 Kaggle 免费 T4 上跑,三个随机种子约一小时,训练前就把门槛定好。
| 300 段练习考卷(Teacher B:Qwen3-32B) | 零样本 Laya | 微调 v3 |
|---|---|---|
| 11 个问题的判断 macro-F1 | 0.33 | 0.57 |
| 校准误差(ECE) | 0.15 | 0.07 |
| 危险等级平均绝对误差(1–10) | 2.78 | 1.56 |
| 0.8 报警线下的安全召回 | 0/21 | 13/21(62%) |
| 普通聊天的误报 | 2.9% | 1.4% |
F1 提升的 95% 置信区间是 0.18 到 0.31。作者坦率承认两条门槛还没过:安全召回 62% 对标的是 90%,漏掉的 8 段风险聊里有 5 段是「控制和虐待」被读成了无风险,比如「除非通过我,否则你别想再见你姐姐」;「危机是否已过去」这个问题 F1 掉了 0.08,而限制是 0.02。不过 v3 让 App 的安全提示从 21 段风险聊里触发 4 段提升到 13 段,所以自 10 月 18 日起 App 已经用上 v3,最终由一场留出的考试决定去留。
整轮微调花了约 23 元人民币(约 3 美元)的 DeepSeek API 调用费,外加约 9 个 Kaggle 每周免费 GPU 小时。跑完整个工具链还顺带在代码和手册里找出 41 个问题,包括一个缓存 bug——它悄悄让 20% 的练习对话变成了近似重复样本,在最终训练前被修掉。
三条有价值的微调经验
- 比平均值,不比最好的种子。 同一版本不同随机种子的 F1 相差 0.02–0.05;三个种子平均后,v1、v2、v3 分别是 0.57、0.56、0.56。
- 多加风险样本会渗到其他答案。 把风险对话占比从 10% 提到 25%(v2),独立安全检查上的召回从 53% 升到 68%,但模型开始把更多聊天判成紧急情况,漏掉「只是在生气」的伴侣。v3 让风险样本只训练安全问题:在 47 段新风险聊 + 19 段普通聊上召回达到 79% 且无误报,副作用基本消失。
- 考你的老师写不出来的东西,你测不了。 让 Qwen3-14B 写 25 段风险考卷,只有 5 段带清晰信号;换更严格的提示词和更大的 Qwen3-32B,考卷才凑到 21 段。
macro-F1 是先对每个类别分别计算精确率与召回率的调和平均(F1),再对所有类别取未加权平均。与按样本数加权的 micro-F1 不同,macro-F1 让稀有类别与常见类别权重相同,因此少数类表现差会被明显放大——这正是安全类问题需要的度量方式。当 11 个问题的选项分布不均时,一个总猜多数的模型 macro-F1 会很低,0.33 大致反映了这种水平。
ECE(Expected Calibration Error,期望校准误差) 衡量模型给出的概率是否可信:把预测按置信度分桶,比较每桶的平均置信度与实际准确率,加权求平均绝对差。ECE 为 0.07 意味着模型说「70% 可能」时,实际发生率平均偏离约 7 个百分点。对催生安全报警的系统而言,校准比单纯的准确率更重要——报警线设在 0.8,若概率系统性偏高,误报会激增;偏低则漏报。
微调写手:133 胜 67 负,胡编从 16 次降到 1 次
Gemma 也做了微调,App 现在下载四次运行中的第四次,选哪次由训练前写好的规则决定。
- 数据: 1496 个样本。中文部分由 Teacher A 按 App 的确切提示词写候选回复集,App 的规则筛掉坏集合,得分最高的成为训练回复;108 条英文回复是原版 Gemma 自己的草稿,同样过滤和评分,所以都控制在 App 的 60 字符以内。
- 训练: Kaggle T4 上一个 47 分钟的任务,用 Unsloth 训练 LoRA(rank 16,两个 epoch),导出 3.4 GB 的 Q4_K_M GGUF。
- 结果: 在全部 297 段练习考卷上,Teacher B(Qwen3-32B)在两种顺序下盲评,对比微调版与原版 Gemma:133 胜、67 负、97 平(平局算一半是 61%,中文聊天上 65%)。微调版编造或过度承诺 1 次,原版 Gemma 16 次。
- 仍未过的一条: 在工具链的 50 段自检中,所有门槛都过,只有胜率 0.54 低于 0.55 的门槛(同一批 50 段第二次评判给的是 0.57)。
为什么开源在这里赢过闭源
作者用了一个很具体的对比:他基于 Jev Chat Assistant 构建,而后者默认调用一个闭源的托管判断器,并把聊天最后十行发过去。那个模型没法微调,条款也不允许用它的答案训练模型。Laya 的权重是开放的,所以能针对情侣聊天、按自己定的标准去微调,并且跑在用户自己的电脑上,发出 0 字节。
这几点值得展开:
可验证的隐私。 情侣聊天大概是最私密的数据之一,而对方从没同意过把消息发到任何地方。开放权重让这件事成立:两个模型都在本机跑,服务器只监听 127.0.0.1,页头还有一个徽章统计每轮向外发送的字节数(默认是零)。用户的担忧是真实的——皮尤研究显示 71% 的美国成年人认为 AI 会让他们的个人信息更不安全。
允许一次性定价的成本结构。 没有按条计费,整轮微调约 3 美元加免费 GPU 小时,所以 App 可以卖一次性价格而不是订阅。作者按公开普查和调查数据估算,美国 20–34 岁有伴侣且用智能手机的人群约 3900–5100 万,其中 1700–2700 万可用 Windows PC;中国市场同一口径是 1.38–1.62 亿和 4100–9400 万。同类主流 App(RIZZ、WingAI、YourMove 等)在美国 App Store 卖 29.99–79.99 美元/年,他打算一次性收 14.99 美元(中国 68 元),代码保持 MIT。
能针对窄场景调优。 读懂中文情侣聊天里的潜台词(「你最好是」「没事」「随便」)是个很窄的任务,可以用自己的数据、按自己定的门槛训练一个小判断器;结果出乎意料时,还能打开模型看为什么——是种子噪声、数据配比,还是考卷老师的问题。
不锁定。 设置里可以指向另一个 GGUF 文件或 Ollama 模型,或指向 laya-serve 端点。
安全规则写在代码里,不交给模型
每张卡片之后,Laya 还会回答一个隐藏的安全问题,代码同时检查聊天关键词。出现自残或被虐待、被控制的迹象会弹出提示;自残情形下,候选回复里会包含一条人写的、不是 Gemma 生成的选项。如果聊天看起来涉及未成年人,在确认双方都是成年人之前不会起草任何内容。在下面描述的 300 段练习考卷上,21 段风险聊中有 13 段触发了提示(单靠关键词规则能抓 4 段),普通聊天误报率 1.8%。
需要说明的是:Laya-Heart 只是起草回复,它不是心理咨询或危机支持。遇到危机请联系当地紧急服务或求助热线。另外,对方未必同意自己的消息被分析,使用时应保持谨慎。
一次用 AI Agent 排查追踪泄密的实录
作者用 Claude Code 完成了大部分代码、训练和演示录制。Agent 会话里有一段很有代表性的调试:为 Sentry 追踪做「只发数字」的守卫。
Agent 写完追踪模块和 7 条单元测试后没有停在自测上。它把一个假 DSN 指向 localhost 的接收器,用真实的 Sentry SDK 跑一轮,逐字节检查会发出去的内容——结果发现 Sentry 11 是逐条流式发送 span 的,它原本为整条 transaction 写的清洗钩子根本没执行。数据没泄漏,但只是因为 span 上本来就没放文本。它把守卫挪到正确位置,并做了双向验证:塞满聊天文本的 span 到达时只剩下 token 计数;去掉守卫后同一检查失败并打印出泄漏的字句。
正式跑起来又暴露两个追踪本身的 bug:上面那个流式问题,以及第一次真实运行变成一条 194 个 span 的大 trace,因为默认集成关闭后没有东西为每个请求开一条 trace。用 Sentry.startNewTrace 为每轮开头修好了。40 轮带微调模型的追踪还显示:一轮里三次 Laya 调用(两个卡片问题加隐藏的安全问题)在忙碌 CPU 上花 1.25 秒才轮到 Gemma 开始;AI Agents 面板统计到 288 次 Laya 调用和 40 次 Gemma 调用、共 51602 个 token,估算成本保持 0 美元——因为两个模型都在笔记本上跑。
这段过程本身就说明了开源 + 本地推理的价值:如果模型在云端,这种「逐字节确认没泄漏」的验证根本无从谈起。
Sentry 的 trace 与 span 是可观测性中的两级结构:一次完整请求链路称为一个 trace,链路中的每个操作(一次模型调用、一次数据库查询)是一个 span,span 之间可以嵌套并记录耗时、属性等元数据。Sentry 11 的 SDK 默认以流式方式逐条发送已结束的 span,而不是等整个 trace 结束后一次性提交。
这解释了为什么原本针对整条 transaction 写的清洗钩子没有执行:钩子挂在了错误的生命周期节点上,span 早已在钩子运行前发出。正确做法是把清洗逻辑挂在每个 span 发出前的回调上。这也说明「数据没泄漏」可能只是偶然——若 span 属性里恰好带了文本,钩子失效就会直接外发,因此必须用真实 SDK 打到本地接收器逐字节验证,并做去掉守卫后应失败的负向测试。
试一下
在线演示(stand-in 模型、样例数据)可以在浏览器里体验真实页面的全部流程:粘贴一句话、选一条回复、编辑、加一个联系人,什么都不会离开标签页。想跑真模型就下载 ZIP、双击启动脚本,第一次点按钮下载约 4.8 GB。评估数字可以用一条命令复现:npm run reproduce 大约两秒离线重算报告里的 62 个评估数字;加上 --models 会按固定版本下载两个 Laya 模型并在你的 CPU 上重跑 68 项检查,每个概率与记录运行的误差在 0.001 以内。
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。