#模型微调
共 49 篇相关文章

小模型微调逆袭:2B/4B参数击败GPT-6 Luna
用Shopify商品分类任务实测:20亿和40亿参数的Qwen 3.5微调后准确率分别达69.8%和73%,超过GPT-6 Luna的68.2%。完整拆解数据准备、LoRA超参数、serverless微调与评估流程。
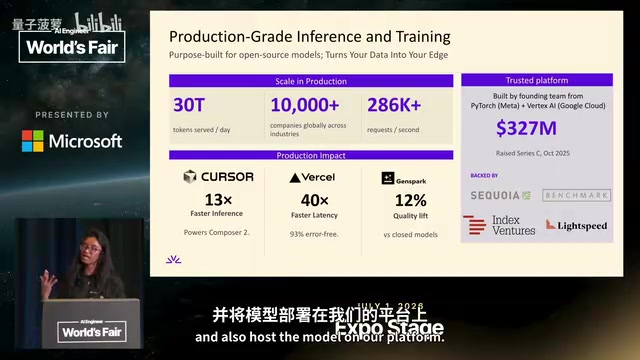
Fireworks AI:开源模型如何靠训练部署飞轮比肩闭源
Fireworks AI 应用机器学习负责人 Jet 详解开源模型如何通过自研推理引擎、三种训练形态与训练推理同平台的数据飞轮,在延迟、成本和质量上比肩闭源模型。

医学图像分割:基础模型微调与任务专用训练谁更胜一筹?
系统对比DINOv2基础模型适配与U-Net任务专用训练在医学图像分割中的表现:基础模型跨机构泛化更优,但分布内边界精度不及数据充足时的专用模型,适配容量由成像域决定。

不微调,给35B MoE模型做「脑部手术」:抑制重复错误的探索
Reddit开发者分享不微调、直接干预35B MoE模型内部的「脑部手术」实验,试图抑制模型重复错误,并坦诚呈现进行中的真实结果与局限。

322M小模型微调实战:三轮迭代,两次失败,终让编程Agent更安全
开发者记录laya-guard项目:将322M小模型微调为编程Agent的命令安全守卫。三轮训练中两次失败,暴露数据长度偏差、注释偏见和密钥暴露盲区,最终以61%allow比例交付,并反思评估独立性难题。

HyperRepair:仅推理阶段恢复微调模型通用能力
HyperRepair 提出用超网络在推理阶段恢复微调语言模型被遗忘的通用能力,在12个LoRA数据集和15个通用基准上达到基座模型93.4%的通用得分,同时保留99.5%的领域性能。

0.53美元微调出高性能模型:完整工作流解析
一位Reddit用户用0.53美元完成高性能模型训练后微调并公开工作流。本文解析低成本微调的成本结构、可复用流程与适用边界,帮助开发者用极低预算快速验证模型定制方向。

学生与研究者如何低成本训练与微调ML模型
从Reddit社区讨论出发,探讨学生与研究者如何以低成本完成机器学习模型训练与微调,覆盖PEFT参数高效微调、计算机视觉轻量方案与深度学习工程实践,并如实说明原始素材的信息缺口。
Unsloth v0.1.913-beta 发布:自定义背景、性能翻倍与本地大模型体验升级
Unsloth v0.1.913-beta 发布,新增自定义背景、14 种语言与全新界面布局,应用更新时间减半,Qwen-Image 在 16GB 显存下渲染提速 2 倍,并引入 DeepSeek-V4.1-Flash-1017 与 Dynamic v3.1 GGUFs 预览。

多模态大模型部署与微调实战:岗位技能与学习路径
B站公开课聚焦多模态大模型部署与微调实战,讲师陈伯解析AI大模型工程师需掌握的应用开发、微调训练与底层原理三项技能,指出部署门槛较低、微调才是学习重心。

高质量LoRA训练全流程指南
系统梳理高质量LoRA训练的端到端流程,涵盖数据集构建与清洗、基座模型与超参数选择、正则化图像争议、checkpoint评估与迭代策略,帮助开发者建立可复现的LoRA训练闭环。
Nemotron后训练实战:5步搞定法语本地化模型
NVIDIA Nemotron团队发布5分钟教程,详细演示如何通过定义行为、生成合成数据、LoRA微调等五个步骤,对基础模型进行法语本地化后训练,方法可迁移至任意语言。

Nemotron微调:让本地AI懂规则而非只懂语言
NVIDIA 开发者博客提出,AI 本地化不能只解决语言问题,还需通过微调 Nemotron 注入本地规则知识。本文分析这一思路对开发者与企业落地的启示。
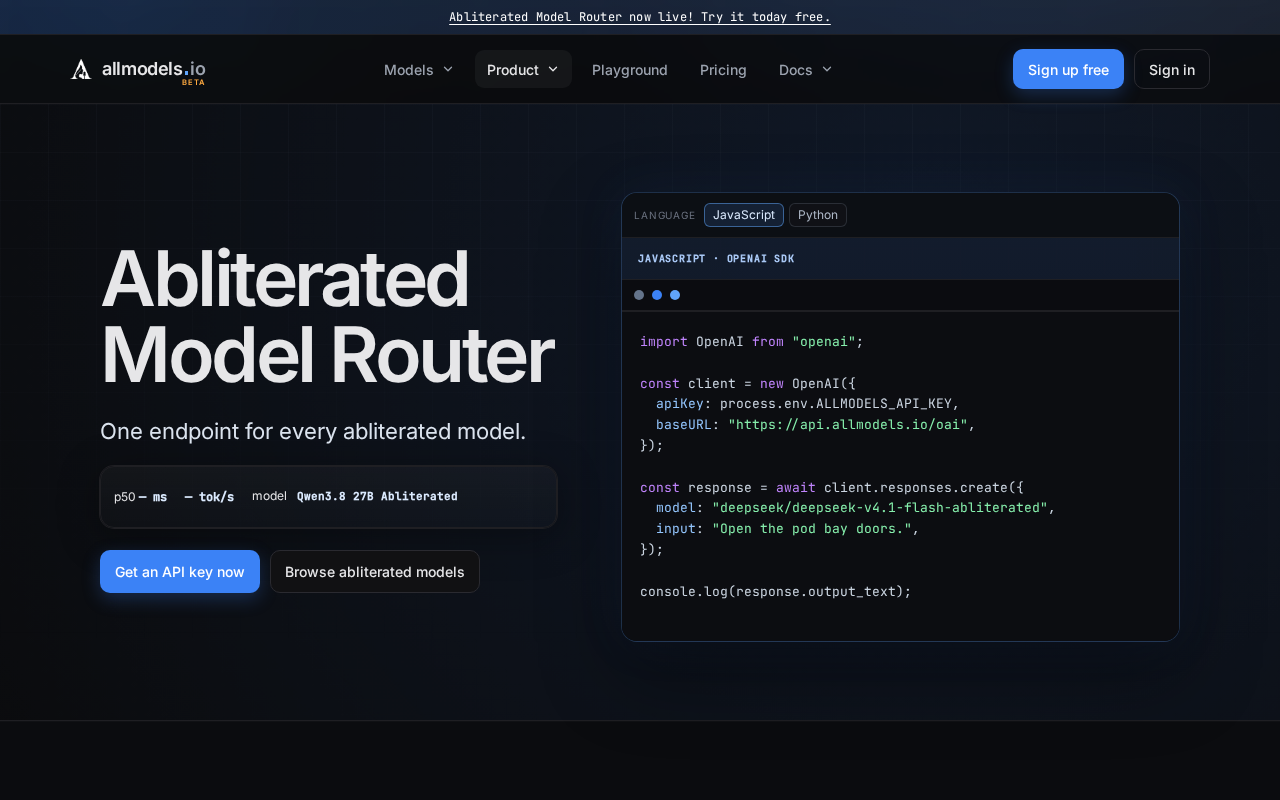
Abliterated DeepSeek 推理服务商增至五家
Abliterated DeepSeek 推理服务商已增至五家,Hacker News 社区就此展开讨论。本文解析 abliteration 的技术含义、多服务商出现的成因,以及对开发者在选择、版本一致性和合规风险方面的实际影响。
4B模型微调实战:Three.js 3D场景生成能力持续提升
开发者分享Qwen3.5-4B微调进展:以Three.js场景生成为测试任务,最新checkpoint在场景质量和一次通过率上明显提升,已更新量化版本并修复层问题,训练预计10月28日完成,后续将开源全套权重、数据集与技术报告。

Together推出后训练服务:用SFT和RL定制专属开源模型
Together AI上线Post-Training服务,支持SFT和RL将开源模型定制为自有模型。客户定义数据、奖励、环境和训练循环,平台提供底层训练基础设施。

Together后训练平台:训练循环自主掌控,基础设施全托管
Together AI 推出 post-training 平台,训练循环由用户代码定义数据、奖励、损失与优化器,GPU 与基础设施全托管,并提供 Recipe 模板快速起步。本文解析其控制权与托管分离的设计思路及行业定位。
Unsloth v0.1.910-beta 发布:Flint 编程代理、MO…
Unsloth v0.1.910-beta 发布:Flint 编程代理、MOSS-Image 与 NVIDIA Bolt E4B 本地可跑
Unsloth v0.1.910-beta 发布,带来 Recursive Flint 编程代理、OpenMOSS 的 MOSS-Image 文生图模型与 NVIDIA Nemotron 3.5 Bolt E4B,并新增 MLX MoE SSD 专家卸载、REAP 专家剪枝与 OpenAI 兼容微调 API。

用好已有日志:微调小模型反超前沿大模型
Twitter开发者分享:利用已有运行日志筛选成功案例,微调9B小模型,在特定任务上击败前沿大模型。本文解析这一思路的原理、落地步骤与工具smithtune,探讨AI应用开发中的数据飞轮策略。
 科技前沿
Nous Research 推出 Arete-27B: propaganda 率从22%降至0.9%
Nous Research 发布 Arete-27B,基于 Qwen3.8-27B 的 Apache 2.0 微调模型,在 803 条提示词评测中將 propaganda 回答率从 22% 降至 0.9%,Hermes Bench 保持 65.60% 不变。