本地LLM硬件多久回本?Sunk Cost工具帮你算清这笔账
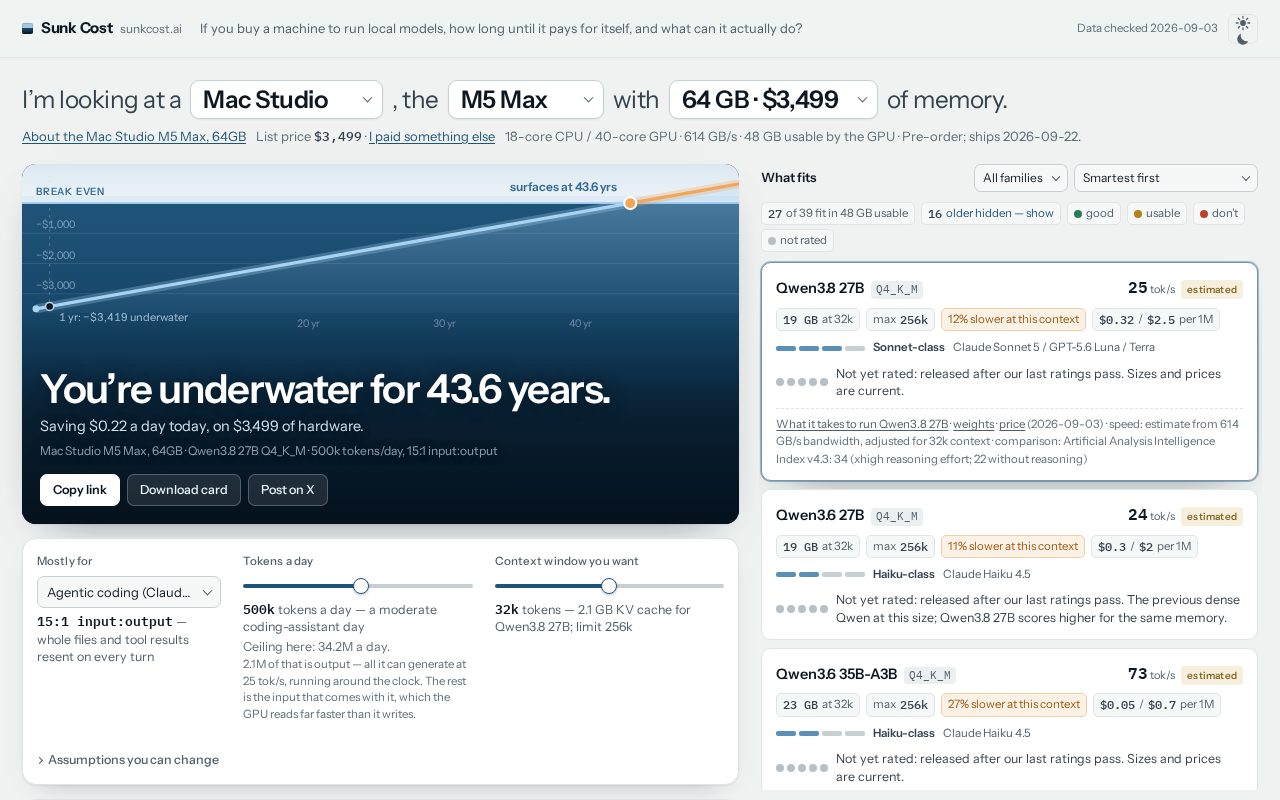
Sunk Cost工具量化本地LLM硬件回本周期,核心结论是使用强度决定自建是否划算。
Sunk Cost是一个在Hacker News引发讨论的工具,专门计算本地部署LLM硬件需要多久才能在经济上"回本"——即本地一次性硬件投入何时与持续累积的云端API费用产生成本交叉。分析拆解了一次性硬件采购、持续性电费折旧与按token计费的API开销三类变量,得出核心结论:使用强度几乎决定一切,重度用户自建更省,轻度用户付费更划算。文章同时指出,纯经济回本只是决策的一部分,数据隐私、延迟可控、模型微调自由等非货币价值同样举足轻重,真实决策需结合个体场景综合权衡,而非依赖单一数字。
一个绕不开的问题:自建LLM到底值不值
随着开源大模型能力不断逼近闭源产品,越来越多开发者和团队开始考虑一个务实的问题:与其持续为API付费,是否应该直接购置硬件、在本地跑模型?Hacker News上一个名为 Sunk Cost 的项目(Show HN 帖,获得35个赞、56条评论)正是为回答这个问题而生——它试图量化一台本地LLM设备需要多长时间才能"回本"。
所谓"回本",本质上是一道对比题:本地硬件的一次性投入(GPU、整机、电费等)与调用云端API的持续开销,究竟在什么时间点上出现交叉。Sunk Cost把这个模糊的直觉变成了可计算的数字。
回本计算背后的核心变量
要判断本地部署是否划算,需要把几类成本拆解清楚。
一次性成本
最大头是硬件采购。跑得动主流开源模型的配置通常需要高显存GPU,从消费级显卡到多卡工作站,价格跨度极大。这笔钱是典型的"沉没成本"(sunk cost,也正是项目名称的由来)——一旦花出去就无法收回,只能靠后续使用来摊薄。
主流开源模型对显存的要求差异悬殊,是硬件选型的核心约束。以当前流行的模型为例:7B参数模型以4-bit量化运行约需6-8GB显存,可在消费级单卡(如RTX 3080/4070)上运行;13B模型需12-16GB;70B模型则往往需要多卡或专业级显卡(如A100、RTX 4090的24GB版本)。量化技术(GGUF、AWQ、GPTQ等格式)能大幅压缩显存占用,但通常以牺牲少量精度为代价。除GPU外,整机还需匹配足够的系统内存(RAM)和高速NVMe存储,加上散热和稳定电源,完整建置成本往往比单卡报价高出50%-100%。
持续性成本
本地运行并非零成本。电费是最直接的开销,高功耗GPU长时间满载运行会带来可观的电力账单,不同地区电价差异还会显著改变结论。此外还有硬件折旧、维护以及潜在的闲置浪费。
对照组:API调用费用
云端API按token计费,用得越多、越频繁,累计费用越高。对于高频、大批量的推理需求,API成本会快速累积;而对于偶尔使用的场景,API的"按需付费"反而更经济。
主流云端API通常按输入token与输出token分别计费,输出token价格一般高于输入token。以GPT-4o(截至2024年)为例,输入约$5/百万token、输出约$15/百万token;而Llama3等开源模型通过各第三方推理平台调用,价格可低至$0.1-$0.5/百万token。一次典型的对话交互可能消耗500-2000 token,以此换算日常用量较为直观。对于代码生成、文档处理等批量任务,单次调用的token消耗量可能达到数万甚至数十万,费用积累速度远超普通聊天场景,这正是回本计算器对批量用户最具参考价值的场景。
关键结论:用量决定一切
从这类工具的逻辑可以推出一个朴素但重要的结论——本地设备是否回本,几乎完全取决于使用强度。
对于每天大量、持续调用模型的重度用户或团队,本地硬件的边际成本极低,前期投入能在相对合理的周期内被摊薄,长期来看更省钱。反之,如果只是偶尔调用,昂贵的硬件大部分时间处于闲置状态,回本周期可能长到失去意义,此时继续使用API才是理性选择。
这也解释了为什么HN评论区往往会出现分歧:不同用户的实际用量、电价、硬件选型差异巨大,导致"该不该自建"没有统一答案。工具的价值恰恰在于把这些个体参数代入,给出针对性的测算,而非一个笼统的口号。
被忽略的隐性因素
单纯的金钱回本只是决策的一部分。围绕本地部署,还有几项难以直接货币化、但实际影响很大的考量:
- 数据隐私与合规:本地运行意味着数据不出本地环境,对于敏感行业,这一点的价值可能远超电费账单。
- 延迟与可用性:无需依赖网络和第三方服务,本地推理的响应更可控,也不受服务商限流、涨价或停服影响。
- 模型选择自由:可以自由加载、微调各种开源模型,而不受API供应商的模型清单约束。
- 机会成本与技术门槛:搭建和维护本地环境需要投入时间和运维精力,这部分成本常被计算器忽略。
换句话说,Sunk Cost这类工具算出的是纯经济回本点,但真实决策往往是经济性与非经济因素的综合权衡。
模型微调(Fine-tuning)是本地部署独有的另一项重要价值,在纯经济核算中通常被忽略。通过在私有数据集上对开源模型进行微调,可以让模型更贴合特定业务场景、专有术语或输出格式,这是调用标准API无法实现的能力。微调后的模型往往能以更小的参数规模达到专用任务上接近大模型的效果,进一步降低推理硬件门槛。对于有大量领域专属数据的团队(如法律、医疗、金融),本地微调能力的战略价值可能是驱动自建决策的最重要因素之一,而非单纯的API费用对比。
这类工具的现实意义
Sunk Cost走红的背后,反映的是本地LLM生态正在成熟——硬件成本下降、开源模型质量提升,使得"自建"从极客的玩具逐渐变成有商业可行性的选项。一个简单的回本计算器之所以能引发讨论,是因为它精准戳中了大量开发者正在纠结的现实决策。
对于正在评估的读者,建议不要被"回本"这个词简单绑架。先诚实评估自己的真实用量与增长预期,代入本地电价与目标硬件的实际参数,再把隐私、可控性等非货币价值一并纳入考量。计算器能给出数字,但最终的取舍仍要结合具体场景。
需要说明的是,本文基于Hacker News的Show HN帖及其讨论进行分析,工具的具体测算模型与参数设置以项目实际页面为准。
相关推荐
自适应物理AI探索:LLM智能体能否胜任长周期物理任务?
最新arXiv论文探讨LLM智能体能否管理长周期物理任务。研究通过整合规划、工具调用、观察与验证的多智能体框架,在农业场景中对比零样本LLM与强化学习智能体,发现LLM在环境变化时具备更强的自适应能力。
先收敛后多样化:多目标贝叶斯优化的CTD新范式
arXiv新研究提出Converge-Then-Diversify(CTD)方法,将多目标贝叶斯优化中的收敛与多样性解耦为两个阶段。在446次对比中72.9%显著胜出,尤其在紧预算和高维问题中优势明显。
Vibe Patenting:LLM评审员能胜任专利撰写评估吗?
arXiv最新研究通过Vibe Patenting测试平台,评估LLM评审员在专利撰写这类专业任务中的可靠性。研究发现评审反馈能让低成本智能体逼近高端模型,但AI评审与人类专利律师的一致性强烈依赖具体指标。