本地跑AI模型不等于安全:警惕成为黑客入侵入口
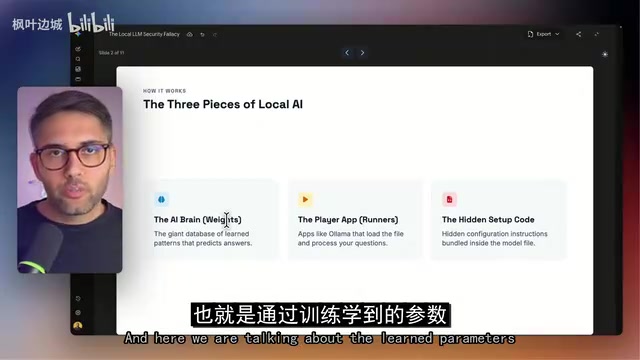
本地AI模型并非绝对安全,恶意模型文件或运行器漏洞可让攻击者完全控制你的电脑。
本文梳理了一位海外博主关于本地大模型安全风险的核心观点。运行本地AI模型实际上涉及三个组件:神经网络权重、运行软件(如llama.cpp/Ollama)和捆绑在模型文件中的配置脚本。任何一环都可能成为攻击入口——攻击者可在配置脚本中植入恶意命令,或利用运行器漏洞(如「Llama Drama」CVE-2024-34359)实现任意代码执行,进而窃取本地凭证和数据。此外,开放权重模型(如DeepSeek)因不公开训练数据,还可能隐藏偏见风险。博主建议:不在主机直接运行未验证模型,改用沙盒隔离或AWS Bedrock、Azure等可信云平台,将安全责任交由专业团队处理。
很多人以为在自己电脑上运行本地AI模型是绝对安全的——毕竟数据不出本地,模型不过是一堆矩阵里的数字。但海外博主在最新视频中提出了一个反直觉的警告:下载了错误的模型或运行软件,反而可能给黑客打开完全控制你电脑的通道。本文梳理这位博主的核心观点,帮助你理解本地大模型背后被忽视的安全风险。
本地AI模型到底是什么
所谓本地AI模型,指的是像 Ollama 这类可以安装在笔记本上的工具,用它来运行 DeepSeek广告、Qwen 等开源模型。这些模型运行效率很高,效果可以接近 OpenAI 的商用模型,而且完全免费。
最吸引人的一点是数据主权:你不需要把数据发送给任何云服务商,甚至断网、在飞机上也能使用。对于希望彻底掌控自身数据、不与外部共享的企业来说,这正成为一种越来越受欢迎的方案。
正因为一切都在本地进行,很多人默认这样就万无一失——数据没外传,一切安全。博主指出,这个假设并不完全正确。
三个组件,三重风险
博主强调,当我们谈论本地AI模型时,实际上同时在处理三样东西:
- 大脑(神经网络):通过海量数据训练出来的模型,本质上是输入进去、输出出来的一堆数字(张量)。
- 运行软件:要和这个「大脑」交互,需要软件来跑,比如 Ollama,或者依然流行的 llama.cpp。
- 隐藏的配置代码:捆绑在模型文件里的隐藏配置。
关键问题在于:当你下载这三个元素时,没有任何百分之百的保证能确保这些文件不会在你的电脑上执行代码。而这里的「执行代码」,指的不是帮你自动处理邮件那种好代码,而是可能让他人获取你的数据、密钥、凭证的恶意代码。
博主把这种风险称为「特洛伊木马陷阱」:你从论坛上下载一个热门免费模型,却可能连带下载了藏在其中的恶意内容。
张量(Tensor)是理解模型文件结构的关键概念。神经网络的「权重」本质上是多维数组,存储在 .safetensors、.gguf 或 .bin 等格式的文件中。这些数字本身是静态的,无法自行执行;真正危险的是伴随它们的配置脚本,例如 Hugging Face 仓库中常见的 config.json、tokenizer_config.json,以及某些框架支持的 Python 脚本(如 modeling_xxx.py)。部分框架在加载模型时会自动执行这些脚本(即「任意代码执行」机制),这是攻击者的主要注入点。GGUF 格式相比原始 PyTorch 格式有所改进,将元数据和权重打包在单一二进制文件里,理论上减少了外部脚本依赖,但并未完全消除风险。
Hugging Face 上的隐患与「Llama Drama」
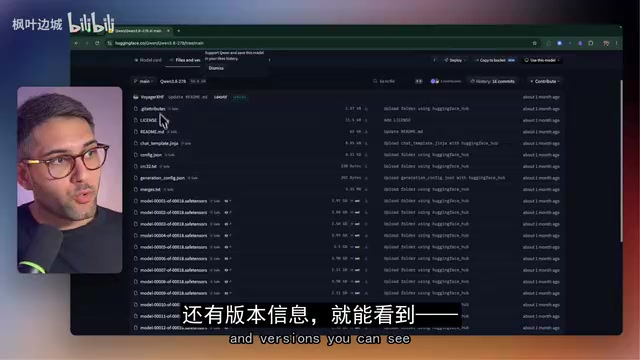
业内最常见的模型分享平台是 Hugging Face,上面有上千个免费模型,涵盖语音、图像识别甚至视频生成。当你查看某个模型的「Files and versions」时会发现,下载的不只是那堆代表数字的张量文件,还有配置文件、以及说明如何与这些数字交互的脚本文件。
问题就出在这里。由于模型文件往往非常庞大,攻击者有可能在配置脚本里藏入恶意命令。当你开始与这个模型对话时,隐藏命令被激活,攻击者便能在你的电脑上运行程序。
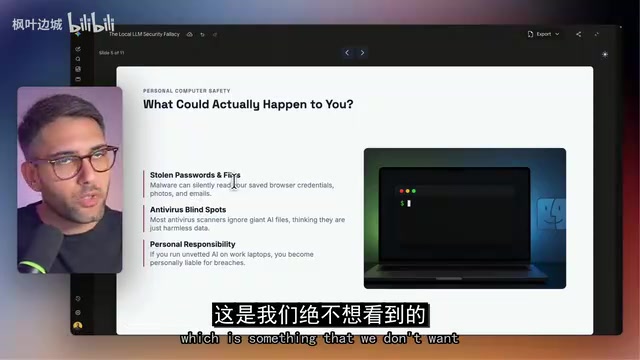
博主提到一个真实案例——被称为「Llama Drama」的漏洞,存在于 llama.cpp 运行器中。用户下载运行器、安装模型后,攻击者可借漏洞在其机器上执行任意代码。据称 Hugging Face 上曾有超过 6000 个模型存在潜在漏洞。一旦中招,本地保存的浏览器凭证、照片、邮件都可能被读取并泄露。
「Llama Drama」具体指 2024 年披露的 CVE-2024-34359 漏洞,存在于广泛使用的 llama.cpp 推理引擎中。攻击者可以构造一个恶意的 GGUF 模型文件,其中嵌入畸形的元数据头,触发 llama.cpp 在解析时发生缓冲区溢出(Buffer Overflow),从而实现任意代码执行(RCE,Remote Code Execution)。缓冲区溢出是一种经典漏洞类型:程序向内存缓冲区写入的数据超过其容量,溢出部分覆盖相邻内存区域,攻击者可精心构造溢出内容以控制程序执行流。由于 llama.cpp 被 Ollama、LM Studio 等众多前端工具作为底层引擎,该漏洞的影响面极广,用户即使从未直接接触 llama.cpp,只要使用了上层工具加载外部模型,同样面临风险。
开放权重与开源模型的区别
博主特别厘清了两个容易混淆的概念:
开放权重模型(Open Weight):你可以下载并使用,比如 DeepSeek、Qwen、Mistral。但它们的训练数据集、训练脚本仍是私有的。你无法知道 DeepSeek 究竟用什么数据训练,也无法据此复现一个新模型。
开源模型(Open Source):提供方连训练数据、训练脚本都一并开放。典型例子是 OpenAI 的 Whisper,代码和数据都可查看,可用于语音转文字。这类真正意义上的开源模型相对少见。
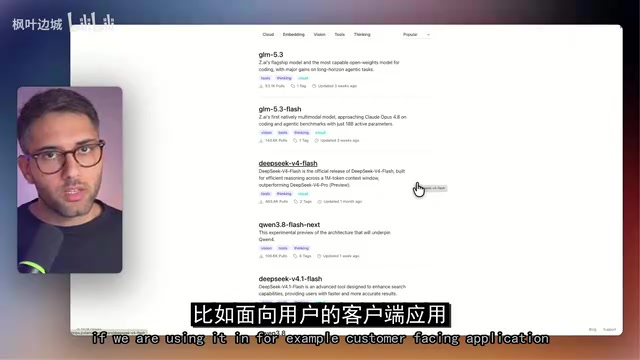
这个区分为何重要?开放权重模型存在另一类风险:由于我们不知道训练数据,模型可能带有隐藏偏见——性别歧视(如求职应用中的男女差异)、政治倾向(在特定地区训练的数据可能夹带政治议程)、文化差异等。这类风险不会黑掉你的电脑,但会损害你的应用,尤其是面向客户的场景。
更安全的使用方式
面对这些风险,博主给出的建议是:不要直接在主力电脑上本地安装模型运行器。更稳妥的做法是把这些开放权重模型部署到云端,让 AWS、Azure、Google Cloud 等云服务商去处理安全补丁和漏洞修复。
他观察到,大多数企业本身也倾向走云端路线——因为运行更复杂的模型需要本地 GPU,而这恰恰是很多企业缺乏的。通过 AWS Bedrock、Azure 等可信云平台运行,既能用上开放权重模型,又把安全责任交给了专业团队。
如果坚持要在本地实验,博主的核心原则是:把AI文件当成下载的应用程序来对待——它们可能包含漏洞和病毒,绝不在主机上直接运行未经验证的模型。他推荐使用沙盒工具(如面向AI Agent的沙盒),先安装沙盒软件,再从内部启动 Ollama 或 Claude Code,让沙盒自动加上防护栏,防止AI做出危险操作。
**沙盒(Sandbox)**是一种操作系统级隔离机制,将目标进程限制在受控环境中运行,使其无法访问宿主机的文件系统、网络或其他进程。常见实现方式包括 Docker 容器、虚拟机(VM)以及专为 AI Agent 设计的轻量级沙盒工具(如 E2B、Daytona)。在沙盒内运行 Ollama 的核心价值在于:即便模型文件触发了恶意代码,攻击者的活动范围也被限制在沙盒内部,无法读取宿主机上的浏览器凭证、SSH 密钥或业务数据。需要注意的是,沙盒本身也存在「逃逸」漏洞,因此容器镜像和宿主机内核同样需要保持更新;沙盒是降低风险的有效手段,而非绝对防线。AWS Bedrock 是亚马逊云提供的托管大模型 API 服务,用户通过 API 调用 Llama、Mistral 等开放权重模型,无需自行管理运行环境,安全补丁由云厂商负责,适合希望兼顾模型灵活性与安全合规的企业场景。
写在最后
本地大模型带来数据主权与免费自由的同时,也隐藏着被普遍低估的安全隐患。核心结论并不复杂:模型文件不是无害的数字,运行器可能存在漏洞,来源不明的模型可能成为攻击入口。无论选择本地隔离沙盒,还是交给可信云平台,把「安全边界」建立起来,才是使用开源与开放权重模型的正确姿势。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。